Come ChatLab sfrutta la tecnologia RAG?


Come ChatLab sfrutta la tecnologia RAG?
In ChatLab creiamo chatbot intelligenti che rivoluzionano le interazioni online. Il motore principale alla base delle loro capacità è una tecnologia innovativa chiamata Retrieval-Augmented Generation (RAG). Questa costituisce le fondamenta del nostro sistema, consentendoci di offrire soluzioni che vanno ben oltre le conversazioni standard.
Nel mondo dei chatbot esistono due metodi principali di addestramento. Comprendere i diversi tipi di chatbot ti aiuta a capire in cosa differiscono questi approcci di addestramento. Il primo metodo prevede un addestramento intensivo di reti neurali complesse - un processo articolato, lungo e costoso. Il secondo approccio, che impieghiamo con successo in ChatLab, è la tecnologia RAG. Non solo è più semplice, più economica e più rapida da implementare, ma garantisce anche ai nostri chatbot l'accesso a fonti esterne illimitate di informazioni - come i tuoi file personali. Questo ci consente di generare risposte estremamente precise, attente al contesto e personalizzate.
Ti invitiamo a continuare a leggere per approfondire come la tecnologia RAG alimenta ChatLab!
Cos'è esattamente la RAG?
Per comprendere il funzionamento del nostro sistema, vale la pena esaminare più da vicino la Retrieval-Augmented Generation. Anche se interagire con un chatbot può sembrare intuitivo dal punto di vista dell'utente, comprendere i meccanismi dietro il suo funzionamento ti permette di apprezzarne appieno il potenziale.
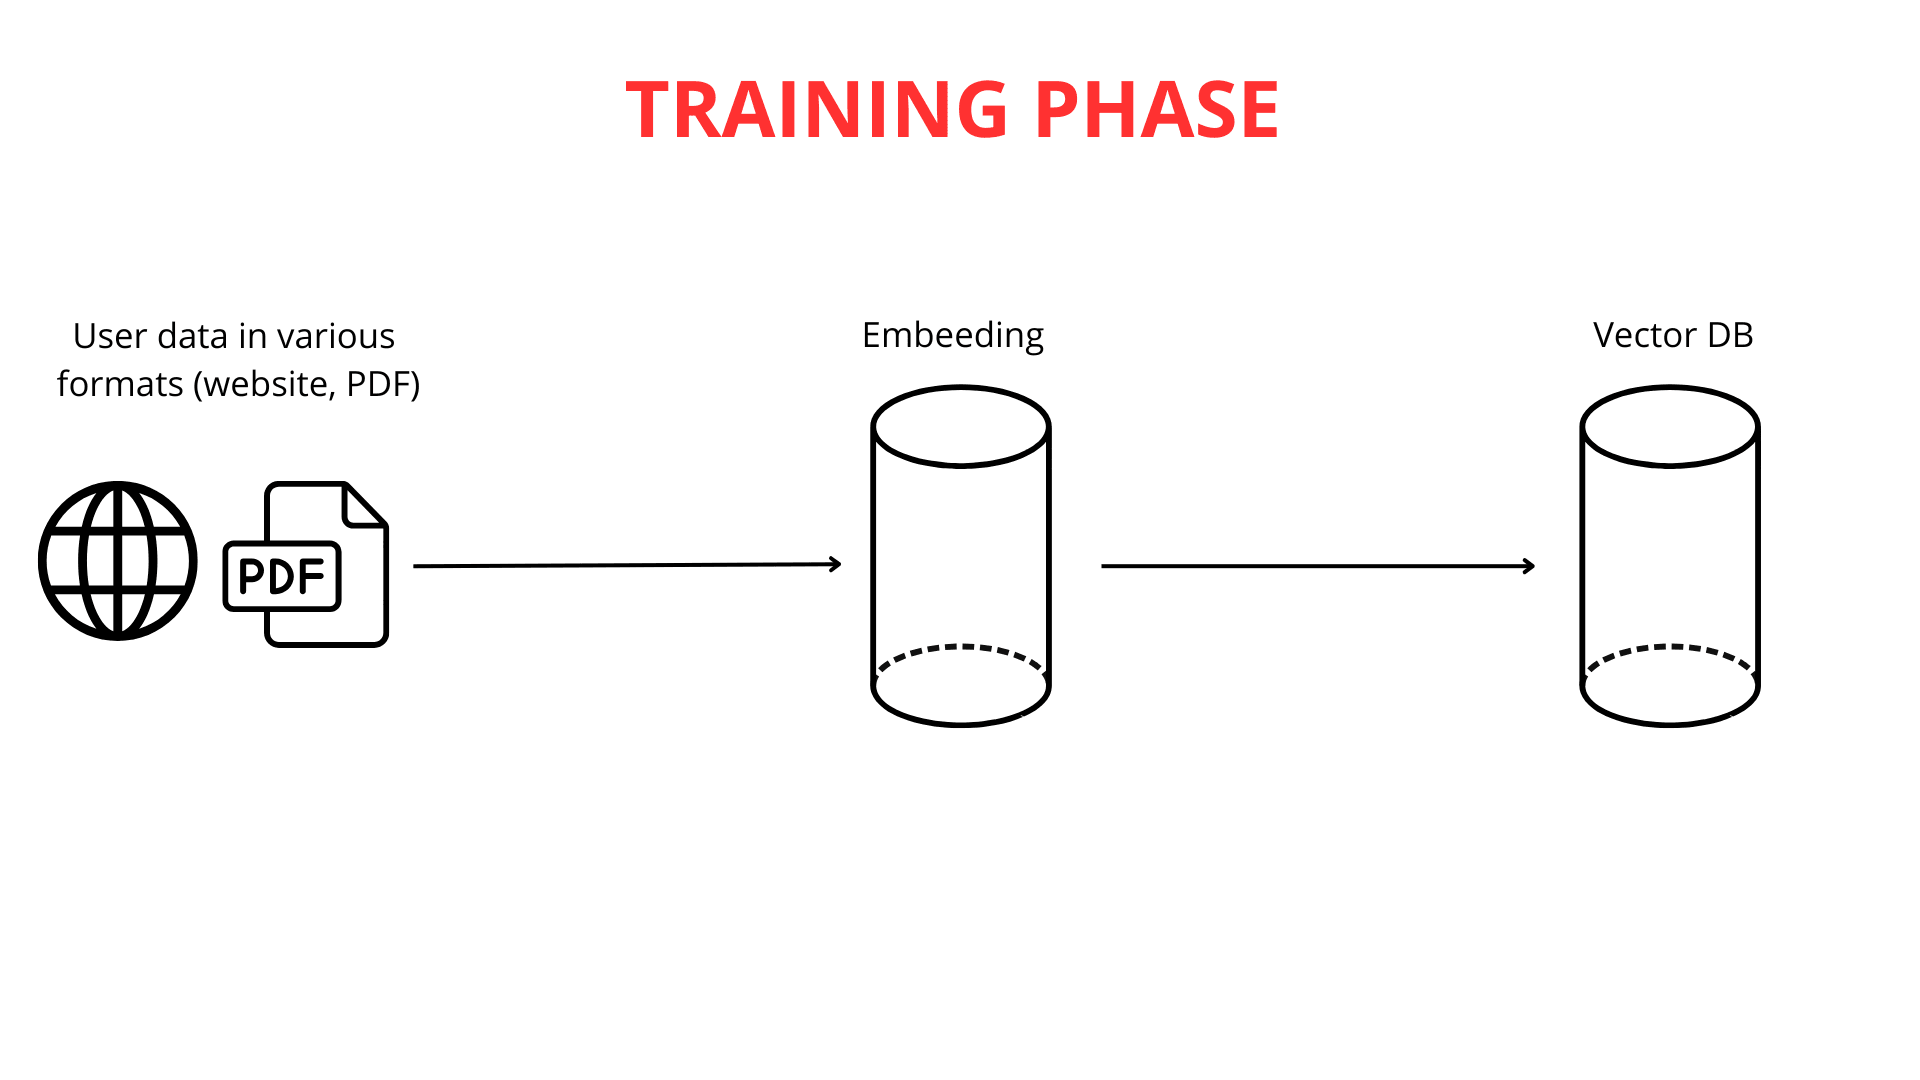
Costruire un chatbot intelligente è un processo che affonda le radici in molteplici discipline scientifiche. Il primo passo, nonché il più cruciale, consiste nel fornire dati al chatbot. In ChatLab lo rendiamo possibile in diversi modi pratici: caricando i contenuti del sito web, una documentazione approfondita o persino i tuoi file PDF. Le possibilità di personalizzare la knowledge base in base alle tue esigenze sono praticamente illimitate.
La fase successiva prevede la scomposizione dei testi lunghi in blocchi più piccoli (fino a 600 token ciascuno), facilitando l'elaborazione efficiente delle informazioni da parte del sistema. Una volta caricati e segmentati i dati, inizia il processo di mappatura vettoriale.
È fondamentale sottolineare che la mappatura da testo a vettore è critica per il funzionamento della RAG. I potenti motori dei modelli linguistici di grandi dimensioni (LLM) sono responsabili della generazione di queste rappresentazioni vettoriali.
Il ruolo della mappatura vettoriale nella comprensione del testo
La vettorializzazione del testo consiste essenzialmente nel convertire le parole in elenchi di numeri - strutturati in modo tale che le parole con significati simili ricevano rappresentazioni numeriche (vettori) simili. Ciò consente al nostro chatbot di "comprendere" le relazioni tra diverse sequenze di parole. Ad esempio, le parole "grande" ed "enorme" verrebbero trasformate in elenchi numerici molto simili, mentre "grande" e "formica" riceverebbero rappresentazioni completamente diverse.
Analizzando queste somiglianze e differenze numeriche, il chatbot può dedurre che "gatto" e "cane" sono più strettamente correlati rispetto a "gatto" e "verde".
Una volta generati i vettori, queste rappresentazioni numeriche della conoscenza vengono archiviate in un database vettoriale insieme al contenuto originale. Il database vettoriale funge da catalogo avanzato della conoscenza vettorializzata, ottimizzato per il recupero rapido dei significati correlati.
Il database vettoriale: una biblioteca intelligente della conoscenza
Per comprendere meglio come funziona un database vettoriale, usiamo l'analogia di una biblioteca dotata di un sistema di ricerca intelligente. Ogni "libro" (frammento di testo) è "etichettato" con un vettore univoco (una sequenza di numeri). Questo codice contiene diversi numeri che rappresentano l'autore, lo stile e l'argomento del libro. Due libri su argomenti simili avranno codici molto simili.
In questa "biblioteca", i libri sono posizionati su "scaffali" in uno spazio multidimensionale in base ai loro codici. I libri con codici simili sono raggruppati vicini - proprio come libri della stessa categoria, ma ulteriormente organizzati in base a sottili analogie di contenuto. Quando poni una domanda (ad es. "Qual è la ricetta della torta al cioccolato?"), questa viene convertita in un "codice" analogo. Il sistema di ricerca intelligente nel database vettoriale scansiona gli "scaffali" (frammenti di testo) alla ricerca dei codici che corrispondono più da vicino al codice della tua richiesta.
L'algoritmo individua rapidamente i "libri" (frammenti) che hanno maggiori probabilità di contenere la risposta. Invece di setacciare l'intera "biblioteca", il chatbot individua istantaneamente le porzioni di conoscenza più rilevanti a livello semantico. Ciò garantisce risposte più rapide, accurate e mirate al contesto.
Cosa succede quando fai una domanda?
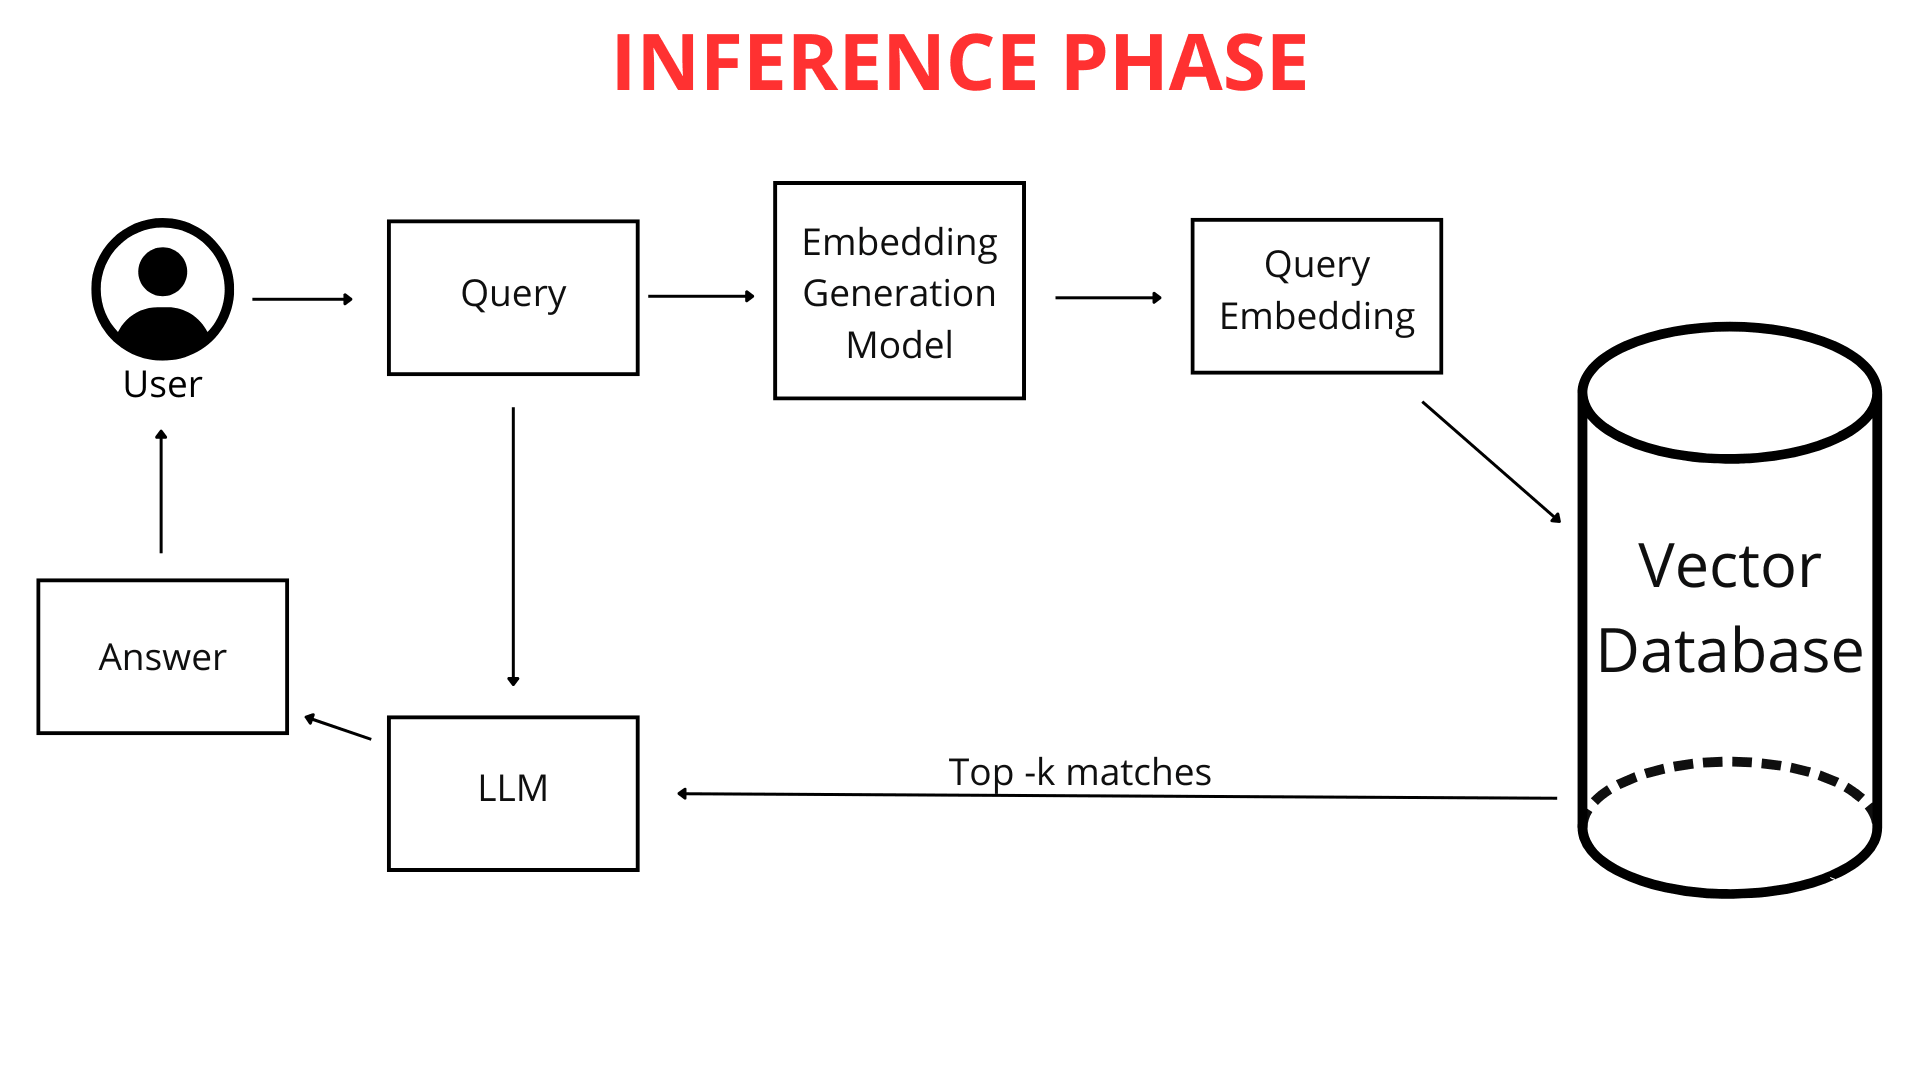
Quando tu, come utente, digiti una domanda nel chatbot (ad es. "Che tempo fa a Cracovia domani?"), questa non viene confrontata immediatamente con la conoscenza del chatbot sotto forma di testo grezzo. Innanzitutto, la domanda viene mappata in un vettore numerico. Poiché sia la tua domanda sia l'intera knowledge base del chatbot sono rappresentate nello stesso formato - come mappe vettoriali (elenchi di numeri) - il chatbot può confrontarle in modo efficiente. Individua i frammenti della sua conoscenza più strettamente correlati al vettore della tua query, consentendogli di generare la migliore risposta possibile.
La RAG entra in azione
È qui che la tecnologia RAG gioca un ruolo cruciale. Il sistema RAG analizza la rappresentazione vettoriale della tua query e la utilizza per cercare nel database vettoriale gli elenchi numerici più simili ad essa (i più vicini nello spazio multidimensionale). Questi vettori più simili rimandano ai frammenti dei file originali più rilevanti per la tua domanda.
La RAG agisce come un "ponte" intelligente tra la tua query e la vasta knowledge base del chatbot. Consente il recupero dinamico solo delle informazioni più necessarie affinché l'LLM (Large Language Model) possa formulare una risposta. Un LLM, in termini semplici, è un algoritmo avanzato con un dataset addestrato su enormi quantità di testo, capace di comprendere e generare il linguaggio naturale. Per saperne di più su questa tecnologia, scopri come funziona davvero ChatGPT. Gli LLM possono rispondere alle domande e persino creare contenuti eterogenei.
Senza RAG, un LLM dovrebbe fare affidamento esclusivamente sulle sue conoscenze integrate, che potrebbero non includere dettagli specifici dei tuoi file o potrebbero essere obsolete. Grazie alla RAG, il chatbot acquisisce la capacità di attingere a conoscenze esterne aggiuntive proprio nel momento in cui poni una domanda. Questa conoscenza aggiornata proviene direttamente dai tuoi file e dalle tue pagine web caricate, opportunamente elaborate.
La differenza tra un chatbot con e senza RAG
La differenza principale risiede nel modo in cui si accede alla conoscenza.
Conoscenza addestrata (senza RAG): è la conoscenza "integrata" dell'LLM, acquisita durante un addestramento intensivo su vasti dataset prima della tua interazione con ChatLab. Se chiedi informazioni su qualcosa non presente in quei dati, il modello potrebbe semplicemente non conoscere la risposta.
Conoscenza dei tuoi file (utilizzata tramite RAG): è la tua conoscenza unica e specializzata che fornisci al chatbot. La RAG consente al chatbot di accedere dinamicamente a questa conoscenza quando risponde alle domande, combinandola con la sua conoscenza generale di addestramento per generare una risposta completa. Questo approccio alimenta la moderna IA conversazionale per l'assistenza clienti.
Un'analogia:
Immagina un LLM come uno studente incredibilmente intelligente che ha letto innumerevoli libri (dati di addestramento) e possiede una conoscenza generale impressionante. Ora, gli fornisci gli appunti delle tue lezioni e le tue dispense (i tuoi file). La RAG agisce come un sistema che consente a questo studente di controllare rapidamente i tuoi appunti quando risponde a una domanda, anziché affidarsi unicamente a ciò che ricorda da tutti quei libri. Questa integrazione garantisce risposte migliori, più precise e - cosa più importante - più aggiornate.
Grazie alla RAG, il chatbot può ampliare la sua conoscenza con i tuoi dati specifici e utilizzarli attivamente nelle interazioni. Non è limitato soltanto a ciò che ha appreso durante il suo addestramento iniziale.
Ecco perché la RAG è preziosa quando hai bisogno di un chatbot che risponda a domande sulle tue informazioni specifiche - dettagli che non sono disponibili pubblicamente o che sono troppo di nicchia per essere inclusi nei dati di addestramento generali di un LLM.
Se la tua domanda è: "Dove posso trovare libri sullo spazio?", prima che il "bibliotecario" (chatbot) inizi a "cercare tra gli scaffali", per prima cosa "traduce" la tua domanda nel "linguaggio degli scaffali" - individuando la categoria di libri appropriata. Creare una mappa vettoriale della tua domanda equivale a catalogare la tua query in categorie che il chatbot comprende e a cui può accedere tramite il database vettoriale.
La fase di addestramento e utilizzo della conoscenza
Come spiegato in precedenza, la tua domanda viene convertita in un elenco di numeri che ne rappresenta il significato. Il chatbot cerca quindi nel database vettoriale i vettori più simili che rappresentano frammenti di conoscenza. Più le rappresentazioni vettoriali sono vicine, maggiore è la somiglianza tra la tua domanda e quei frammenti di conoscenza.
Il chatbot seleziona i frammenti più pertinenti della sua conoscenza precedentemente elaborata - quelli i cui vettori sono più vicini alla mappa vettoriale della tua domanda. È importante notare che, quando analizza la tua query, ChatLab non considera solo la domanda in sé, ma anche il contesto dell'intera conversazione fino a quel momento. Ciò consente al sistema RAG di selezionare con maggiore precisione le migliori informazioni dalle fonti di conoscenza collegate.
Ad esempio, se prima chiedi degli "ultimi modelli di telefono" e poi aggiungi "Hanno una buona fotocamera?", il chatbot - ricordando il contesto della conversazione - comprende che ti stai ancora riferendo a quegli specifici telefoni.
I frammenti di conoscenza selezionati vengono combinati con la tua domanda originale e con le istruzioni della sezione "Role & Behavior". Queste istruzioni, note anche come prompt, sono il nostro insieme personalizzato di linee guida per il chatbot. Se desideriamo che il chatbot aggiunga sempre un link alla fonte alla fine della sua risposta o saluti gli utenti in un modo specifico, lo includiamo nel prompt.
Questo crea una query arricchita (augmented query), che viene poi passata al "cervello" del chatbot - il modello linguistico di grandi dimensioni (LLM) di OpenAI, Google o altri provider.
Il modello linguistico analizza questo insieme articolato di informazioni: il prompt, la cronologia della conversazione e la conoscenza recuperata per la query dell'utente. Inoltre, l'LLM fa leva sulla sua conoscenza generale del mondo per generare una risposta. Ciò consente di creare esperienze cliente altamente personalizzate con l'IA. Infine, la risposta rifinita e perfezionata viene mostrata nell'interfaccia chiara di ChatLab.
Riepilogo
In questo articolo abbiamo esplorato l'architettura del sistema RAG nel funzionamento dei chatbot - dall'immissione dei dati alla generazione delle risposte. La RAG è una componente fondamentale dei moderni sistemi conversazionali, che consente un utilizzo efficiente della conoscenza esterna. Aziende come ChatLab integrano attivamente questa tecnologia rivoluzionaria nei propri prodotti, offrendo ai clienti capacità di interazione avanzate e intelligenti.
Sebbene il sistema RAG presenti una certa complessità tecnica, il suo impatto sui testi generati dall'IA è innegabile. Il fatto che venga utilizzato con successo da importanti aziende tecnologiche come Google, Microsoft e Amazon sottolinea il suo ruolo centrale nell'evoluzione dinamica dell'intelligenza artificiale.
Sei pronto a provare la tecnologia RAG in prima persona? Scopri le funzionalità di ChatLab o impara come creare il tuo chatbot IA basato su questa tecnologia.


