Wie ChatLab die RAG-Technologie nutzt


Wie ChatLab die RAG-Technologie nutzt
Bei ChatLab entwickeln wir intelligente Chatbots, die Online-Interaktionen revolutionieren. Der entscheidende Treiber hinter ihren Fähigkeiten ist eine innovative Technologie namens Retrieval-Augmented Generation (RAG). Sie bildet das Fundament unseres Systems und ermöglicht es uns, Lösungen anzubieten, die weit über Standardkonversationen hinausgehen.
In der Welt der Chatbots gibt es zwei grundlegende Trainingsmethoden. Ein Blick auf die verschiedenen Arten von Chatbots hilft dabei, die Unterschiede zwischen diesen Trainingsansätzen zu verstehen. Die erste Methode basiert auf dem intensiven Trainieren komplexer neuronaler Netze - ein Prozess, der aufwendig, zeitintensiv und teuer ist. Der zweite Ansatz, den wir bei ChatLab erfolgreich einsetzen, ist RAG. Er ist nicht nur unkomplizierter, kostengünstiger und schneller einsatzbereit, sondern verschafft unseren Chatbots auch Zugang zu unbegrenzten externen Informationsquellen - wie Ihren eigenen Dateien. Dadurch können wir Antworten liefern, die hochpräzise, kontextbezogen und individuell abgestimmt sind.
Erfahren Sie in den folgenden Abschnitten mehr darüber, wie die RAG-Technologie ChatLab antreibt!
Was genau ist RAG?
Um die Funktionsweise unseres Systems zu verstehen, lohnt sich ein genauerer Blick auf Retrieval-Augmented Generation. Auch wenn die Interaktion mit einem Chatbot für den Nutzer völlig intuitiv wirkt, lässt sich sein Potenzial erst dann voll ausschöpfen, wenn man die Mechanismen dahinter begreift.
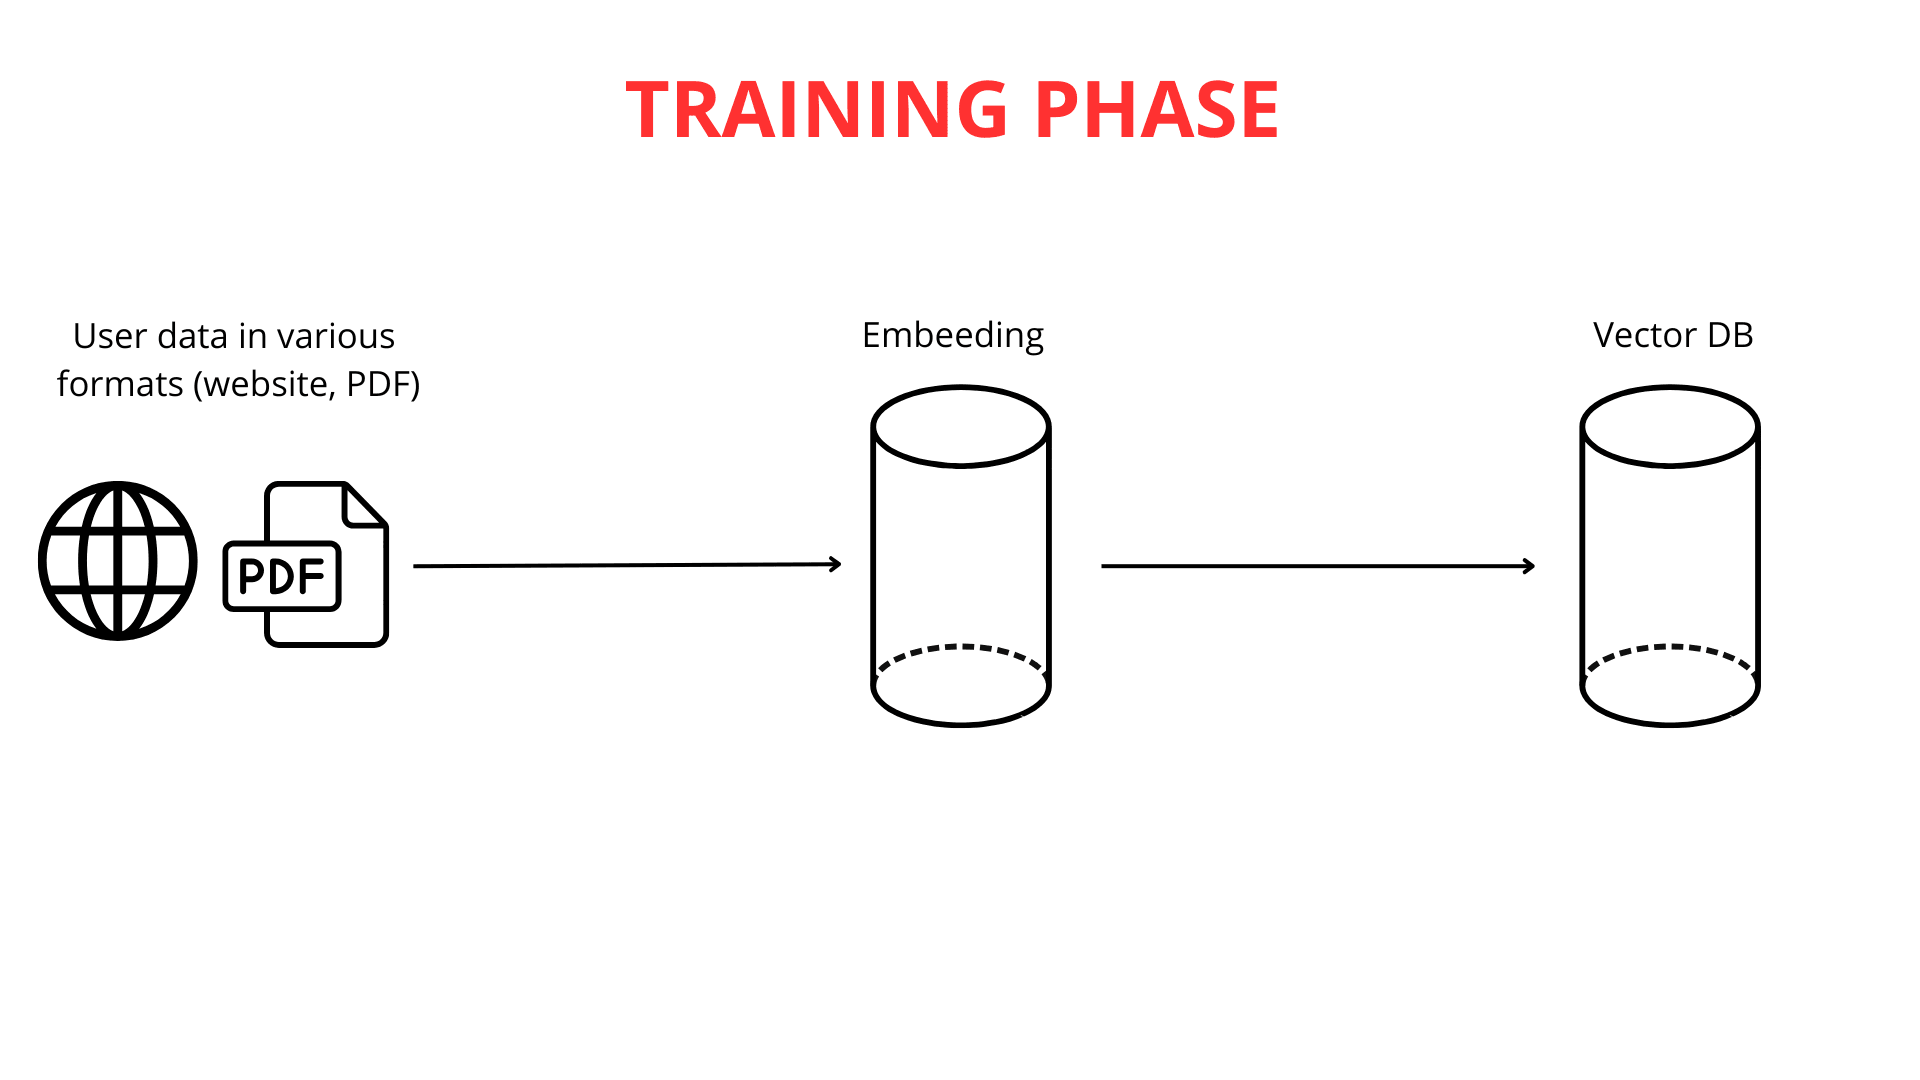
Die Entwicklung eines intelligenten Chatbots stützt sich auf Erkenntnisse verschiedener wissenschaftlicher Disziplinen. Der erste und entscheidende Schritt besteht darin, den Chatbot mit Daten zu füttern. Bei ChatLab geschieht dies auf verschiedenen Wegen: durch den Upload von Website-Inhalten, umfangreicher Dokumentationen oder Ihrer eigenen PDF-Dateien. Den Möglichkeiten, die Wissensbasis an Ihre Anforderungen anzupassen, sind dabei praktisch keine Grenzen gesetzt.
Im nächsten Schritt werden längere Texte in kleinere Abschnitte (bis zu 600 Tokens pro Abschnitt) unterteilt, damit das System die Informationen effizient verarbeiten kann. Sobald die Daten hochgeladen und segmentiert sind, beginnt das Vektor-Mapping.
Dabei ist das Text-zu-Vektor-Mapping ein unverzichtbarer Bestandteil von RAG. Leistungsstarke LLM-Engines (Large Language Models) übernehmen die Erstellung dieser Vektordarstellungen.
Die Rolle des Vektor-Mappings beim Textverständnis
Bei der Vektorisierung von Texten werden Wörter im Wesentlichen in Zahlenlisten umgewandelt. Diese sind so aufgebaut, dass Begriffe mit ähnlicher Bedeutung auch ähnliche numerische Darstellungen (Vektoren) erhalten. Auf diese Weise kann unser Chatbot Beziehungen zwischen verschiedenen Wortfolgen erfassen. Die Wörter „groß“ und „riesig“ erhalten beispielsweise sehr ähnliche Zahlenlisten, während „groß“ und „Ameise“ völlig unterschiedliche Vektoren zugewiesen bekommen.
Durch den Vergleich dieser Zahlenwerte erkennt der Chatbot unter anderem, dass „Katze“ und „Hund“ inhaltlich näher beieinanderliegen als „Katze“ und „grün“.
Nach ihrer Erstellung werden diese numerischen Repräsentationen des Wissens zusammen mit dem Originalinhalt in einer Vektordatenbank gespeichert. Die Vektordatenbank fungiert als moderner Katalog für vektorisiertes Wissen, der für den blitzschnellen Abruf verwandter Bedeutungen optimiert ist.
Die Vektordatenbank: Eine intelligente Wissensbibliothek
Die Funktionsweise einer Vektordatenbank lässt sich gut mit einer Bibliothek mit intelligentem Suchsystem vergleichen: Jedes „Buch“ (jeder Textabschnitt) wird mit einem eindeutigen Vektor (einer Zahlenfolge) versehen. Dieser Code enthält verschiedene Zahlenwerte, die Merkmale wie Autor, Stil und Thema des Buchs abbilden. Zwei Bücher zu ähnlichen Themen erhalten demnach sehr ähnliche Codes.
In dieser „Bibliothek“ werden die Bücher anhand ihrer Codes auf „Regalen“ in einem mehrdimensionalen Raum platziert. Bücher mit ähnlichen Codes stehen dicht beieinander - vergleichbar mit Werken derselben Kategorie, die zusätzlich nach feinen inhaltlichen Nuancen sortiert sind. Wenn Sie eine Frage stellen (z. B. „Wie lautet das Rezept für Schokoladenkuchen?“), wird diese ebenfalls in einen solchen „Code“ umgewandelt. Das intelligente Suchsystem der Vektordatenbank scannt daraufhin die „Regale“ (Textabschnitte) nach den Codes, die dem Code Ihrer Anfrage am nächsten kommen.
Der Algorithmus ermittelt rasch die „Bücher“ (Abschnitte), die mit größter Wahrscheinlichkeit die Antwort enthalten. Anstatt die gesamte Bibliothek von Grund auf zu durchsuchen, lokalisiert der Chatbot zielgenau die semantisch relevantesten Wissenseinheiten. Das sorgt für schnellere, präzisere und treffsichere Antworten.
Was passiert, wenn Sie eine Frage stellen?
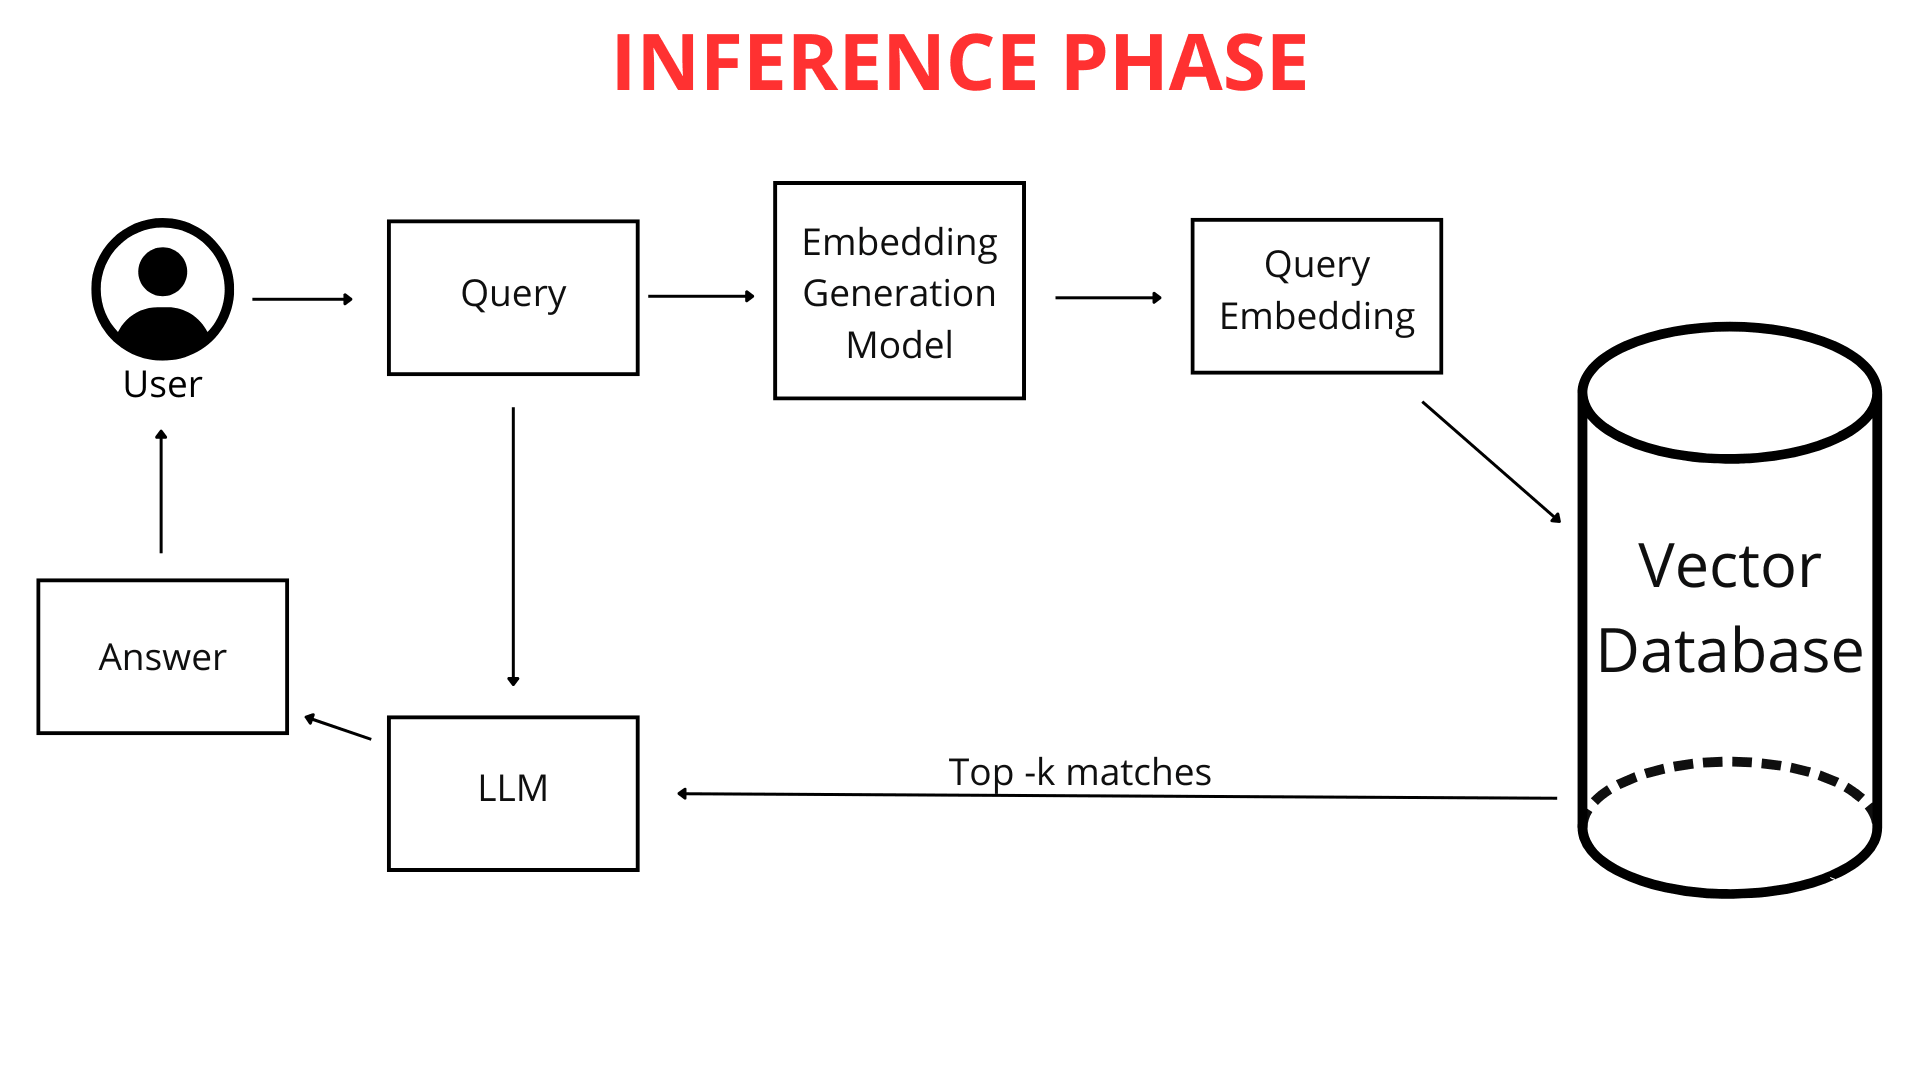
Geben Sie als Nutzer eine Frage in den Chatbot ein (z. B. „Wie wird das Wetter morgen in Krakau?“), wird diese nicht direkt als reiner Text mit dem Wissensbestand abgeglichen. Zunächst wird die Frage in einen numerischen Vektor umgewandelt. Da sowohl Ihre Eingabe als auch die gesamte Wissensbasis des Chatbots im selben Format vorliegen - als Vektormappings (Zahlenlisten) -, kann das System beide Einheiten äußerst effizient abgleichen. Es ermittelt die Abschnitte seiner Wissensbasis, die dem Vektor Ihrer Anfrage am ähnlichsten sind, und formuliert daraufhin die bestmögliche Antwort.
RAG in der Praxis
An dieser Stelle entfaltet die RAG-Technologie ihre zentrale Funktion. Das RAG-System analysiert die Vektordarstellung Ihrer Frage und durchsucht die Vektordatenbank nach den Zahlenlisten, die ihr am stärksten ähneln (also im mehrdimensionalen Raum den geringsten Abstand aufweisen). Diese ähnlichsten Vektoren verweisen direkt auf die Abschnitte der Originaldateien, die für Ihre Frage die höchste Relevanz besitzen.
RAG fungiert als intelligentes Bindeglied zwischen Ihrer Anfrage und der umfassenden Wissensbasis des Chatbots. Es stellt dynamisch genau die Informationen bereit, die das Large Language Model (LLM) benötigt, um die Antwort zu formulieren. Ein LLM ist vereinfacht gesagt ein hochentwickelter Algorithmus, der mit riesigen Textmengen trainiert wurde und natürliche Sprache verstehen sowie generieren kann. Wenn Sie mehr über diese Technologie erfahren möchten, lesen Sie unseren Artikel darüber, wie ChatGPT tatsächlich funktioniert. LLMs können Fragen beantworten und unterschiedlichste Inhalte erstellen.
Ohne RAG müsste ein LLM ausschließlich auf sein vortrainiertes Wissen zurückgreifen. Spezifische Details aus Ihren Dokumenten stünden ihm nicht zur Verfügung oder Daten wären schlicht veraltet. Dank RAG kann der Chatbot genau in dem Moment, in dem eine Frage gestellt wird, gezielt auf zusätzliches externes Wissen zugreifen. Diese aktuellen Informationen stammen direkt aus Ihren hochgeladenen und verarbeiteten Dateien und Webseiten.
Der Unterschied zwischen einem Chatbot mit und ohne RAG
Der entscheidende Unterschied liegt im Zugriff auf das benötigte Wissen.
Angelerntes Wissen (ohne RAG): Hierbei handelt es sich um das fest integrierte Wissen des LLM, das vor Ihrer Interaktion mit ChatLab in intensiven Trainingsphasen anhand riesiger Datenbestände aufgebaut wurde. Wird nach Inhalten gefragt, die darin nicht vorkommen, kann das Modell die Antwort schlichtweg nicht kennen.
Wissen aus Ihren Dokumenten (genutzt über RAG): Dies sind Ihre individuellen Fachdaten, die Sie dem Chatbot bereitstellen. Durch RAG kann das System bei der Beantwortung von Fragen flexibel auf diese Datenbasis zugreifen und sie mit seinem allgemeinen Sprachwissen verknüpfen. Dieser Ansatz treibt moderne Conversational AI für den Kundenservice an.
Ein anschaulicher Vergleich:
Stellen Sie sich das LLM wie einen hochbegabten Studenten vor, der zahllose Fachbücher (Trainingsdaten) gelesen hat und über ein beachtliches Allgemeinwissen verfügt. Wenn Sie ihm nun Ihre persönlichen Vorlesungsmitschriften und Dokumente (Ihre Dateien) aushändigen, funktioniert RAG wie ein System, das ihm erlaubt, diese Notizen bei einer Frage gezielt aufzuschlagen, anstatt sich rein auf sein Gedächtnis zu verlassen. Das Ergebnis sind fundiertere, exaktere und vor allem aktuelle Antworten.
Mit RAG lässt sich das Wissen des Chatbots um Ihre firmeneigenen Daten ergänzen und in Live-Gesprächen einsetzen. Er bleibt nicht auf den Stand seines ursprünglichen Trainings beschränkt.
Aus diesem Grund ist RAG besonders dann unverzichtbar, wenn ein Chatbot Auskunft zu unternehmensspezifischen Inhalten geben soll - also zu Informationen, die nicht öffentlich zugänglich oder zu speziell für die allgemeinen Trainingsdaten eines LLM sind.
Fragen Sie beispielsweise: „Wo finde ich Bücher über den Weltraum?“, übersetzt der Chatbot die Frage zunächst in ein passendes Schema und ordnet sie der entsprechenden Buchkategorie zu, bevor die Suche in den Inhalten startet. Das Vektormapping Ihrer Anfrage entspricht dem Einordnen in Kategorien, die der Chatbot versteht und über die Vektordatenbank gezielt ansteuern kann.
Die Trainings- und Wissensnutzungsphase
Wie beschrieben wird Ihre Frage in eine Zahlenliste umgewandelt, die ihre inhaltliche Bedeutung widerspiegelt. Anschließend gleicht der Chatbot diesen Vektor mit den Wissensfragmenten in der Vektordatenbank ab. Je näher die Vektoren beieinanderliegen, desto größer ist die inhaltliche Übereinstimmung.
Der Chatbot wählt daraufhin die passendsten Abschnitte aus den vorverarbeiteten Daten aus - jene, deren Vektoren Ihrer Frage am nächsten kommen. Bei der Analyse berücksichtigt ChatLab nicht nur die einzelne Frage, sondern den Kontext der gesamten bisherigen Konversation. So kann das RAG-System noch zielgerichteter die passenden Daten aus den angebundenen Wissensquellen filtern.
Wenn Sie sich beispielsweise zuerst nach den „neuesten Smartphone-Modellen“ erkundigen und danach fragen: „Haben sie eine gute Kamera?“, versteht der Chatbot anhand des bisherigen Verlaufs, dass sich Ihre zweite Frage weiterhin auf diese konkreten Modelle bezieht.
Die ausgewählten Textbausteine werden mit Ihrer ursprünglichen Frage sowie den Vorgaben aus dem Bereich „Role & Behavior“ zusammengeführt. Diese Anweisungen, auch als Prompt bezeichnet, bilden den individuellen Handlungsrahmen für den Chatbot. Wenn der Chatbot beispielsweise am Ende jeder Antwort einen Quellenlink ausgeben oder Nutzer auf eine bestimmte Art begrüßen soll, wird dies im Prompt definiert.
Daraus entsteht eine angereicherte Anfrage (Augmented Query), die an das LLM weitergeleitet wird - etwa von OpenAI, Google oder anderen Anbietern.
Das Sprachmodell wertet diesen Informationsmix aus: den Prompt, den Konversationsverlauf und die für die Anfrage abgerufenen Inhalte. Zusätzlich nutzt das LLM sein allgemeines Sprach- und Weltwissen, um die Antwort zu formulieren. So lassen sich personalisierte Kundenerlebnisse mit KI umsetzen. Das fertige Ergebnis wird dem Nutzer anschließend direkt in der ChatLab-Oberfläche angezeigt.
Fazit
In diesem Beitrag haben wir den Weg der RAG-Technologie in Chatbots nachgezeichnet - von der Datenaufnahme bis hin zur fertigen Antwort. RAG ist ein essenzieller Baustein moderner dialogorientierter Systeme, der die flexible Einbindung externer Wissensquellen überhaupt erst ermöglicht. Unternehmen wie ChatLab binden diese Technologie direkt in ihre Lösungen ein, um anspruchsvolle und durchdachte Interaktionen für Kunden bereitzustellen.
Auch wenn die technische Umsetzung von RAG anspruchsvoll ist, sind die Vorteile für die Qualität KI-generierter Texte unübersehbar. Dass Branchengrößen wie Google, Microsoft und Amazon auf dieses Konzept setzen, unterstreicht seine zentrale Bedeutung für die Weiterentwicklung künstlicher Intelligenz.
Möchten Sie RAG in Aktion erleben? Entdecken Sie die Funktionen von ChatLab oder erfahren Sie, wie Sie Ihren eigenen KI-Chatbot erstellen.


