Kā ChatLab izmanto RAG tehnoloģiju?


Kā ChatLab izmanto RAG tehnoloģiju?
Uzņēmumā ChatLab mēs radām viedus tērzēšanas robotus, kas rada revolūciju tiešsaistes mijiedarbībā. Galvenais dzinējspēks aiz to spējām ir inovatīva tehnoloģija, ko sauc par izgūšanas papildināto ģenerēšanu (RAG - Retrieval-Augmented Generation). Tā veido mūsu sistēmas pamatu, ļaujot mums piedāvāt risinājumus, kas sniedzas daudz tālāk par standarta sarunām.
Tērzēšanas robotu pasaulē pastāv divas galvenās apmācības metodes. Izprotot dažādos tērzēšanas robotu veidus, var labāk redzēt, kā šīs apmācības pieejas atšķiras. Pirmā metode ietver sarežģītu neironu tīklu intensīvu apmācību - šis process ir sarežģīts, laikietilpīgs un dārgs. Otrā pieeja, ko mēs veiksmīgi izmantojam ChatLab, ir RAG. Tā ir ne tikai vienkāršāka, rentablāka un ātrāk ieviešama, bet arī sniedz mūsu tērzēšanas robotiem piekļuvi neierobežotiem ārējiem informācijas avotiem - piemēram, Jūsu pašu failiem. Tas ļauj mums ģenerēt atbildes, kas ir ļoti precīzas, kontekstuāli atbilstošas un personalizētas.
Aicinām lasīt tālāk un uzzināt vairāk par to, kā RAG tehnoloģija darbina ChatLab!
Kas īsti ir RAG?
Lai saprastu, kā darbojas mūsu sistēma, ir vērts tuvāk apskatīt izgūšanas papildināto ģenerēšanu. Lai gan mijiedarbība ar tērzēšanas robotu no lietotāja viedokļa var šķist intuitīva, tā darbības mehānismu izpratne ļauj pilnībā novērtēt tā potenciālu.
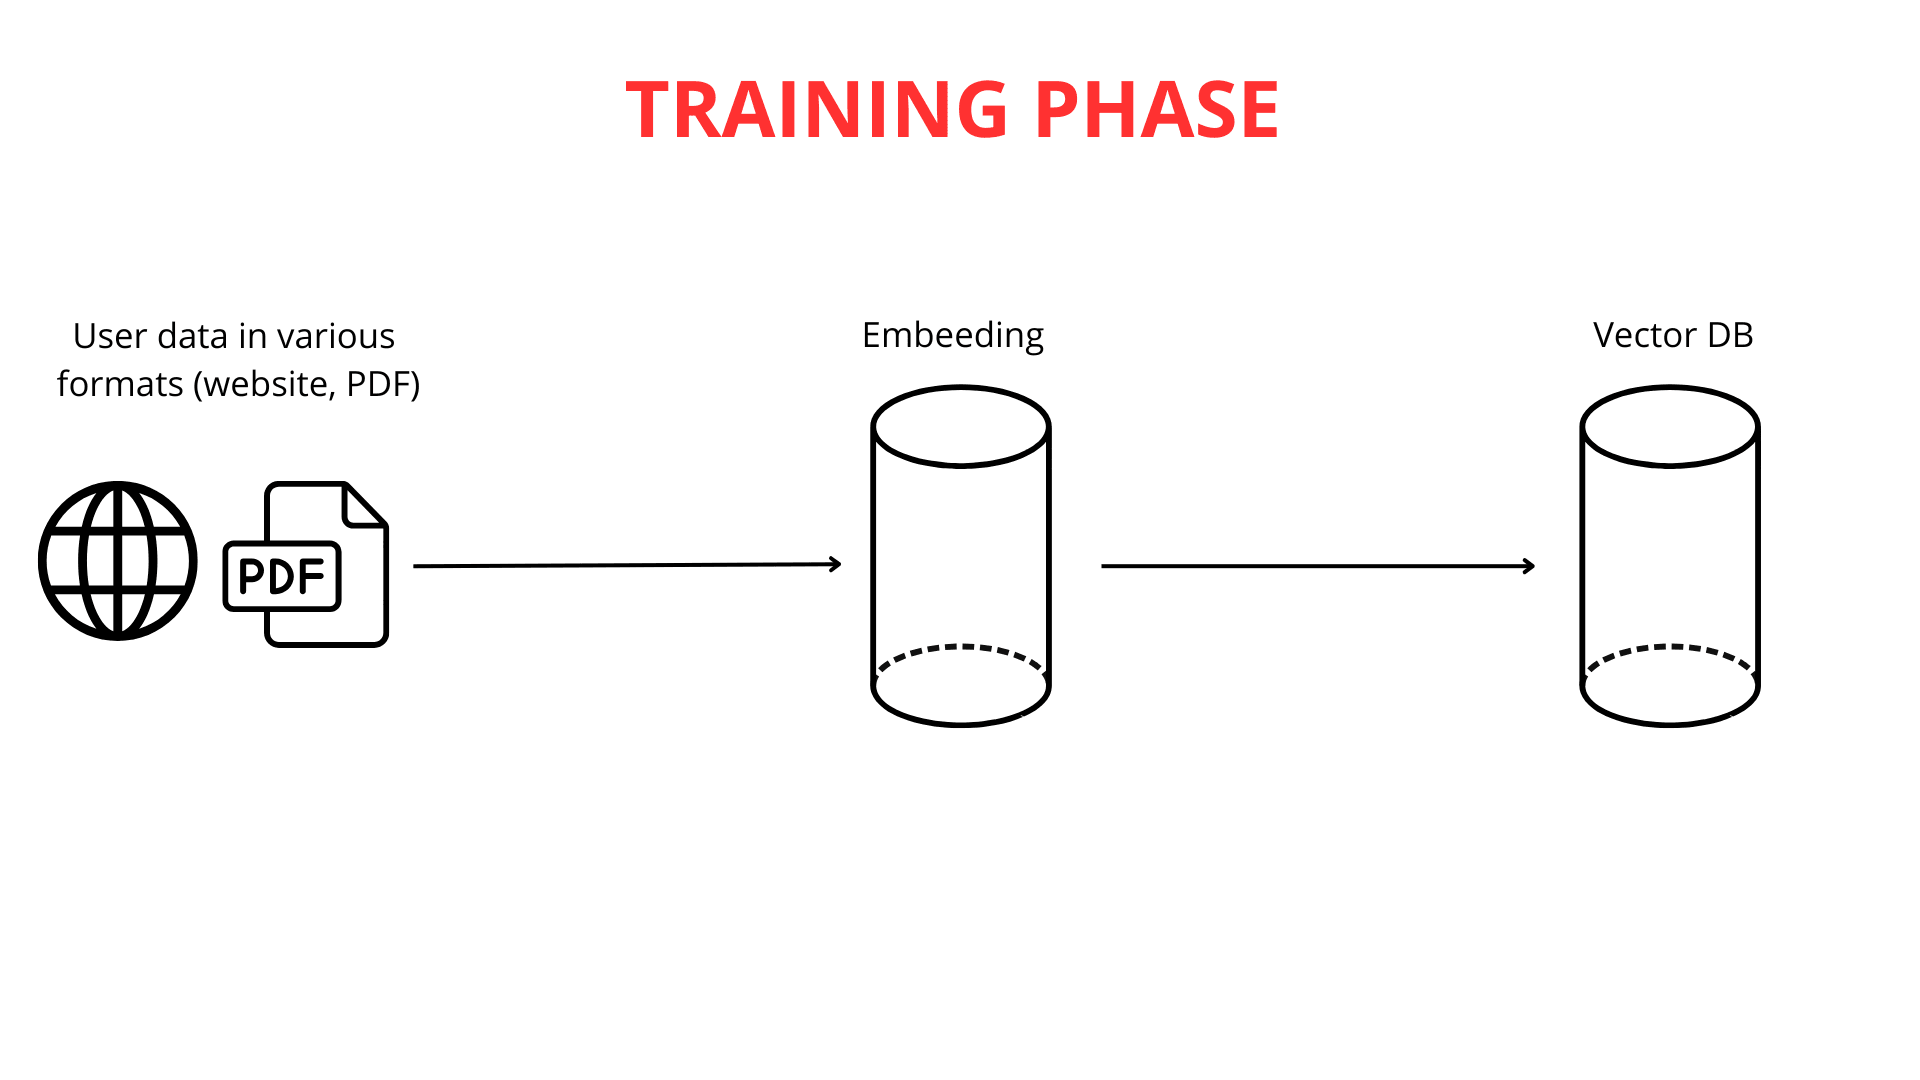
Vieda tērzēšanas robota izveide ir process, kas balstās vairāku zinātnes nozaru atziņās. Pirmais un svarīgākais solis ir tērzēšanas robota barošana ar datiem. ChatLab to nodrošina vairākos ērtos veidos: augšupielādējot vietnes saturu, plašu dokumentāciju vai pat Jūsu personīgos PDF failus. Iespējas pielāgot zināšanu bāzi Jūsu vajadzībām ir praktiski neierobežotas.
Nākamais posms ietver garu tekstu sadalīšanu mazākos fragmentos (katrs līdz 600 marķieriem jeb tokeniem), atvieglojot sistēmai efektīvu informācijas apstrādi. Kad dati ir augšupielādēti un segmentēti, sākas vektoru kartēšanas process.
Ir svarīgi uzsvērt, ka teksta kartēšana vektoros ir izšķiroša RAG funkcionalitātei. Par šo vektoru reprezentāciju ģenerēšanu atbild jaudīgi lielo valodas modeļu (LLM) dzinēji.
Vektoru kartēšanas loma teksta izpratnē
Teksta vektorizācija būtībā ir vārdu pārvēršana skaitļu sarakstos - veidota tā, lai vārdi ar līdzīgu nozīmi saņemtu līdzīgas skaitliskās reprezentācijas (vektorus). Tas ļauj mūsu tērzēšanas robotam "saprast" attiecības starp dažādām vārdu virknēm. Piemēram, vārdi "liels" un "milzīgs" tiktu pārveidoti ļoti līdzīgos skaitļu sarakstos, savukārt "liels" un "skudra" saņemtu pilnīgi atšķirīgus attēlojumus.
Analizējot šīs skaitliskās līdzības un atšķirības, tērzēšanas robots var secināt, ka "kaķis" un "suns" ir ciešāk saistīti nekā "kaķis" un "zaļš".
Kad vektori ir ģenerēti, šīs skaitliskās zināšanu reprezentācijas kopā ar sākotnējo saturu tiek saglabātas vektoru datubāzē. Vektoru datubāze kalpo kā uzlabots vektorizēto zināšanu katalogs, kas ir optimizēts ātrai saistīto nozīmju izgūšanai.
Vektoru datubāze: vieda zināšanu bibliotēka
Lai labāk saprastu, kā darbojas vektoru datubāze, izmantosim analoģiju ar bibliotēku, kurā ir vieda meklēšanas sistēma. Katra "grāmata" (teksta fragments) ir "marķēta" ar unikālu vektoru (skaitļu virkni). Šis kods satur vairākus skaitļus, kas raksturo grāmatas autoru, stilu un tēmu. Divām grāmatām par līdzīgām tēmām būs ļoti līdzīgi kodi.
Šajā "bibliotēkā" grāmatas tiek novietotas uz "plauktiem" daudzdimensiju telpā, pamatojoties uz to kodiem. Grāmatas ar līdzīgiem kodiem tiek grupētas tuvu viena otrai - līdzīgi kā grāmatas vienā kategorijā, taču vēl papildus sakārtotas pēc smalkām satura līdzībām. Kad Jūs uzdodat jautājumu (piemēram, "Kāda ir šokolādes kūkas recepte?"), tas tiek pārvērsts šādā "kodā". Viedā meklēšanas sistēma vektoru datubāzē skenē "plauktus" (teksta fragmentus), meklējot kodus, kas visvairāk atbilst Jūsu vaicājuma kodam.
Algoritms ātri identificē "grāmatas" (fragmentus), kurās visdrīzāk ir atbilde. Tā vietā, lai pārmeklētu visu "bibliotēku", tērzēšanas robots uzreiz precīzi nosaka nozīmes ziņā atbilstošākās zināšanu vienības. Tas nodrošina ātrākas, precīzākas un uz kontekstu vērstas atbildes.
Kas notiek, kad uzdodat jautājumu?
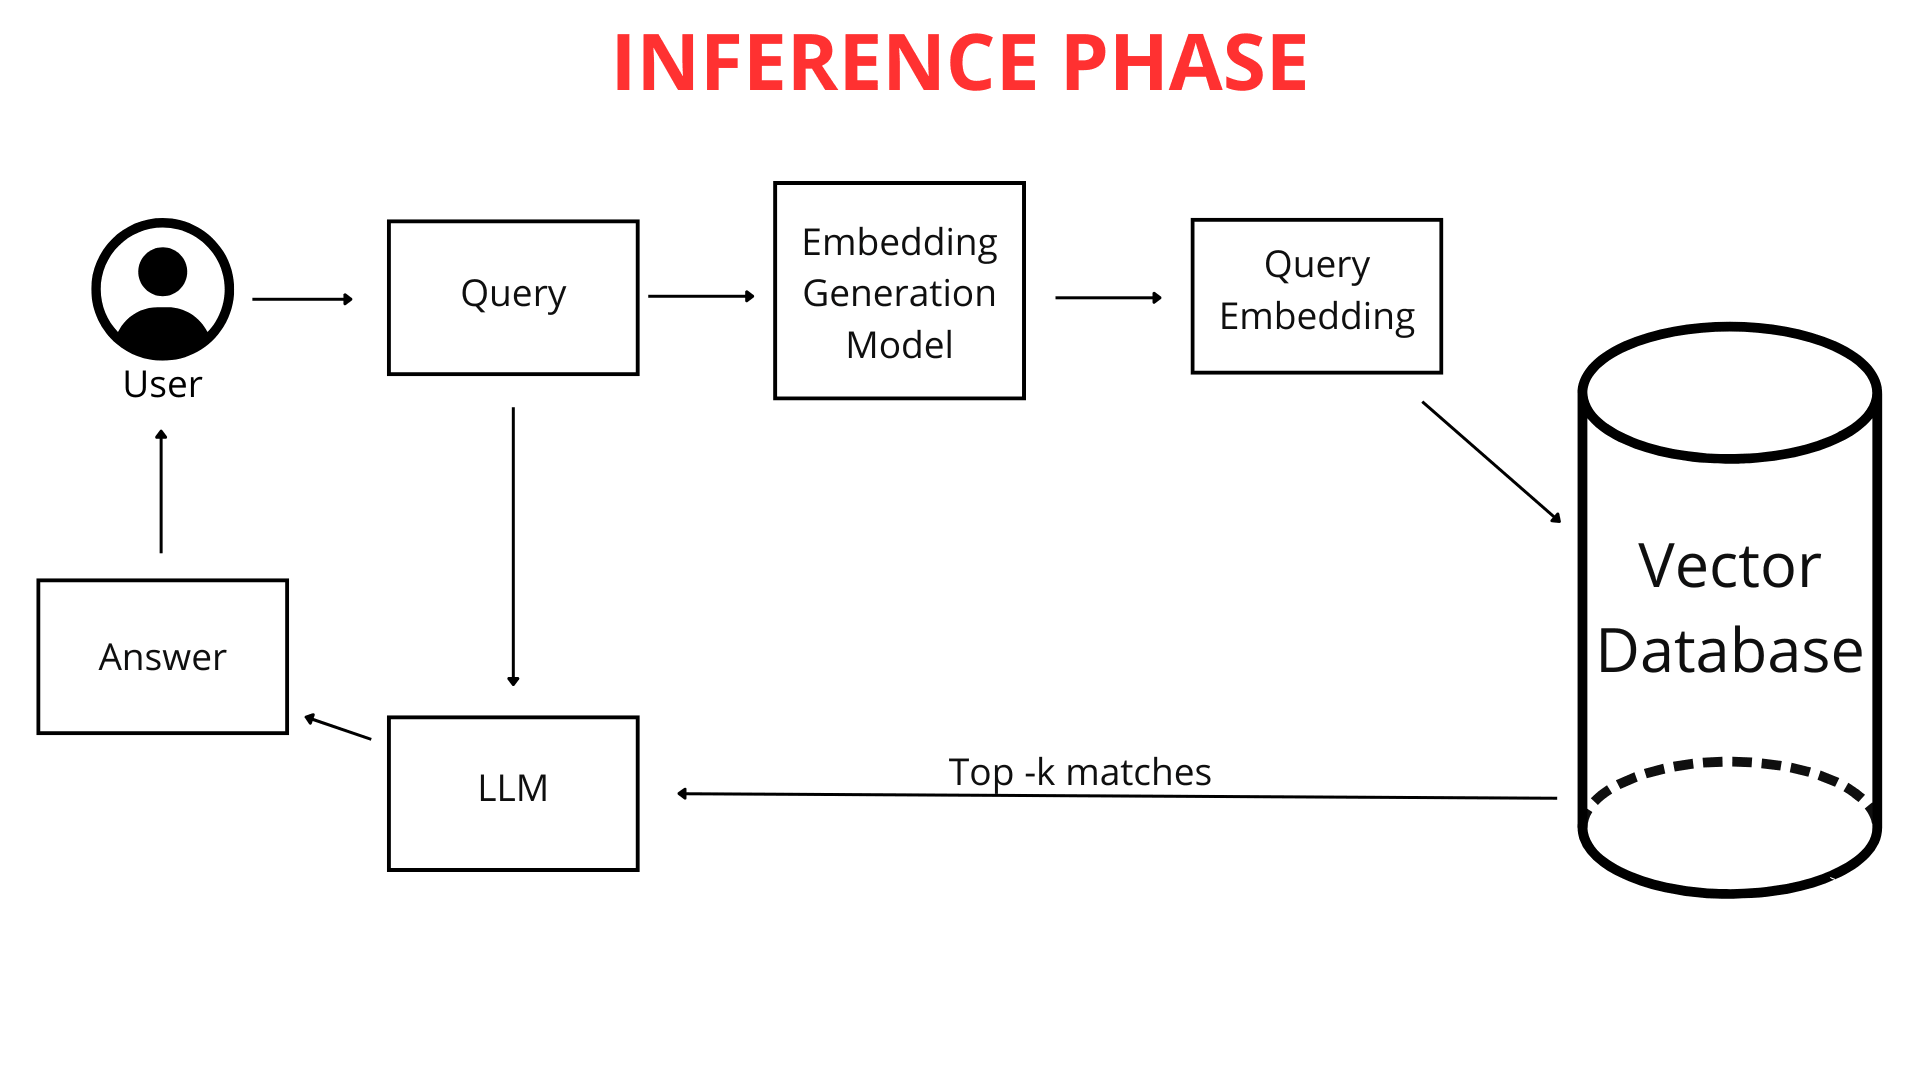
Kad Jūs kā lietotājs ievadāt jautājumu tērzēšanas robotā (piemēram, "Kādi rīt būs laikapstākļi Krakovā?"), tas netiek uzreiz salīdzināts ar tērzēšanas robota zināšanām neapstrādāta teksta formā. Vispirms jautājums tiek kartēts skaitliskā vektorā. Tā kā gan Jūsu jautājums, gan visa tērzēšanas robota zināšanu bāze ir attēlota vienā formātā - kā vektoru kartes (skaitļu saraksti) -, tērzēšanas robots var tos efektīvi salīdzināt. Tas identificē tos savu zināšanu fragmentus, kas ir visciešāk saistīti ar Jūsu vaicājuma vektoru, ļaujot tam ģenerēt labāko iespējamo atbildi.
RAG stājas darbībā
Šeit izšķiroša loma ir RAG tehnoloģijai. RAG sistēma analizē Jūsu vaicājuma vektora reprezentāciju un izmanto to, lai vektoru datubāzē meklētu skaitļu sarakstus, kas tai ir vislīdzīgākie (vistuvākie daudzdimensiju telpā). Šie vislīdzīgākie vektori norāda uz sākotnējiem failu fragmentiem, kas ir visatbilstošākie Jūsu jautājumam.
RAG darbojas kā inteliģents "tilts" starp Jūsu vaicājumu un tērzēšanas robota plašo zināšanu bāzi. Tas ļauj dinamiski izgūt tikai to informāciju, kas visvairāk nepieciešama LLM (lielajam valodas modelim), lai formulētu atbildi. LLM vienkāršiem vārdiem runājot, ir uzlabots algoritms un datu kopa, kas apmācīta ar milzīgu teksta apjomu un spēj saprast un ģenerēt dabisko valodu. Lai uzzinātu vairāk par šo tehnoloģiju, uzziniet, kā patiesībā darbojas ChatGPT. LLM var atbildēt uz jautājumiem un pat radīt daudzveidīgu saturu.
Bez RAG modelim būtu jāpaļaujas tikai uz tā iebūvētajām zināšanām, kurās var nebūt konkrētu detaļu no Jūsu failiem vai kuras varētu būt novecojušas. Pateicoties RAG, tērzēšanas robots iegūst iespēju izmantot papildu ārējās zināšanas tieši tajā brīdī, kad uzdodat jautājumu. Šīs jaunās zināšanas nāk tieši no Jūsu augšupielādētajiem failiem un tīmekļa lapām, kas ir atbilstoši apstrādātas.
Atšķirība starp tērzēšanas robotu ar RAG un bez tā
Galvenā atšķirība ir veidā, kā tiek piekļūts zināšanām.
Apmācītās zināšanas (bez RAG): tās ir LLM "iebūvētās" zināšanas, kas iegūtas intensīvas apmācības laikā ar plašām datu kopām pirms Jūsu mijiedarbības ar ChatLab. Ja jautāsiet par kaut ko, kas šajos datos nav iekļauts, modelis vienkārši var nezināt atbildi.
Jūsu failu zināšanas (izmantotas, izmantojot RAG): tās ir Jūsu unikālās, specializētās zināšanas, ko sniedzat tērzēšanas robotam. RAG ļauj tērzēšanas robotam dinamiski piekļūt šīm zināšanām, atbildot uz jautājumiem, apvienojot tās ar tā vispārējām apmācības zināšanām, lai ģenerētu visaptverošu atbildi. Šī pieeja darbina mūsdienīgu sarunvalodas mākslīgo intelektu klientu apkalpošanai.
Analoģija:
Iedomājieties LLM kā ārkārtīgi gudru studentu, kurš ir izlasījis neskaitāmas grāmatas (apmācības dati) un kuram ir iespaidīgas vispārējās zināšanas. Tagad Jūs viņam iedodat savas lekciju pierakstu klades un izdales materiālus (Jūsu failus). RAG darbojas kā sistēma, kas ļauj šim studentam, atbildot uz jautājumu, ātri ielūkoties Jūsu pierakstos, nevis paļauties tikai uz to, ko viņš atceras no visām šīm grāmatām. Šis uzlabojums garantē labākas, precīzākas un - pats galvenais - aktuālākas atbildes.
Pateicoties RAG, tērzēšanas robots var paplašināt savas zināšanas ar Jūsu unikālajiem datiem un aktīvi izmantot tos mijiedarbībā. Tas neaprobežojas tikai ar to, ko apguvis sākotnējās apmācības laikā.
Tāpēc RAG ir nenovērtējams, ja nepieciešams, lai tērzēšanas robots atbildētu uz jautājumiem par Jūsu konkrēto informāciju - detaļām, kas nav publiski pieejamas vai ir pārāk specifiskas, lai tās tiktu iekļautas vispārējos LLM apmācības datos.
Ja Jūsu jautājums ir: "Kur es varu atrast grāmatas par kosmosu?", pirms "bibliotekārs" (tērzēšanas robots) sāk "pārmeklēt plauktus", tas vispirms "pārtulko" Jūsu jautājumu "plauktu valodā" - nosakot atbilstošo grāmatu kategoriju. Vektoru kartes izveide Jūsu jautājumam ir kā vaicājuma katalogizēšana kategorijās, kuras tērzēšanas robots saprot un kurām var piekļūt, izmantojot vektoru datubāzi.
Apmācības un zināšanu izmantošanas fāze
Kā paskaidrots iepriekš, Jūsu jautājums tiek pārveidots skaitļu sarakstā, kas atspoguļo tā nozīmi. Pēc tam tērzēšanas robots vektoru datubāzē meklē vislīdzīgākos vektorus, kas pārstāv zināšanu fragmentus. Jo tuvākas vektoru reprezentācijas, jo lielāka līdzība starp Jūsu jautājumu un šiem zināšanu fragmentiem.
Tērzēšanas robots atlasa visatbilstošākos iepriekš apstrādāto zināšanu fragmentus - tos, kuru vektori ir vistuvāk Jūsu jautājuma vektoru kartei. Svarīgi, ka, analizējot Jūsu vaicājumu, ChatLab ņem vērā ne tikai pašu jautājumu, bet arī visas līdzšinējās sarunas kontekstu. Tas ļauj RAG sistēmai precīzāk atlasīt labāko informāciju no pievienotajiem zināšanu avotiem.
Piemēram, ja vispirms jautājat par "jaunākajiem tālruņu modeļiem" un pēc tam turpināt ar "Vai tiem ir labas kameras?", tērzēšanas robots, atceroties sarunas kontekstu, saprot, ka Jūs joprojām runājat par šiem konkrētajiem tālruņiem.
Atlasītie zināšanu fragmenti tiek apvienoti ar Jūsu sākotnējo jautājumu un norādēm no sadaļas "Loma un uzvedība". Šie norādījumi, kas pazīstami arī kā uzvedne (prompt), ir mūsu personalizētais vadlīniju kopums tērzēšanas robotam. Ja vēlamies, lai tērzēšanas robots atbildes beigās vienmēr pievienotu avota saiti vai noteiktā veidā sveicinātu lietotājus, mēs to iekļaujam uzvednē.
Tādējādi tiek izveidots papildināts vaicājums, kas pēc tam tiek nodots tērzēšanas robota "smadzenēm" - lielajam valodas modelim (LLM) no OpenAI, Google vai citiem pakalpojumu sniedzējiem.
Valodas modelis analizē šo sarežģīto informācijas kopumu: uzvedni, sarunu vēsturi un zināšanas, kas izgūtas lietotāja vaicājumam. Turklāt LLM izmanto savas vispārējās zināšanas par pasauli, lai ģenerētu atbildi. Tas nodrošina ļoti personalizētu klientu pieredzi ar mākslīgo intelektu. Visbeidzot, pilnveidotā un noslīpētā atbilde tiek parādīta ChatLab tīrajā saskarnē.
Kopsavilkums
Šajā rakstā mēs apskatījām RAG sistēmas arhitektūru tērzēšanas robota darbībā - no datu ievades līdz atbildes ģenerēšanai. RAG ir mūsdienu sarunvalodas sistēmu pamatkomponents, kas ļauj efektīvi izmantot ārējās zināšanas. Tādi uzņēmumi kā ChatLab aktīvi integrē šo revolucionāro tehnoloģiju savos produktos, nodrošinot klientiem uzlabotas un viedas mijiedarbības iespējas.
Lai gan RAG sistēmai piemīt zināma tehniskā sarežģītība, tās ietekme uz mākslīgā intelekta ģenerēto tekstu ir nenoliedzama. Fakts, ka to veiksmīgi izmanto vadošie tehnoloģiju uzņēmumi, piemēram, Google, Microsoft un Amazon, uzsver tās izšķirošo lomu mākslīgā intelekta dinamiskajā attīstībā.
Vai esat gatavs izmēģināt RAG tehnoloģiju praksē? Izpētiet ChatLab funkcijas vai uzziniet, kā izveidot savu mākslīgā intelekta tērzēšanas robotu, ko darbina šī tehnoloģija.


