Kuidas ChatLab kasutab RAG-tehnoloogiat?


Kuidas ChatLab kasutab RAG-tehnoloogiat?
ChatLabis loome intelligentseid vestlusroboteid, mis muudavad veebisuhtluse täielikult. Nende võimekuse peamine mootor on uuenduslik tehnoloogia nimega Retrieval-Augmented Generation (RAG). See moodustab meie süsteemi vundamendi, võimaldades pakkuda lahendusi, mis ulatuvad tavapärastest vestlustest palju kaugemale.
Vestlusrobotite maailmas on kaks peamist treenimismeetodit. Erinevate vestlusrobotite tüüpide mõistmine aitab näha, kuidas need treenimisviisid erinevad. Esimene meetod hõlmab keerukate närvivõrkude intensiivset treenimist - protsessi, mis on keerukas, aeganõudev ja kulukas. Teine lähenemisviis, mida me ChatLabis edukalt kasutame, on RAG. See pole mitte ainult lihtsam, kulutõhusam ja kiirem juurutada, vaid annab meie vestlusrobotitele ka juurdepääsu piiramatutele välistele teabeallikatele - näiteks teie enda failidele. See võimaldab meil luua vastuseid, mis on äärmiselt täpsed, kontekstiteadlikud ja isikupärastatud.
Kutsume teid edasi lugema ja süvenema sellesse, kuidas RAG-tehnoloogia ChatLabi tööd toetab!
Mis on RAG täpsemalt?
Meie süsteemi toimimise mõistmiseks tasub lähemalt uurida infootsinguga täiendatud genereerimist (Retrieval-Augmented Generation). Kuigi vestlusrobotiga suhtlemine võib kasutaja vaatenurgast tunduda intuitiivne, võimaldab selle toimimise taga peituvate mehhanismide mõistmine selle potentsiaali täielikult hinnata.
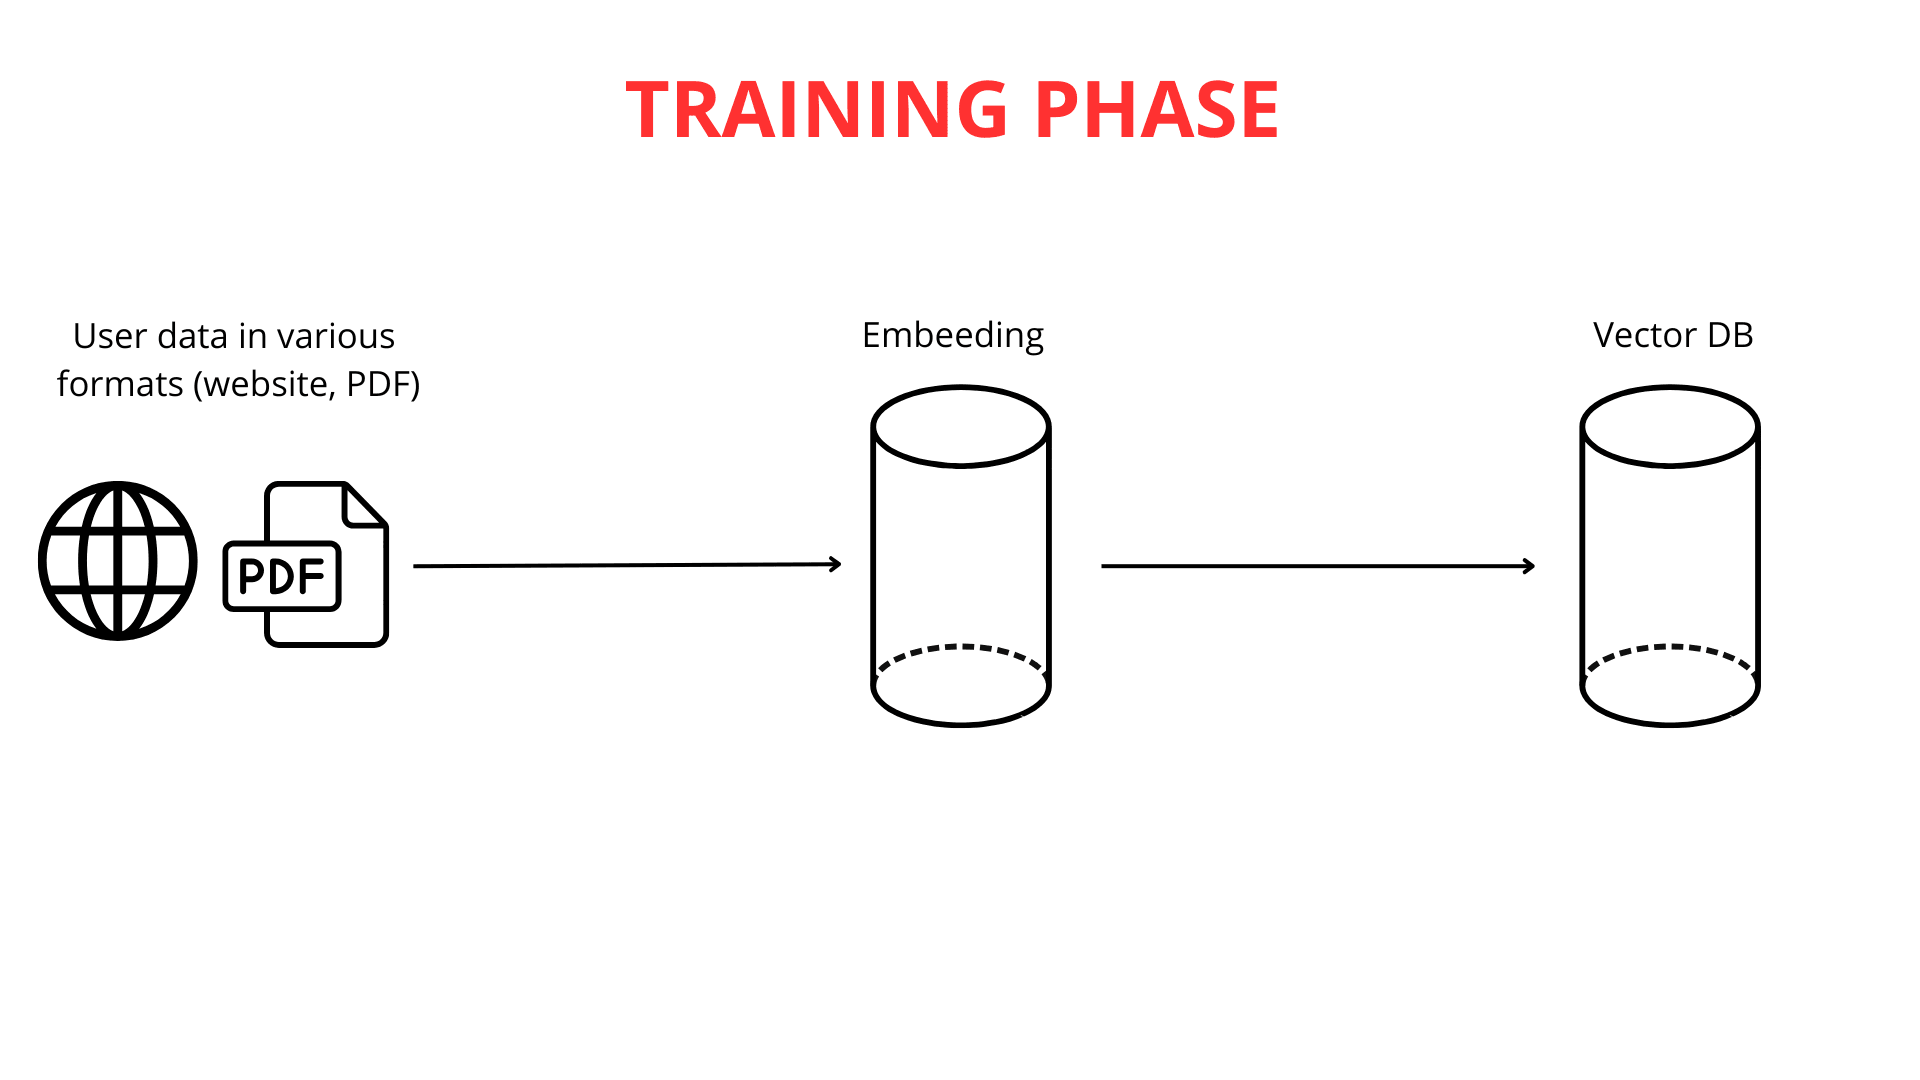
Nutika vestlusroboti ehitamine on protsess, mis põhineb mitme teadusharu teadmistel. Esimene ja kõige olulisem samm on vestlusrobotile andmete etteandmine. ChatLabis võimaldame seda teha mitmel mugaval viisil: laadides üles veebisaidi sisu, ulatuslikku dokumentatsiooni või isegi teie enda PDF-faile. Teadmusbaasi kohandamisel vastavalt teie vajadustele on võimalused praktiliselt piiramatud.
Järgmine etapp hõlmab pikkade tekstide tükeldamist väiksemateks osadeks (igaüks kuni 600 märki/tokenit), mis muudab süsteemile teabe tõhusa töötlemise lihtsamaks. Kui andmed on üles laaditud ja segmenteeritud, algab vektorkaardistamise protsess.
Oluline on rõhutada, et teksti teisendamine vektoriteks on RAG-i toimimise seisukohalt kriitilise tähtsusega. Nende vektorrepresentatsioonide loomise eest vastutavad võimsad suurte keelemudelite (LLM) mootorid.
Vektorkaardistamise roll teksti mõistmisel
Teksti vektoriseerimine on sisuliselt sõnade muutmine arvude loenditeks - konstrueeritud viisil, et sarnase tähendusega sõnad saavad sarnased numbrilised esitused (vektorid). See võimaldab meie vestlusrobotil "mõista" erinevate sõnajadade vahelisi seoseid. Näiteks sõnad "suur" ja "hiiglaslik" teisendatakse väga sarnasteks arvuloenditeks, samas kui "suur" ja "sipelgas" saavad täiesti erinevad esitused.
Neid arvulisi sarnasusi ja erinevusi analüüsides saab vestlusrobot järeldada, et "kass" ja "koer" on omavahel tihedamalt seotud kui "kass" ja "roheline".
Kui vektorid on loodud, salvestatakse need teadmiste arvulised esitused koos algse sisuga vektorandmebaasi. Vektorandmebaas toimib vektoriseeritud teadmiste täiustatud kataloogina, mis on optimeeritud seotud tähenduste kiireks leidmiseks.
Vektorandmebaas: intelligentne teadmiste raamatukogu
Vektorandmebaasi toimimise paremaks mõistmiseks kasutame nutika otsingusüsteemiga raamatukogu analoogiat. Iga "raamat" (tekstifragment) on "märgistatud" unikaalse vektoriga (arvude jadaga). See kood sisaldab mitut arvu, mis tähistavad raamatu autorit, stiili ja teemat. Kahel sarnasel teemal kirjutatud raamatul on väga sarnased koodid.
Selles "raamatukogus" asetatakse raamatud oma koodide põhjal mitmemõõtmelises ruumis "riiulitele". Sarnaste koodidega raamatud paigutatakse lähestikku - sarnaselt samas kategoorias olevate raamatutega, kuid need on täiendavalt organiseeritud sisu peente sarnasuste järgi. Kui te esitate küsimuse (nt "Milline on šokolaadikoogi retsept?"), teisendatakse see samuti selliseks "koodiks". Vektorandmebaasi nutikas otsingusüsteem skannib "riiuleid" (tekstifragmente) koodide leidmiseks, mis vastavad kõige paremini teie päringu koodile.
Algoritm tuvastab kiiresti "raamatud" (fragmendid), mis sisaldavad kõige suurema tõenäosusega vastust. Selle asemel, et otsida läbi kogu "raamatukogu", tuvastab vestlusrobot koheselt tähenduse poolest kõige asjakohasemad teadmuskillud. See tagab kiiremad, täpsemad ja kontekstile suunatud vastused.
Mis juhtub, kui te küsimuse esitate?
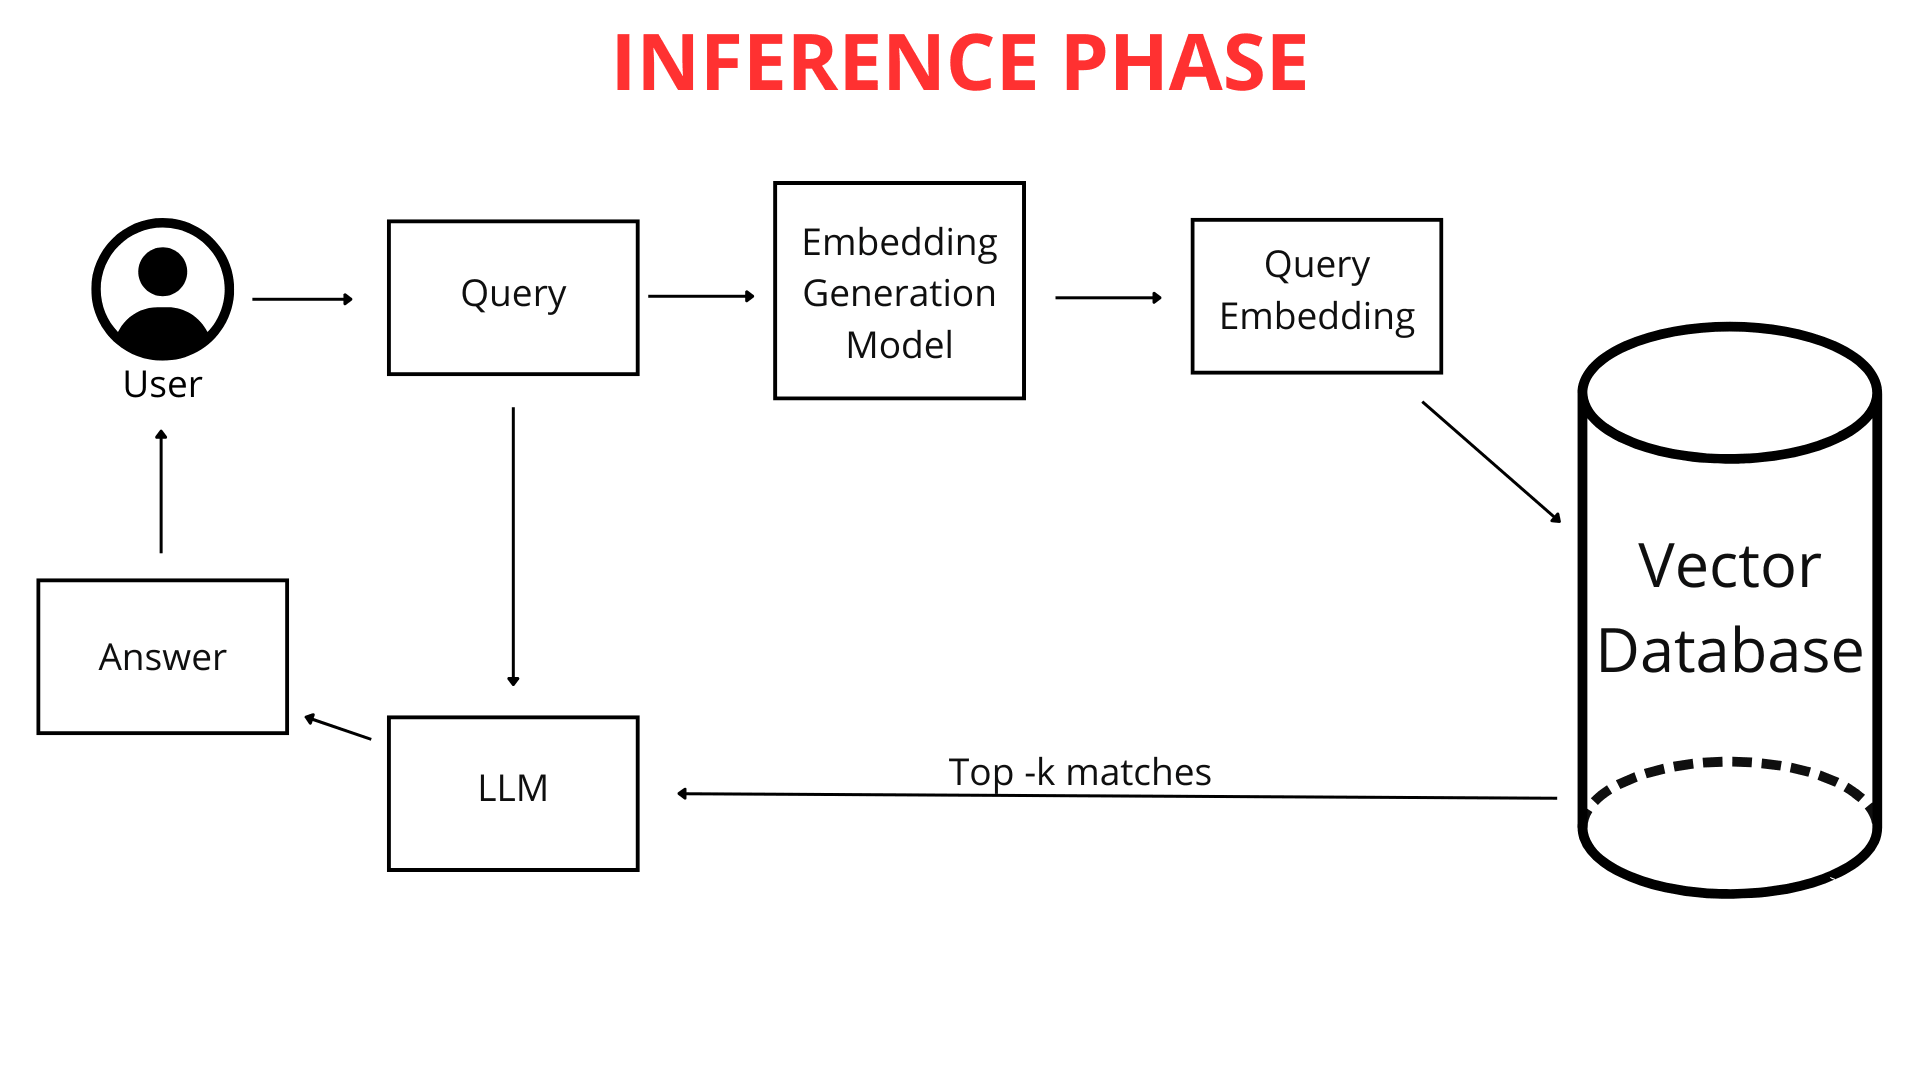
Kui te kasutajana sisestate vestlusrobotisse küsimuse (nt "Milline on homme ilm Krakowis?"), ei võrrelda seda vestlusroboti teadmistega kohe toorteksti kujul. Esiteks kaardistatakse küsimus arvuliseks vektoriks. Kuna nii teie küsimus kui ka vestlusroboti kogu teadmusbaas on esitatud samas formaadis - vektorkaartidena (arvude loenditena) -, saab vestlusrobot neid tõhusalt võrrelda. See tuvastab oma teadmistest need osad, mis on teie päringu vektoriga kõige tihedamalt seotud, võimaldades luua parima võimaliku vastuse.
RAG asub tegevusse
Siin mängib keskset rolli RAG-tehnoloogia. RAG-süsteem analüüsib teie päringu vektorrepresentatsiooni ja otsib selle abil vektorandmebaasist arvuloendeid, mis on sellega kõige sarnasemad (mitmemõõtmelises ruumis kõige lähemal). Need kõige sarnasemad vektorid viitavad algsetele failifragmentidele, mis on teie küsimuse seisukohalt kõige asjakohasemad.
RAG toimib nagu nutikas "sild" teie päringu ja vestlusroboti tohutu teadmusbaasi vahel. See võimaldab dünaamiliselt hankida ainult seda teavet, mida keelemudel (LLM) vastuse koostamiseks kõige enam vajab. LLM on lihtsustatult öeldes täiustatud algoritm ja andmekogum, mida on treenitud tohutute tekstihulkade põhjal ning mis suudab mõista ja luua loomulikku keelt. Selle tehnoloogia kohta lisateabe saamiseks vaadake, kuidas ChatGPT tegelikult töötab. Suured keelemudelid suudavad vastata küsimustele ja luua ka mitmekülgset sisu.
Ilma RAG-ita peaks LLM toetuma üksnes oma sisseehitatud teadmistele, mis ei pruugi sisaldada teie failidest pärit konkreetseid detaile või võivad olla aegunud. Tänu RAG-ile saab vestlusrobot võime ammutada täiendavaid väliseid teadmisi täpselt siis, kui te küsimuse esitate. See värske teave pärineb otse teie üleslaaditud failidest ja veebilehtedelt, mis on eelnevalt nõuetekohaselt töödeldud.
Erinevus RAG-iga ja RAG-ita vestlusroboti vahel
Peamine erinevus seisneb selles, kuidas teadmistele ligi pääsetakse.
Treenitud teadmised (ilma RAG-ita): need on LLM-i "sisseehitatud" teadmised, mis omandati ulatuslike andmekogumite intensiivse treenimise käigus enne teie suhtlust ChatLabiga. Kui te küsite millegi kohta, mida neis andmetes ei kajastata, ei pruugi mudel vastust lihtsalt teada.
Teie failide teadmised (kasutatakse RAG-i kaudu): need on teie unikaalsed spetsiifilised teadmised, mille te vestlusrobotile annate. RAG võimaldab vestlusrobotil küsimustele vastamisel neile teadmistele dünaamiliselt ligi pääseda, kombineerides neid oma üldiste treenitud teadmistega tervikliku vastuse genereerimiseks. See lähenemisviis toetab tänapäevast vestluspõhist tehisintellekti klienditeeninduses.
Analoogia:
Kujutlege suurt keelemudelit äärmiselt intelligentse üliõpilasena, kes on läbi lugenud lugematul hulgal raamatuid (treenimisandmed) ja omab muljetavaldavaid üldteadmisi. Nüüd annate talle oma loengukonspektid ja jaotusmaterjalid (teie failid). RAG toimib süsteemina, mis võimaldab sellel üliõpilasel küsimusele vastates kiiresti teie märkmeid kontrollida, selle asemel et toetuda ainult sellele, mida ta kõigist neist raamatutest mäletab. See täiendus tagab paremad, täpsemad ja - mis kõige tähtsam - ajakohasemad vastused.
Tänu RAG-ile saab vestlusrobot laiendada oma teadmisi teie unikaalsete andmetega ja neid suhtluses aktiivselt kasutada. See ei piirdu vaid sellega, mida ta algse treenimise käigus õppis.
Seetõttu on RAG hindamatu väärtusega, kui vajate vestlusrobotit, mis vastaks küsimustele teie spetsiifilise teabe kohta - detailide kohta, mis pole avalikult kättesaadavad või on liiga nišipõhised, et kuuluda üldiste keelemudelite treenimisandmete hulka.
Kui teie küsimus on: "Kust ma leian kosmoseteemalisi raamatuid?", siis enne, kui "raamatukoguhoidja" (vestlusrobot) hakkab "riiulitelt otsima", "tõlgib" ta teie küsimuse esmalt "riiulite keelde" - tuvastades sobiva raamatukategooria. Teie küsimusest vektorkaardi loomine sarnaneb teie päringu kataloogimisega kategooriatesse, mida vestlusrobot mõistab ja millele ta vektorandmebaasi kaudu ligi pääseb.
Treenimis- ja teadmiste kasutamise etapp
Nagu varem selgitatud, teisendatakse teie küsimus selle tähendust esindavaks arvude loendiks. Seejärel otsib vestlusrobot vektorandmebaasist kõige sarnasemaid vektoreid, mis tähistavad teadmiste fragmente. Mida lähedasemad on vektorrepresentatsioonid, seda suurem on sarnasus teie küsimuse ja nende teadmusfragmentide vahel.
Vestlusrobot valib välja oma eeltöödeldud teadmistest kõige täpsemalt kattuvad fragmendid - need, mille vektorid on teie küsimuse vektorkaardile kõige lähemal. Oluline on märkida, et päringu analüüsimisel ei arvesta ChatLab ainult küsimust ennast, vaid ka senise vestluse kogu konteksti. See võimaldab RAG-süsteemil valida ühendatud teabeallikatest parima teabe veelgi täpsemalt.
Näiteks kui te küsite esmalt "uusimate telefonimudelite" kohta ja seejärel lisate küsimuse "Kas neil on head kaamerad?", saab vestlusrobot - vestluse konteksti meeles pidades - aru, et viitate endiselt neile konkreetsetele telefonidele.
Valitud teadmusfragmendid kombineeritakse teie algse küsimuse ja jaotises "Roll ja käitumine" olevate juhistega. Need juhised, mida nimetatakse ka viibaks (prompt), on meie isikupärastatud reeglistik vestlusrobotile. Kui soovime, et vestlusrobot lisaks oma vastuse lõppu alati allika lingi või tervitaks kasutajaid teatud kindlal viisil, lisame selle viibale.
Nii luuakse täiendatud päring, mis edastatakse seejärel vestlusroboti "ajule" - OpenAI, Google'i või muude pakkujate suurele keelemudelile (LLM).
Keelemudel analüüsib seda terviklikku teabekogumit: viipa, vestluste ajalugu ja kasutaja päringu jaoks hangitud teadmisi. Lisaks kasutab LLM vastuse genereerimiseks oma üldisi maailmateadmisi. See võimaldab luua väga isikupärastatud kliendikogemusi tehisintellekti abil. Lõpuks kuvatakse viimistletud ja lihvitud vastus ChatLabi selges liideses.
Kokkuvõte
Selles artiklis vaatasime läbi RAG-süsteemi arhitektuuri vestlusroboti toimimises - alates andmete sisestamisest kuni vastuste genereerimiseni. RAG on tänapäevaste vestlussüsteemide põhielement, mis võimaldab välisteadmiste tõhusat kasutamist. Sellised ettevõtted nagu ChatLab integreerivad seda murrangulist tehnoloogiat aktiivselt oma toodetesse, pakkudes klientidele täiustatud ja intelligentseid suhtlusvõimalusi.
Kuigi RAG-süsteemil on teatav tehniline keerukus, on selle mõju tehisintellekti genereeritud tekstile vaieldamatu. Asjaolu, et seda kasutavad edukalt juhtivad tehnoloogiaettevõtted nagu Google, Microsoft ja Amazon, rõhutab selle keskset rolli tehisintellekti dünaamilises arengus.
Kas olete valmis RAG-tehnoloogiat omal käel kogema? Tutvuge ChatLabi funktsioonidega või lugege, kuidas luua oma tehisintellektiga vestlusrobot, mis sellel tehnoloogial põhineb.


