Hvordan ChatLab utnytter RAG-teknologi?


Hvordan ChatLab utnytter RAG-teknologi?
Hos ChatLab lager vi intelligente chatboter som revolusjonerer interaksjoner på nett. Den viktigste drivkraften bak egenskapene deres er en nyskapende teknologi kalt Retrieval-Augmented Generation (RAG). Dette utgjør fundamentet i systemet vårt, og gjør det mulig for oss å levere løsninger som strekker seg langt utover standard samtaler.
I chatbot-verdenen finnes det to primære treningsmetoder. Å forstå de ulike typene chatboter hjelper deg med å se hvordan disse tilnærmingene til trening skiller seg fra hverandre. Den første metoden innebærer intensiv trening av komplekse nevrale nettverk - en prosess som er intrikat, tidkrevende og kostbar. Den andre tilnærmingen, som vi bruker med stor suksess i ChatLab, er RAG. Ikke bare er den enklere, mer kostnadseffektiv og raskere å implementere, men den gir også chatbotene våre tilgang til ubegrensede eksterne informasjonskilder - for eksempel dine egne filer. Dette gjør at vi kan generere svar som er svært presise, kontekstbevisste og personlig tilpassede.
Vi inviterer deg til å lese videre og lære mer om hvordan RAG-teknologi driver ChatLab!
Hva er egentlig RAG?
For å forstå hvordan systemet vårt fungerer, er det verdt å se nærmere på Retrieval-Augmented Generation. Selv om det å samhandle med en chatbot kan virke intuitivt fra en brukers ståsted, gjør en forståelse av mekanismene bak at du fullt ut kan verdsette potensialet.
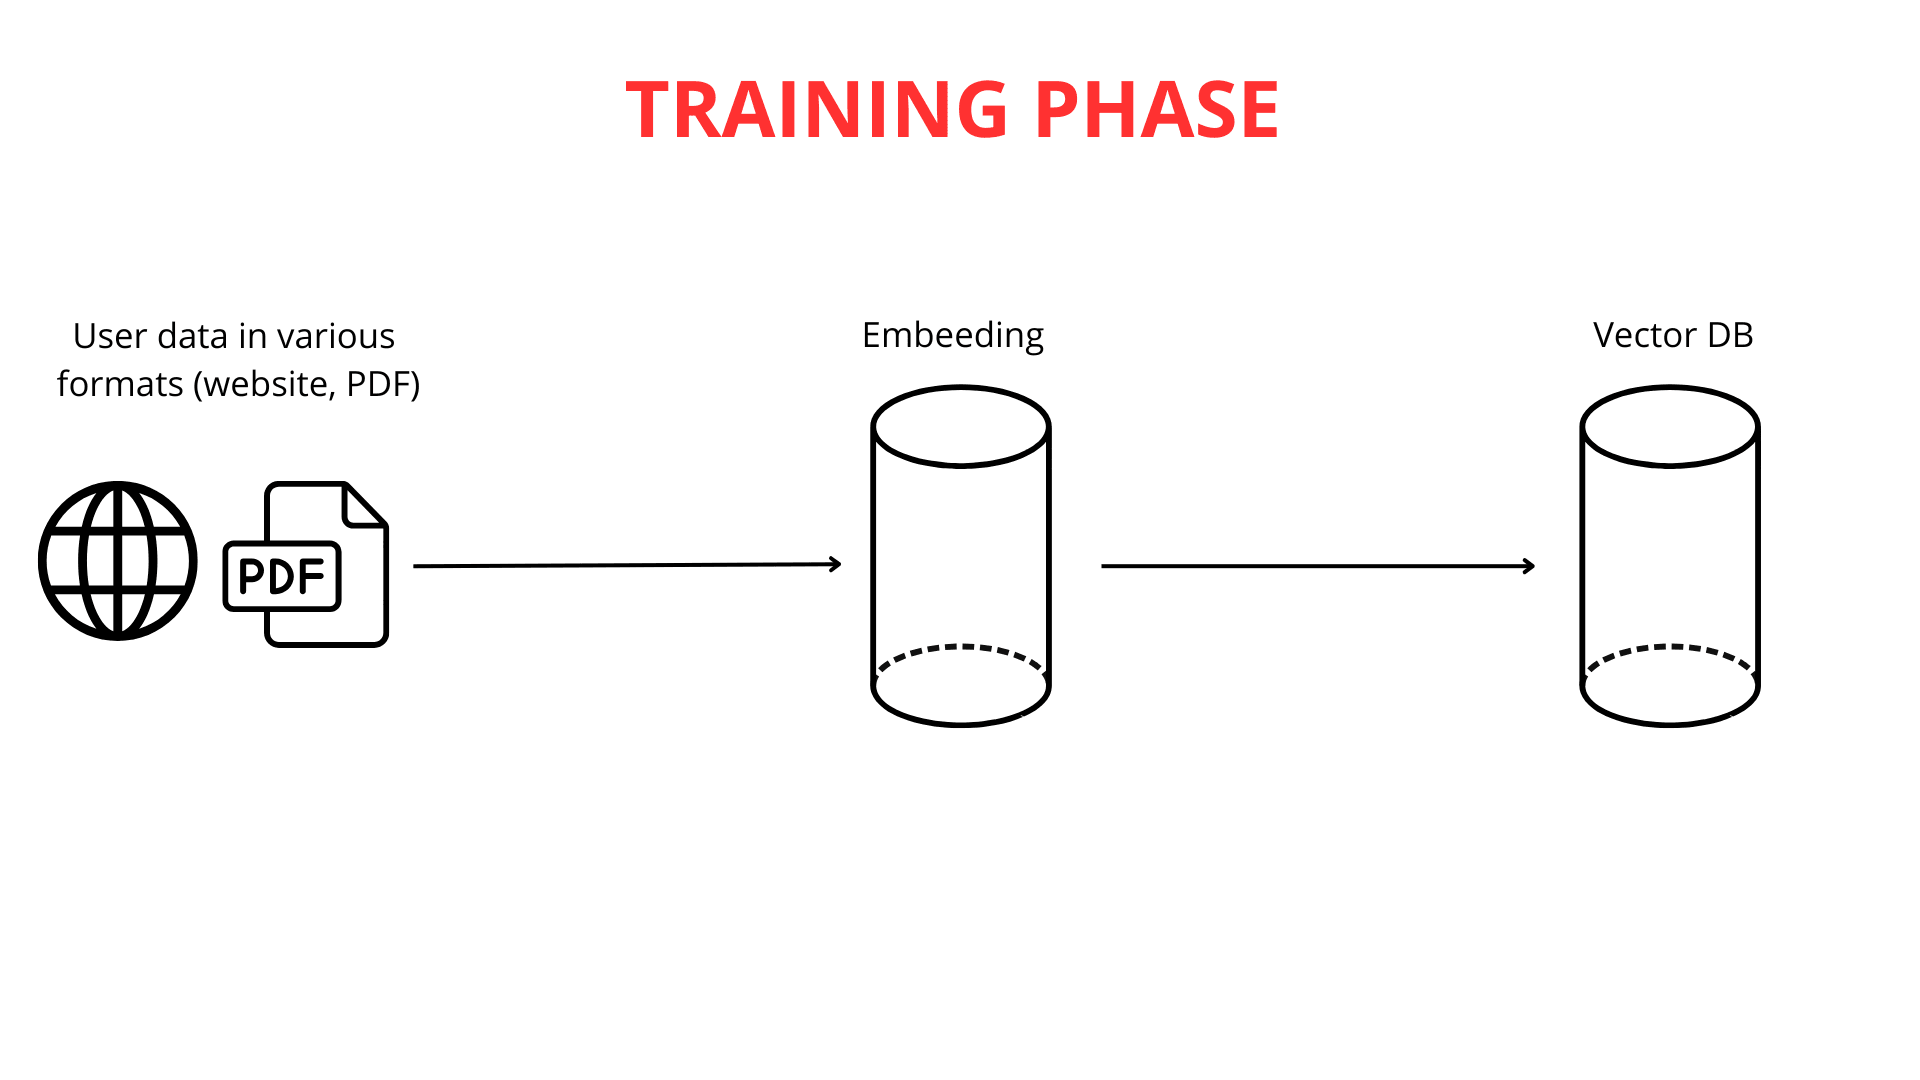
Å bygge en intelligent chatbot er en prosess forankret i kunnskap fra flere vitenskapelige fagfelt. Det første og mest avgjørende steget er å mate chatboten med data. I ChatLab gjør vi dette mulig på flere praktiske måter: ved å laste opp innhold fra nettsider, omfattende dokumentasjon eller dine egne PDF-filer. Mulighetene for å tilpasse kunnskapsbasen etter dine behov er tilnærmet ubegrensede.
Neste fase går ut på å dele opp lange tekster i mindre biter (opptil 600 tokens hver), noe som gjør det enklere for systemet å behandle informasjonen effektivt. Når dataene er lastet opp og segmentert, starter vektormappingsprosessen.
Det er viktig å understreke at tekst-til-vektor-kartlegging er avgjørende for funksjonaliteten til RAG. Kraftige store språkmodeller (LLM-er) er ansvarlige for å generere disse vektorrepresentasjonene.
Rollen til vektormapping i tekstforståelse
Vektorisering av tekst handler i bunn og grunn om å konvertere ord til lister med tall - konstruert på en slik måte at ord med lignende betydning får lignende numeriske representasjoner (vektorer). Dette gjør at chatboten vår kan "forstå" sammenhenger mellom ulike ordsekvenser. For eksempel vil ordene "stor" og "enorm" bli transformert til svært like tallister, mens "stor" og "maur" vil få vidt forskjellige representasjoner.
Ved å analysere disse numeriske likhetene og forskjellene kan chatboten utlede at "katt" og "hund" er tettere beslektet enn "katt" og "grønn".
Når vektorene er generert, lagres disse numeriske kunnskapsrepresentasjonene i en vektordatabase sammen med det opprinnelige innholdet. Vektordatabasen fungerer som en avansert katalog over vektorisert kunnskap, optimalisert for rask gjenfinning av beslektede betydninger.
Vektordatabasen: Et intelligent kunnskapsbibliotek
For å bedre forstå hvordan en vektordatabase fungerer, kan vi bruke en analogi med et bibliotek med et smart søkesystem. Hver "bok" (tekstfragment) er "merket" med en unik vektor (en tallsekvens). Denne koden inneholder mange tall som representerer forfatteren, stilen og temaet for boken. To bøker om lignende temaer vil ha svært like koder.
I dette "biblioteket" er bøkene plassert i "hyller" i et flerdimensjonalt rom basert på kodene sine. Bøker med like koder er plassert tett sammen - omtrent som bøker i samme kategori, men ytterligere organisert etter subtile innholdsmessige likheter. Når du stiller et spørsmål (f.eks. "Hva er oppskriften på sjokoladekake?"), konverteres det til en slik "kode". Det smarte søkesystemet i vektordatabasen skanner "hyllene" (tekstfragmentene) etter koder som matcher koden til forespørselen din mest mulig.
Algoritmen identifiserer raskt "bøkene" (fragmentene) som mest sannsynlig inneholder svaret. I stedet for å søke gjennom hele "biblioteket", finner chatboten umiddelbart de mest relevante kunnskapsbitene rent meningsmessig. Dette sikrer raskere, mer nøyaktige og mer kontekstfokuserte svar.
Hva skjer når du stiller et spørsmål?
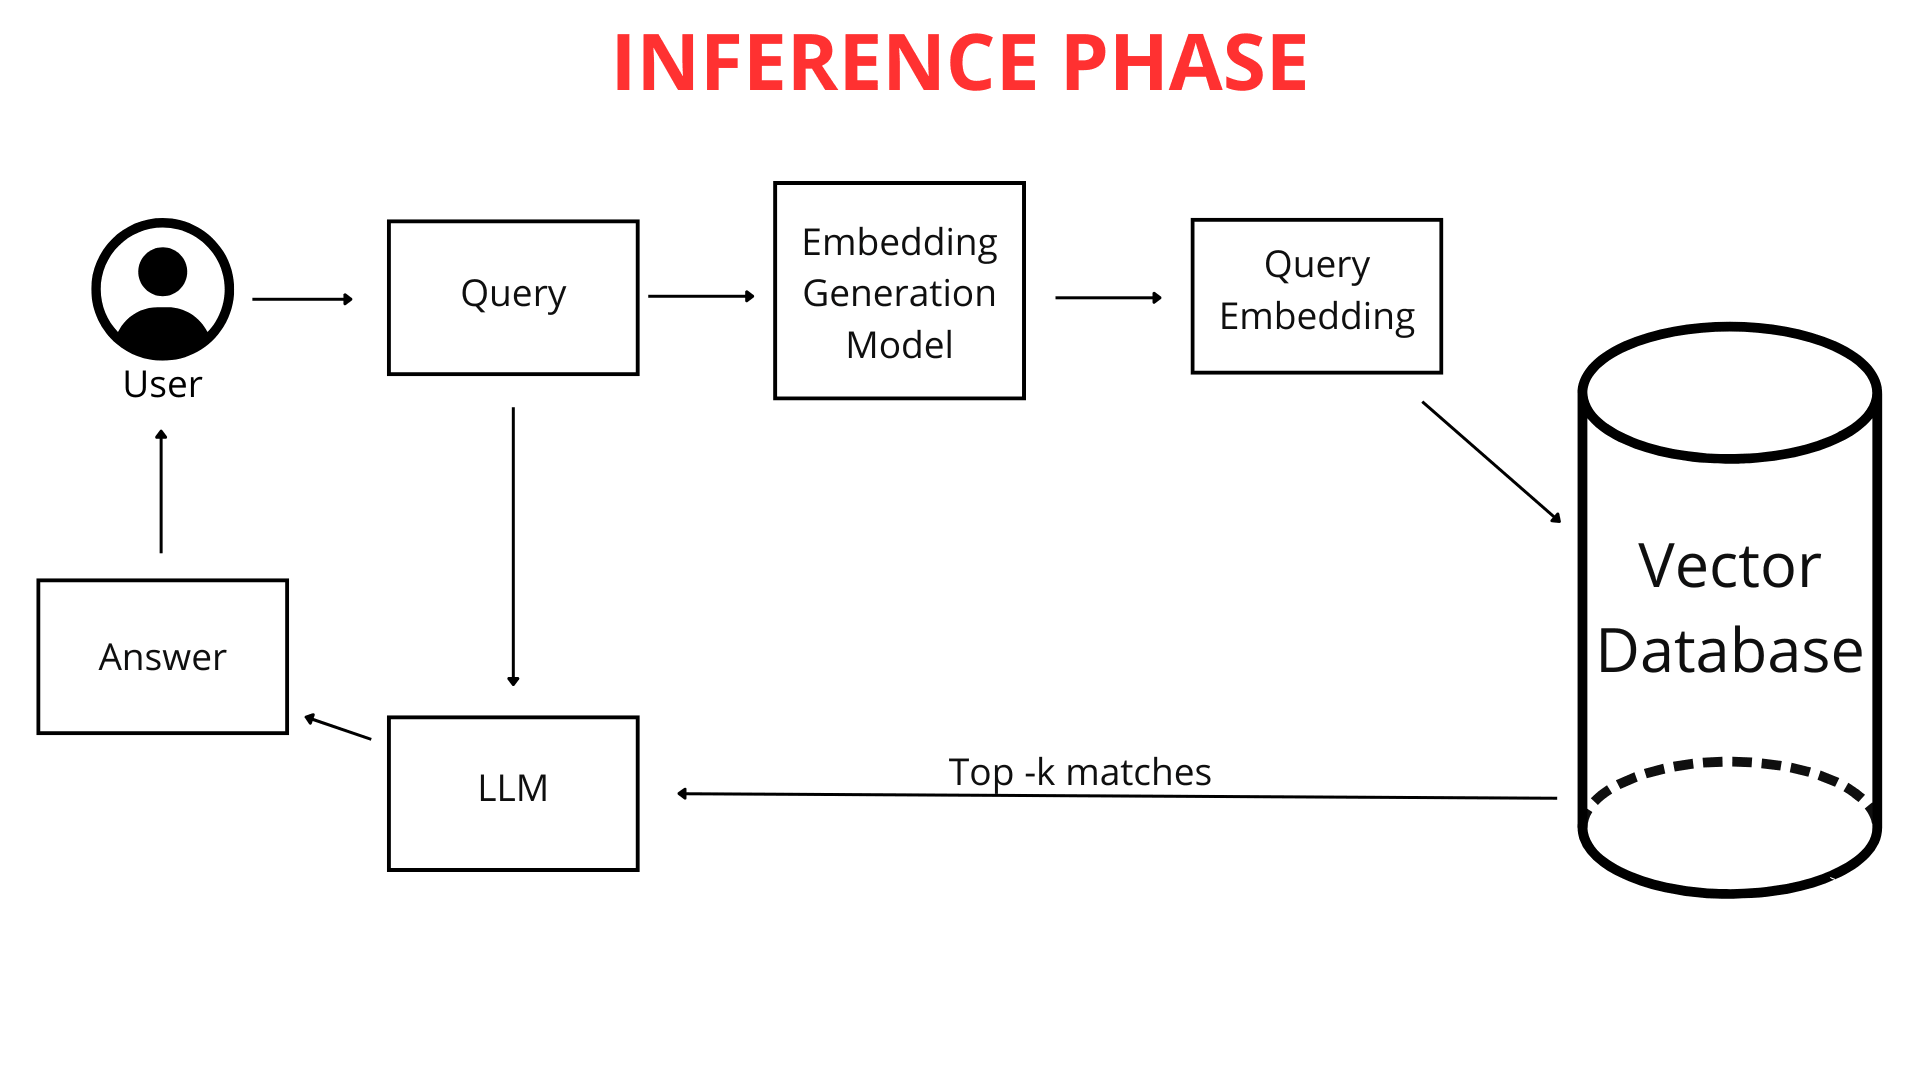
Når du som bruker skriver et spørsmål til chatboten (f.eks. "Hvordan er været i Krakow i morgen?"), blir det ikke umiddelbart sammenlignet med chatbotens kunnskap i ren tekstform. Først blir spørsmålet kartlagt til en numerisk vektor. Fordi både spørsmålet ditt og hele kunnskapsbasen til chatboten er representert i samme format - som vektorkart (tallister) - kan chatboten effektivt sammenligne dem. Den identifiserer fragmentene av kunnskapen sin som er tettest knyttet til vektoren i forespørselen din, noe som gjør den i stand til å generere et best mulig svar.
RAG trer i kraft
Det er her RAG-teknologien spiller en avgjørende rolle. RAG-systemet analyserer vektorrepresentasjonen av forespørselen din og bruker den til å søke i vektordatabasen etter tallistene som ligner mest (de som ligger nærmest i det flerdimensjonale rommet). Disse mest like vektorene peker mot de opprinnelige filfragmentene som er mest relevante for spørsmålet ditt.
RAG fungerer som en intelligent "bro" mellom spørsmålet ditt og chatbotens enorme kunnskapsbase. Den muliggjør dynamisk henting av kun den informasjonen som er mest nødvendig for at LLM-en (Large Language Model) skal kunne formulere et svar. En LLM er, enkelt forklart, en avansert algoritme og et datasett trent på massive mengder tekst, med evne til å forstå og generere naturlig språk. For å lære mer om denne teknologien kan du se hvordan ChatGPT egentlig fungerer. LLM-er kan svare på spørsmål og til og med skape variert innhold.
Uten RAG måtte en LLM utelukkende stolt på sin innebygde kunnskap, som kanskje ikke inneholder spesifikke detaljer fra filene dine, eller som kan være utdatert. Takket være RAG får chatboten muligheten til å hente inn ekstra ekstern kunnskap akkurat idet du stiller et spørsmål. Denne ferske kunnskapen kommer direkte fra dine opplastede filer og nettsider, som har blitt behandlet på riktig måte.
Forskjellen mellom en chatbot med og uten RAG
Hovedforskjellen ligger i hvordan kunnskapen nås.
Inntrent kunnskap (uten RAG): Dette er LLM-ens "innebygde" kunnskap, tilegnet under intensiv trening på enorme datasett før din interaksjon med ChatLab. Hvis du spør om noe som ikke dekkes av disse dataene, vet modellen rett og slett kanskje ikke svaret.
Kunnskap fra filene dine (brukt via RAG): Dette er din unike, spesialiserte kunnskap som du gir til chatboten. RAG lar chatboten dynamisk få tilgang til denne kunnskapen når den svarer på spørsmål, og kombinerer den med sin generelle treningskunnskap for å generere et fyllestgjørende svar. Denne tilnærmingen driver moderne samtalebasert AI for kundeservice.
En analogi:
Se for deg en LLM som en ekstremt intelligent student som har lest utallige bøker (treningsdata) og besitter imponerende allmennkunnskap. Nå gir du studenten forelesningsnotatene og kompendiene dine (filene dine). RAG fungerer som et system som lar studenten raskt sjekke notatene dine når et spørsmål skal besvares, i stedet for utelukkende å stole på hva vedkommende husker fra alle bøkene. Denne forbedringen sikrer bedre, mer presise og - viktigst av alt - mer oppdaterte svar.
Takket være RAG kan chatboten utvide kunnskapen sin med dine unike data og aktivt bruke dem i interaksjoner. Den er ikke begrenset til kun det den lærte under den opprinnelige treningen.
Dette er grunnen til at RAG er uvurderlig når du trenger at en chatbot skal svare på spørsmål om din spesifikke informasjon - detaljer som ikke er offentlig tilgjengelige eller er for snevre til å være en del av generelle LLM-treningsdata.
Hvis spørsmålet ditt er: "Hvor finner jeg bøker om verdensrommet?", vil "bibliotekaren" (chatboten) først "oversette" spørsmålet ditt til "hyllenes språk" før det begynner å "lete i hyllene" - og dermed identifisere riktig bokkategori. Å lage et vektorkart av spørsmålet ditt tilsvarer å katalogisere forespørselen din i kategorier chatboten forstår og kan hente via vektordatabasen.
Fasen for trening og kunnskapsutnyttelse
Som forklart tidligere konverteres spørsmålet ditt til en liste med tall som representerer betydningen. Chatboten søker deretter i vektordatabasen etter de mest like vektorene som representerer kunnskapsfragmenter. Jo tettere vektorrepresentasjonene er, desto større er likheten mellom spørsmålet ditt og disse kunnskapsfragmentene.
Chatboten velger ut de fragmentene av sin forhåndsbehandlede kunnskap som matcher best - de hvis vektorer ligger nærmest vektorkartet for spørsmålet ditt. Det er viktig å merke seg at når ChatLab analyserer forespørselen din, vurderes ikke bare selve spørsmålet, men også konteksten for hele samtalen så langt. Dette gjør at RAG-systemet mer presist kan velge den beste informasjonen fra tilkoblede kunnskapskilder.
Hvis du for eksempel først spør om "de nyeste telefonmodellene" og deretter følger opp med "Har de gode kameraer?", vil chatboten - ved å huske samtalekonteksten - forstå at du fortsatt refererer til akkurat disse telefonene.
De utvalgte kunnskapsfragmentene kombineres med det opprinnelige spørsmålet ditt og instruksjoner fra seksjonen for "Rolle og atferd". Disse instruksjonene, også kjent som en prompt, er vårt personlig tilpassede sett med retningslinjer for chatboten. Hvis vi vil at chatboten alltid skal legge til en kildelenke på slutten av svaret eller hilse på brukere på en bestemt måte, inkluderer vi dette i prompten.
Dette skaper en utvidet forespørsel (augmented query), som deretter sendes videre til chatbotens "hjerne" - den store språkmodellen (LLM) fra OpenAI, Google eller andre leverandører.
Språkmodellen analyserer dette sammensatte settet med informasjon: prompten, samtalehistorikken og kunnskapen som ble hentet ut for brukerens henvendelse. I tillegg utnytter LLM-en sin generelle verdenskunnskap til å generere et svar. Dette legger til rette for svært personlige kundeopplevelser med AI. Til slutt presenteres det bearbeidede og finpussede svaret i ChatLabs oversiktlige grensesnitt.
Oppsummering
I denne artikkelen har vi gått gjennom arkitekturen til RAG-systemet i en chatbots funksjonalitet - fra datainnhenting til generering av svar. RAG er en grunnleggende komponent i moderne samtalebaserte systemer, og muliggjør effektiv bruk av ekstern kunnskap. Selskaper som ChatLab integrerer aktivt denne banebrytende teknologien i produktene sine for å levere avanserte og intelligente interaksjonsmuligheter til kundene.
Selv om RAG-systemet har en viss teknisk kompleksitet, er effekten det har på AI-generert tekst udiskutabel. Det faktum at det brukes med suksess av ledende teknologiselskaper som Google, Microsoft og Amazon, understreker den sentrale rollen det spiller i den dynamiske utviklingen av kunstig intelligens.
Klar til å oppleve RAG-teknologi på nært hold? Utforsk funksjonene i ChatLab eller lær hvordan du bygger din egen AI-chatbot drevet av denne teknologien.


