Как ChatLab използва RAG технологията?


Как ChatLab използва RAG технологията?
В ChatLab създаваме интелигентни чатботове, които революционизират онлайн комуникацията. Основният двигател зад техните възможности е иновативна технология, наречена Retrieval-Augmented Generation (RAG). Тя формира основата на нашата система, позволявайки ни да предоставяме решения, които надхвърлят стандартните разговори.
В света на чатботовете съществуват два основни метода за обучение. Разбирането на различните видове чатботове помага да видите по какво се различават тези подходи на обучение. Първият метод включва интензивно обучение на сложни невронни мрежи - процес, който е комплексен, отнема много време и е скъп. Вторият подход, който успешно прилагаме в ChatLab, е RAG. Той е не само по-прост, по-изгоден и по-бърз за внедряване, но и предоставя на нашите чатботове достъп до неограничени външни източници на информация - като например Вашите собствени файлове. Това ни позволява да генерираме отговори, които са изключително точни, съобразени с контекста и персонализирани.
Каним Ви да продължите да четете и да се запознаете по-подробно с това как технологията RAG захранва ChatLab!
Какво точно представлява RAG?
За да разберете как работи нашата система, си струва да разгледаме по-отблизо Retrieval-Augmented Generation. Въпреки че от гледна точка на потребителя взаимодействието с чатбот може да изглежда интуитивно, разбирането на механизмите зад неговата работа Ви позволява да оцените напълно неговия потенциал.
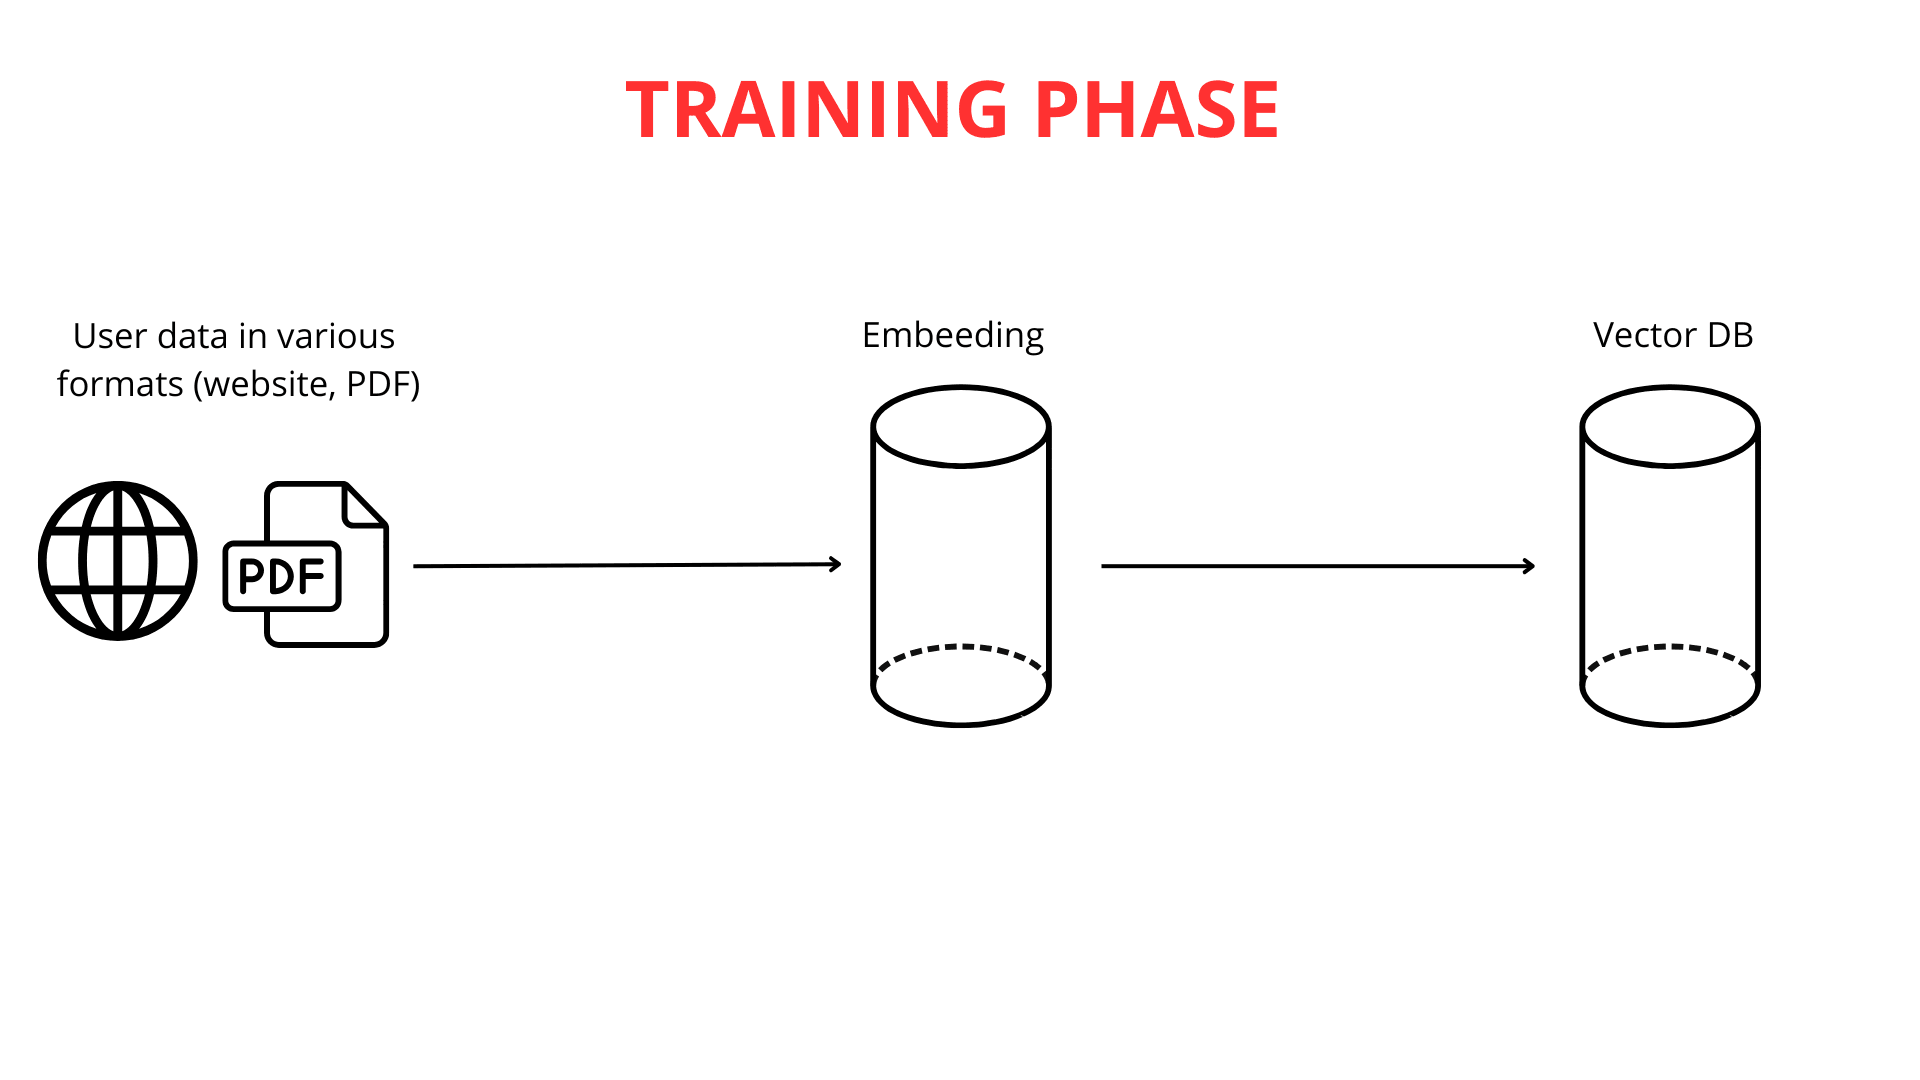
Изграждането на интелигентен чатбот е процес, основан на знания от множество научни дисциплини. Първата и най-важна стъпка е захранването на чатбота с данни. В ChatLab позволяваме това да става по няколко удобни начина: чрез качване на съдържание от уебсайт, подробна документация или дори Ваши собствени PDF файлове. Възможностите за персонализиране на базата от знания според Вашите нужди са практически неограничени.
Следващият етап включва разделяне на дългите текстове на по-малки части (до 600 токена всяка), което улеснява системата да обработва информацията ефективно. След като данните са качени и сегментирани, започва процесът на векторно картографиране.
Важно е да се подчертае, че картографирането на текст към вектори е от критично значение за функционирането на RAG. Мощни модели на големи езикови модели (LLM) отговарят за генерирането на тези векторни представяния.
Ролята на векторното картографиране в разбирането на текста
Векторизацията на текст по същество представлява преобразуване на думите в списъци от числа - структурирани по такъв начин, че думите с близко значение получават сходни числови представяния (вектори). Това позволява на нашия чатбот да "разбира" връзките между различните поредици от думи. Например думите "голям" и "огромен" биха били трансформирани в много сходни числови списъци, докато "голям" и "мравка" биха получили напълно различни представяния.
Чрез анализиране на тези числови сходства и разлики, чатботът може да направи извод, че "котка" и "куче" са по-тясно свързани, отколкото "котка" и "зелен".
След като векторите са генерирани, тези числови представяния на знанието се съхраняват във векторна база данни заедно с оригиналното съдържание. Векторната база данни действа като усъвършенстван каталог от векторизирано знание, оптимизиран за бързо извличане на свързани значения.
Векторната база данни: Интелигентна библиотека от знания
За да разберете по-добре как работи векторната база данни, нека използваме аналогията с библиотека с интелигентна система за търсене. Всеки "том" (текстов фрагмент) е "маркиран" с уникален вектор (последователност от числа). Този код съдържа множество числа, представляващи автора, стила и тематиката на книгата. Две книги на сходни теми ще имат много близки кодове.
В тази "библиотека" книгите се поставят по "рафтове" в многомерно пространство въз основа на техните кодове. Книгите със сходни кодове се групират близо една до друга - подобно на книги в една и съща категория, но допълнително организирани според фини сходства в съдържанието. Когато зададете въпрос (напр. "Каква е рецептата за шоколадова торта?"), той се преобразува в такъв "код". Интелигентната система за търсене във векторната база данни сканира "рафтовете" (текстовите фрагменти) за кодове, които най-точно съответстват на кода на Вашето запитване.
Алгоритъмът бързо идентифицира "книгите" (фрагментите), за които е най-вероятно да съдържат отговора. Вместо да претърсва цялата "библиотека", чатботът незабавно посочва най-релевантните по смисъл елементи от знанието. Това гарантира по-бързи, по-точни и фокусирани върху контекста отговори.
Какво се случва, когато зададете въпрос?
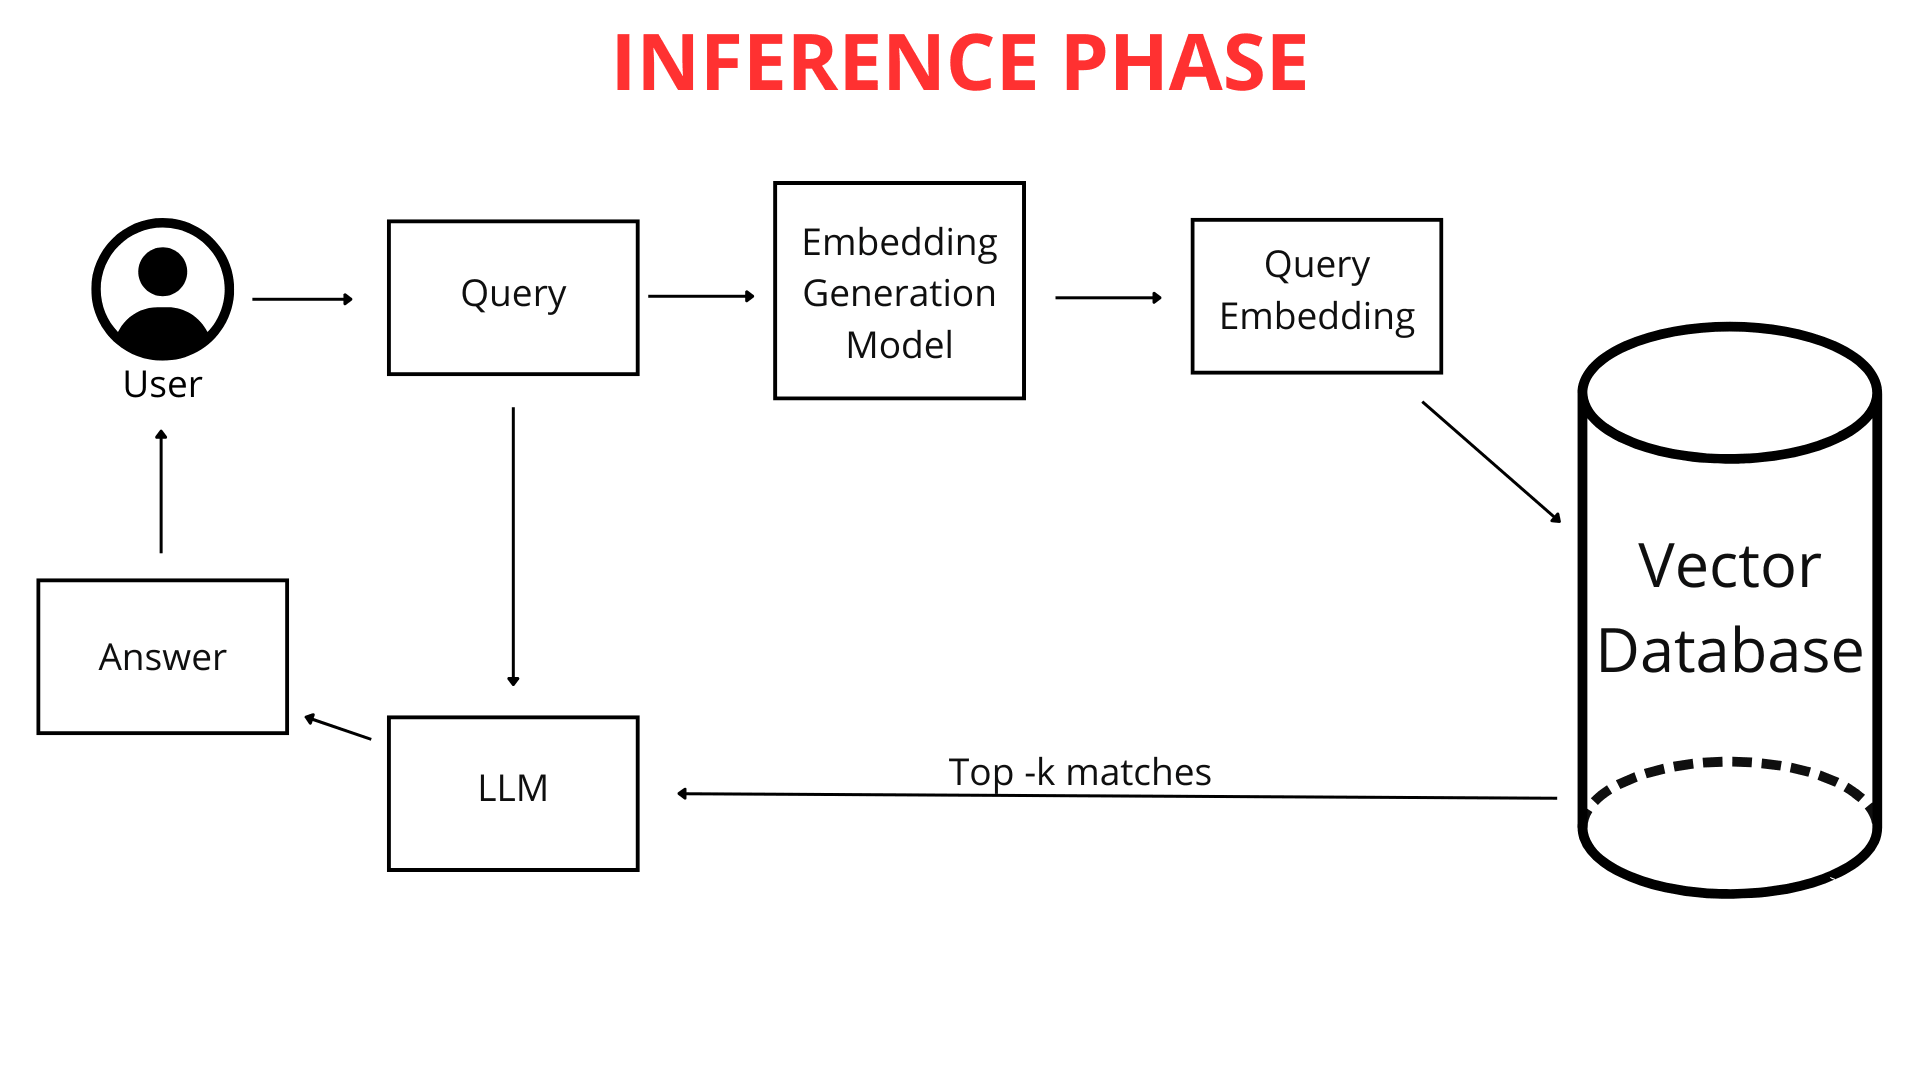
Когато Вие, като потребител, въведете въпрос в чатбота (напр. "Какво е времето в Краков утре?"), той не се сравнява директно със знанията на чатбота в необработен текстов формат. Първо въпросът се картографира в числов вектор. Тъй като и Вашият въпрос, и цялата база от знания на чатбота са представени в един и същ формат - като векторни карти (списъци от числа) - чатботът може ефективно да ги сравни. Той идентифицира фрагментите от своите знания, които са най-тясно свързани с вектора на Вашето запитване, което му позволява да генерира възможно най-добрия отговор.
RAG се включва в действие
Тук технологията RAG играе ключова роля. Системата RAG анализира векторното представяне на Вашето запитване и го използва, за да търси във векторната база данни числовите списъци, най-близки до него (най-близко разположени в многомерното пространство). Тези най-сходни вектори сочат към оригиналните файлови фрагменти, които са най-подходящи за Вашия въпрос.
RAG действа като интелигентен "мост" между Вашето запитване и богатата база от знания на чатбота. Тя позволява динамично извличане само на онази информация, която е най-необходима на големия езиков модел (LLM), за да формулира отговор. LLM, просто казано, е усъвършенстван алгоритъм и набор от данни, обучен върху огромни количества текст, способен да разбира и генерира естествен език. За да научите повече за тази технология, вижте как всъщност работи ChatGPT. Моделите от типа LLM могат да отговарят на въпроси и дори да създават разнообразно съдържание.
Без RAG моделът би трябвало да разчита единствено на вградените си знания, които може да не включват конкретни детайли от Вашите файлове или да са остарели. Благодарение на RAG чатботът придобива способността да черпи допълнителни външни знания точно в момента, в който задавате въпрос. Тези актуални знания идват директно от качените от Вас файлове и уеб страници, които са преминали през необходимата обработка.
Разликата между чатбот със и без RAG
Основната разлика се състои в начина на достъп до знанията.
Знания от обучението (без RAG): Това са "вградените" знания на езиковия модел, придобити по време на интензивно обучение върху огромни масиви от данни преди взаимодействието Ви с ChatLab. Ако попитате за нещо, което не е включено в тези данни, моделът може просто да не знае отговора.
Знания от Вашите файлове (използвани чрез RAG): Това са Вашите уникални, специализирани знания, които предоставяте на чатбота. RAG позволява на чатбота динамично да осъществява достъп до тези знания при отговаряне на въпроси, съчетавайки ги с общите си знания от обучението, за да генерира изчерпателен отговор. Този подход стои в основата на съвременния разговорен AI за обслужване на клиенти.
Аналогия:
Представете си езиковия модел като изключително интелигентен студент, който е прочел безброй книги (данни за обучение) и притежава впечатляваща обща култура. Сега Вие му предоставяте Вашите записки и лекционни материали (Вашите файлове). RAG действа като система, която позволява на този студент бързо да прегледа Вашите записки при отговаряне на въпрос, вместо да разчита единствено на онова, което помни от всички прочетени книги. Това подобрение гарантира по-добри, по-точни и - най-важното - по-актуални отговори.
Благодарение на RAG чатботът може да разшири знанията си с Вашите уникални данни и активно да ги използва при взаимодействията. Той не е ограничен само до това, което е усвоил по време на първоначалното си обучение.
Ето защо RAG е безценен инструмент, когато се нуждаете от чатбот, който да отговаря на въпроси относно Вашата специфична информация - подробности, които не са публично достъпни или са твърде нишови, за да бъдат включени в общите данни за обучение на езиковия модел.
Ако въпросът Ви е: "Къде мога да намеря книги за космоса?", преди "библиотекарят" (чатботът) да започне да "търси по рафтовете", той първо "превежда" въпроса Ви на "езика на рафтовете" - идентифицирайки съответната категория книги. Създаването на векторна карта на Вашия въпрос наподобява каталогизиране на запитването Ви в категории, които чатботът разбира и до които има достъп чрез векторната база данни.
Фаза на обучение и използване на знанията
Както беше обяснено по-рано, Вашият въпрос се преобразува в списък от числа, представляващ неговото значение. След това чатботът търси във векторната база данни за най-сходните вектори, представляващи фрагменти от знания. Колкото по-близки са векторните представяния, толкова по-голямо е сходството между Вашия въпрос и тези фрагменти от знания.
Чатботът избира най-точно съответстващите фрагменти от предварително обработените си знания - тези, чиито вектори са най-близо до векторната карта на Вашия въпрос. Важно е да се отбележи, че при анализ на Вашето запитване ChatLab взема предвид не само самия въпрос, но и контекста на целия разговор до момента. Това позволява на системата RAG по-прецизно да избира най-добрата информация от свързаните източници на знания.
Например, ако първо попитате за "най-новите модели телефони", а след това продължите с "Имат ли добри камери?", чатботът - помнейки контекста на разговора - разбира, че все още имате предвид именно тези конкретни телефони.
Избраните фрагменти от знания се комбинират с Вашия първоначален въпрос и инструкциите от раздела "Role & Behavior". Тези инструкции, известни още като prompt, са нашият персонализиран набор от насоки за чатбота. Ако искаме чатботът винаги да добавя линк към източника в края на отговора си или да поздравява потребителите по определен начин, ние включваме това в prompt-а.
Така се създава обогатено запитване (augmented query), което след това се предава на "мозъка" на чатбота - големия езиков модел (LLM) от OpenAI, Google или други доставчици.
Езиковият модел анализира този комплексен набор от информация: prompt-а, историята на разговорите и знанията, извлечени за потребителското запитване. Освен това LLM използва общите си познания за света, за да генерира отговор. Това прави възможни силно персонализираните клиентски преживявания с AI. Накрая прецизният и завършен отговор се визуализира в изчистения интерфейс на ChatLab.
Обобщение
В тази статия разгледахме архитектурата на RAG системата във функционирането на чатботовете - от въвеждането на данни до генерирането на отговор. RAG е фундаментален компонент на съвременните разговорни системи, позволяващ ефективно използване на външни знания. Компании като ChatLab активно интегрират тази революционна технология в своите продукти, предоставяйки усъвършенствани и интелигентни възможности за взаимодействие на клиентите си.
Въпреки че системата RAG притежава известна техническа сложност, нейното въздействие върху генерирания от изкуствен интелект текст е безспорно. Фактът, че тя успешно се използва от водещи технологични компании като Google, Microsoft и Amazon, подчертава нейната ключова роля в динамичната еволюция на изкуствения интелект.
Готови ли сте да изпитате технологията RAG от първа ръка? Разгледайте функциите на ChatLab или научете как да създадете собствен AI чатбот, захранван от тази технология.


