Hvordan udnytter ChatLab RAG-teknologi?


Hvordan udnytter ChatLab RAG-teknologi?
Hos ChatLab skaber vi intelligente chatbots, der revolutionerer onlineinteraktioner. Den primære drivkraft bag deres evner er en innovativ teknologi kaldet Retrieval-Augmented Generation (RAG). Dette danner grundlaget for vores system og gør det muligt for os at levere løsninger, der rækker langt ud over standard samtaler.
Inden for chatbotverdenen findes der to overordnede træningsmetoder. Ved at forstå de forskellige typer af chatbots bliver det lettere at se, hvordan disse træningstilgange adskiller sig fra hinanden. Den første metode indebærer intensiv træning af komplekse neurale netværk - en proces, der er indviklet, tidskrævende og omkostningstung. Den anden tilgang, som vi med stor succes benytter hos ChatLab, er RAG. Det er ikke blot enklere, mere omkostningseffektivt og hurtigere at implementere, men det giver også vores chatbots adgang til ubegrænsede eksterne informationskilder - såsom dine egne filer. Det giver os mulighed for at generere svar, der er yderst præcise, kontekstbevidste og personligt tilpassede.
Læs videre og få et dybere indblik i, hvordan RAG-teknologien driver ChatLab!
Hvad er RAG helt præcist?
For at forstå hvordan vores system fungerer, er det værd at se nærmere på Retrieval-Augmented Generation. Selvom interaktionen med en chatbot kan virke intuitiv fra brugerens perspektiv, giver en forståelse af mekanismerne bagved dig mulighed for fuldt ud at værdsætte dens potentiale.
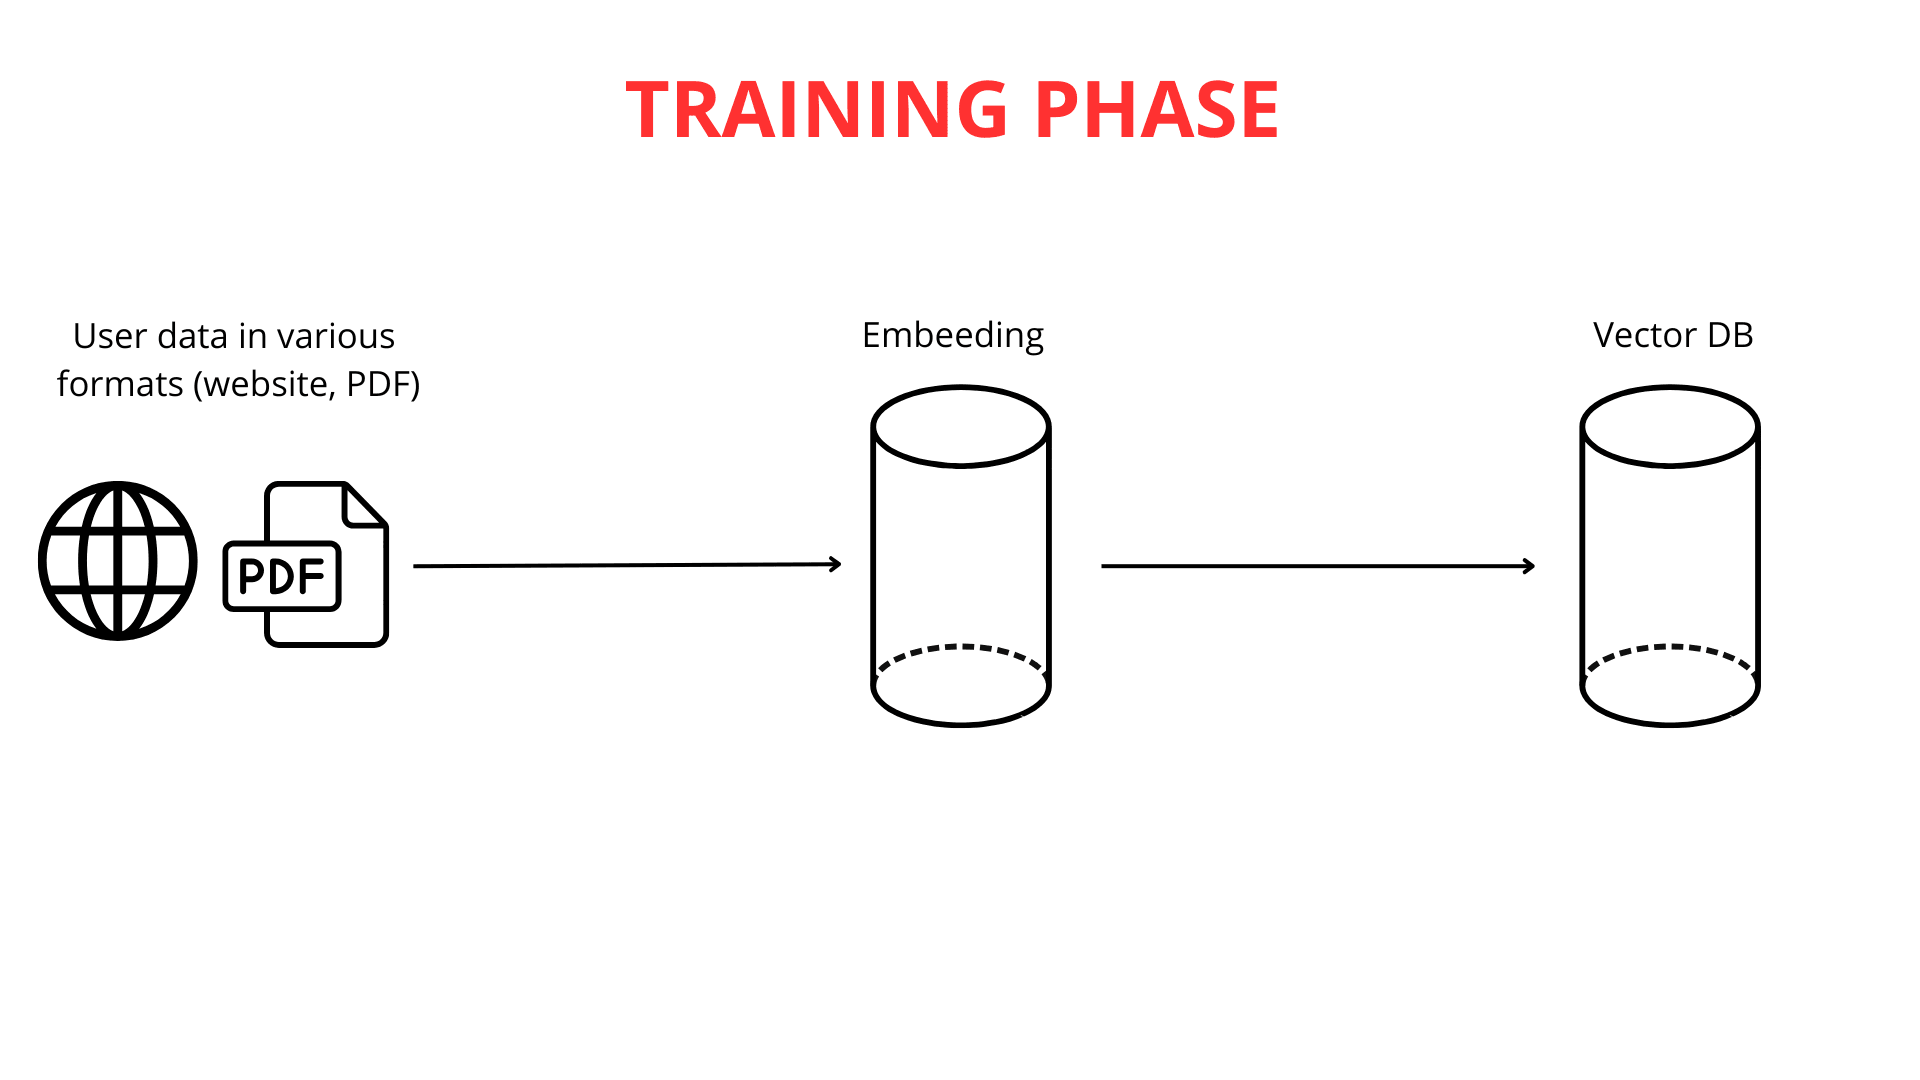
At bygge en intelligent chatbot er en proces med rødder i viden fra flere videnskabelige discipliner. Det første og mest afgørende skridt er at fodre chatbotten med data. Hos ChatLab gør vi dette muligt på flere praktiske måder: ved at uploade hjemmesideindhold, omfattende dokumentation eller endda dine egne PDF-filer. Mulighederne for at tilpasse vidensbasen til dine behov er praktisk talt ubegrænsede.
Det næste trin handler om at opdele lange tekster i mindre bidder (op til 600 tokens hver), hvilket gør det lettere for systemet at behandle oplysningerne effektivt. Når dataene er uploadet og opdelt, begynder vektormappingsprocessen.
Det er vigtigt at understrege, at tekst-til-vektor-mapping er afgørende for RAG's funktionalitet. Kraftfulde store sprogmodeller (LLM) er ansvarlige for at generere disse vektorrepræsentationer.
Vektormappingens rolle i tekstforståelse
Tekstvektorisering handler grundlæggende om at omdanne ord til lister af tal - opbygget på en sådan måde, at ord med lignende betydning får lignende numeriske repræsentationer (vektorer). Dette gør det muligt for vores chatbot at "forstå" sammenhænge mellem forskellige ordsekvenser. For eksempel vil ordene "stor" og "enorm" blive omdannet til meget ens numeriske lister, mens "stor" og "myre" vil få helt forskellige repræsentationer.
Ved at analysere disse numeriske ligheder og forskelle kan chatbotten udlede, at "kat" og "hund" er tættere beslægtede end "kat" og "grøn".
Når vektorerne er genereret, gemmes disse numeriske repræsentationer af viden i en vektordatabase sammen med det oprindelige indhold. Vektordatabasen fungerer som et avanceret katalog over vektoriseret viden, optimeret til hurtig genfinding af relaterede betydninger.
Vektordatabasen: Et intelligent vidensbibliotek
For bedre at forstå hvordan en vektordatabase fungerer, kan vi bruge en analogi med et bibliotek med et smart søgesystem. Hver "bog" (tekstfragment) er "tagget" med en unik vektor (en talrække). Denne kode indeholder adskillige tal, der repræsenterer bogens forfatter, stil og emne. To bøger om lignende emner vil have meget ens koder.
I dette "bibliotek" placeres bøgerne på "hylder" i et flerdimensionelt rum baseret på deres koder. Bøger med lignende koder grupperes tæt sammen - ligesom bøger i samme kategori, men yderligere organiseret efter subtile indholdsmæssige ligheder. Når du stiller et spørgsmål (f.eks. "Hvad er opskriften på chokoladekage?"), bliver det omdannet til en sådan "kode". Det smarte søgesystem i vektordatabasen skanner "hylderne" (tekstfragmenterne) for koder, der matcher din forespørgsels kode mest præcist.
Algoritmen identificerer hurtigt de "bøger" (fragmenter), der mest sandsynligt indeholder svaret. I stedet for at gennemsøge hele "biblioteket" lokaliserer chatbotten øjeblikkeligt de stykker viden, der er mest relevante i forhold til betydning. Dette sikrer hurtigere, mere præcise og kontekstfokuserede svar.
Hvad sker der, når du stiller et spørgsmål?
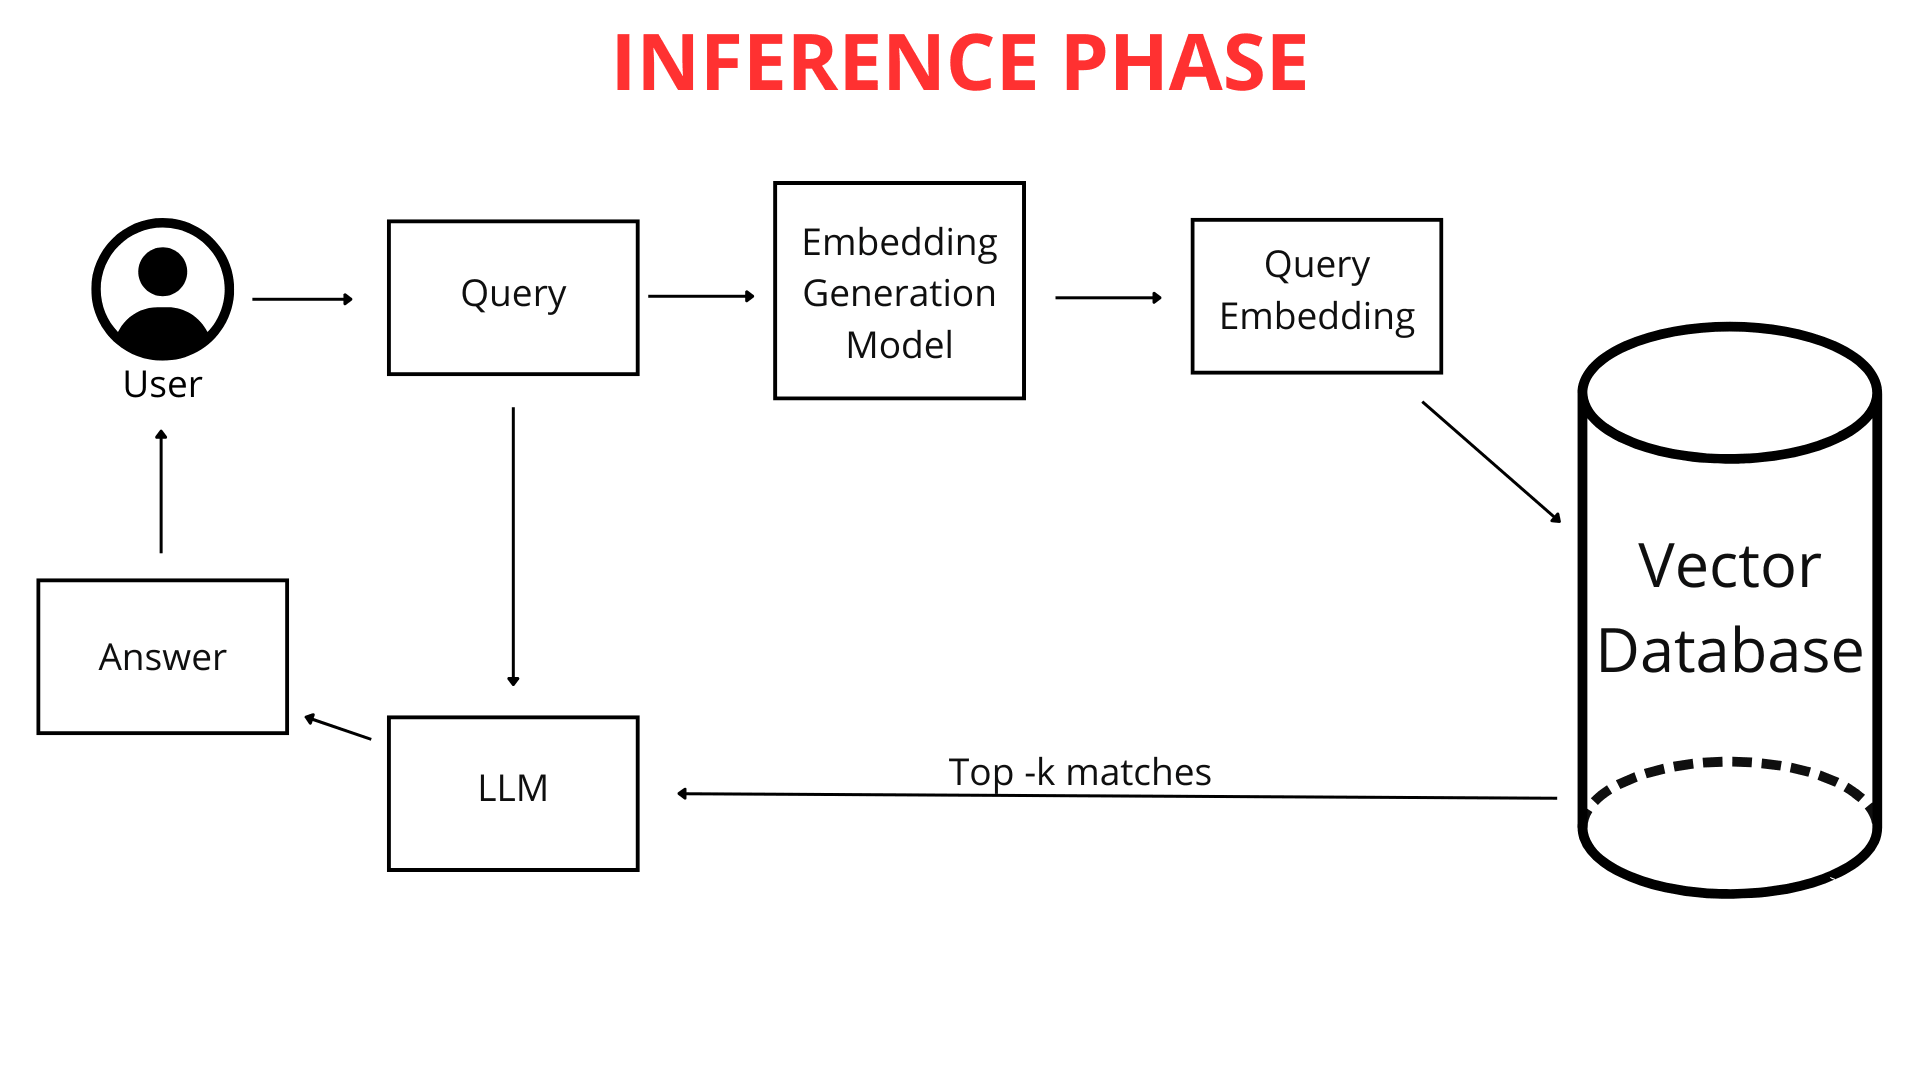
Når du som bruger indtaster et spørgsmål i chatbotten (f.eks. "Hvordan bliver vejret i Krakow i morgen?"), bliver det ikke umiddelbart sammenlignet med chatbottens viden i rå tekstform. Først bliver spørgsmålet mappet til en numerisk vektor. Da både dit spørgsmål og chatbottens samlede vidensbase er repræsenteret i det samme format - som vektormaps (lister af tal) - kan chatbotten effektivt sammenligne dem. Den identificerer de fragmenter af sin viden, der er tættest beslægtede med din forespørgsels vektor, hvilket gør det muligt for den at generere det bedst mulige svar.
RAG træder i funktion
Det er her, RAG-teknologien spiller en afgørende rolle. RAG-systemet analyserer vektorrepræsentationen af din forespørgsel og bruger den til at gennemsøge vektordatabasen efter de numeriske lister, der minder mest om den (tættest på i det flerdimensionelle rum). Disse mest ensartede vektorer peger på de originale filfragmenter, der er mest relevante for dit spørgsmål.
RAG fungerer som en intelligent "bro" mellem din forespørgsel og chatbottens enorme vidensbase. Det muliggør dynamisk genfinding af netop de oplysninger, der er mest nødvendige for, at LLM'en (Large Language Model) kan formulere et svar. En LLM er, enkelt forklaret, en avanceret algoritme og et datasæt trænet på massive mængder tekst, der er i stand til at forstå og generere naturligt sprog. Læs mere om denne teknologi i artiklen om, hvordan ChatGPT rent faktisk fungerer. LLM'er kan besvare spørgsmål og endda skabe forskelligartet indhold.
Uden RAG ville en LLM udelukkende skulle forlade sig på sin indbyggede viden, som måske ikke indeholder specifikke detaljer fra dine filer eller kan være forældet. Takket være RAG opnår chatbotten evnen til at trække på supplerende ekstern viden, netop når du stiller et spørgsmål. Denne opdaterede viden kommer direkte fra dine uploadede filer og websider, som er blevet korrekt behandlet.
Forskellen mellem en chatbot med og uden RAG
Den væsentligste forskel ligger i, hvordan der opnås adgang til viden.
Trænet viden (uden RAG): Dette er LLM'ens "indbyggede" viden, erhvervet under intensiv træning på enorme datasæt forud for din interaktion med ChatLab. Hvis du spørger om noget, der ikke er dækket af disse data, kender modellen måske simpelthen ikke svaret.
Viden fra dine filer (anvendt via RAG): Dette er din unikke, specialiserede viden, som du giver til chatbotten. RAG gør det muligt for chatbotten dynamisk at tilgå denne viden under besvarelsen af spørgsmål og kombinere den med sin generelle træningsviden for at formulere et fyldestgørende svar. Denne tilgang danner grundlag for moderne samtale-AI til kundeservice.
En analogi:
Forestil dig en LLM som en ekstremt intelligent studerende, der har læst utallige bøger (træningsdata) og besidder en imponerende generel viden. Nu forsyner du vedkommende med dine forelæsningsnoter og udleverede materialer (dine filer). RAG fungerer som et system, der lader denne studerende hurtigt tjekke dine noter ved besvarelse af et spørgsmål i stedet for udelukkende at stole på, hvad vedkommende husker fra alle bøgerne. Denne forbedring garanterer bedre, mere præcise og - vigtigst af alt - mere opdaterede svar.
Takket være RAG kan chatbotten udvide sin viden med dine unikke data og aktivt bruge dem i interaktioner. Den er ikke begrænset til kun det, den lærte under sin oprindelige træning.
Derfor er RAG uvurderlig, når du har brug for en chatbot til at besvare spørgsmål om dine specifikke oplysninger - detaljer, der ikke er offentligt tilgængelige eller er for nichespecifikke til at indgå i generelle LLM-træningsdata.
Hvis dit spørgsmål lyder: "Hvor kan jeg finde bøger om rummet?", vil "bibliotekaren" (chatbotten), før denne begynder at "lede på hylderne", først "oversætte" dit spørgsmål til "hyldernes sprog" - og identificere den passende bogkategori. At oprette et vektormap af dit spørgsmål svarer til at katalogisere din forespørgsel i kategorier, som chatbotten forstår og kan tilgå via vektordatabasen.
Trænings- og vidensudnyttelsesfasen
Som forklaret tidligere bliver dit spørgsmål omdannet til en liste af tal, der repræsenterer dets betydning. Chatbotten gennemsøger derefter vektordatabasen efter de mest lignende vektorer, der repræsenterer vidensfragmenter. Jo tættere vektorrepræsentationerne er, desto større er ligheden mellem dit spørgsmål og disse vidensfragmenter.
Chatbotten udvælger de fragmenter af sin forbehandlede viden, der matcher bedst - dem, hvis vektorer ligger tættest på dit spørgsmåls vektormap. Vigtigt er det, at ChatLab ved analysen af din forespørgsel ikke kun ser på selve spørgsmålet, men også på konteksten for hele den hidtidige samtale. Dette gør det muligt for RAG-systemet mere præcist at udvælge de bedste oplysninger fra tilknyttede videnskilder.
Hvis du for eksempel først spørger om "de nyeste telefonmodeller" og derefter følger op med "Har de gode kameraer?", forstår chatbotten - idet den husker samtalens kontekst - at du stadig refererer til netop disse telefoner.
De udvalgte vidensfragmenter kombineres med dit oprindelige spørgsmål og instruktionerne fra sektionen "Role & Behavior". Disse instruktioner, også kendt som prompten, er vores personlige sæt af retningslinjer for chatbotten. Hvis vi ønsker, at chatbotten altid tilføjer et kildelink i slutningen af sit svar eller hilser på brugere på en bestemt måde, inkluderer vi dette i prompten.
Dette skaber en udvidet forespørgsel, som derefter sendes videre til chatbottens "hjerne" - den store sprogmodel (LLM) fra OpenAI, Google eller andre udbydere.
Sprogmodellen analyserer dette samlede sæt af oplysninger: prompten, samtalehistorikken og den viden, der blev hentet frem til brugerens forespørgsel. Derudover trækker LLM'en på sin generelle viden om verden til at generere et svar. Dette muliggør yderst personaliserede kundeoplevelser med AI. Til sidst præsenteres det gennemarbejdede og præcise svar i ChatLabs overskuelige brugerflade.
Opsummering
I denne artikel har vi gennemgået RAG-systemets arkitektur i forbindelse med chatbotters funktion - fra dataindtastning til svargenerering. RAG er en grundlæggende bestanddel i moderne samtalesystemer, der muliggør effektiv udnyttelse af ekstern viden. Virksomheder som ChatLab integrerer aktivt denne banebrydende teknologi i deres produkter og leverer avancerede og intelligente interaktionsmuligheder til kunderne.
Selvom RAG-systemet indeholder en vis teknisk kompleksitet, er dets indvirkning på AI-genereret tekst uomtvistelig. Det faktum, at det anvendes med stor succes af førende tech-virksomheder som Google, Microsoft og Amazon, understreger dets centrale rolle i den dynamiske udvikling af kunstig intelligens.
Klar til at opleve RAG-teknologien på tætteste hold? Udforsk ChatLabs funktioner eller lær hvordan du bygger din egen AI-chatbot drevet af denne teknologi.


