Hur ChatLab använder RAG-teknik?


Hur ChatLab använder RAG-teknik?
På ChatLab skapar vi intelligenta chattbotar som revolutionerar interaktioner online. Den viktigaste drivkraften bakom deras förmåga är en innovativ teknik som kallas Retrieval-Augmented Generation (RAG). Detta utgör grunden för vårt system och gör det möjligt för oss att leverera lösningar som går långt bortom vanliga konversationer.
I chattbotarnas värld finns det två huvudsakliga träningsmetoder. Genom att förstå de olika typerna av chattbotar blir det lättare att se hur dessa träningsmetoder skiljer sig åt. Den första metoden innebär intensiv träning av komplexa neurala nätverk - en process som är invecklad, tidskrävande och kostsam. Det andra tillvägagångssättet, som vi framgångsrikt använder på ChatLab, är RAG. Det är inte bara enklare, mer kostnadseffektivt och snabbare att implementera, utan det ger också våra chattbotar tillgång till obegränsade externa informationskällor - som dina egna filer. Detta gör att vi kan generera svar som är mycket precisa, kontextmedvetna och personliga.
Vi bjuder in dig att läsa vidare och fördjupa dig i hur RAG-teknik driver ChatLab!
Vad är egentligen RAG?
För att förstå hur vårt system fungerar är det värt att titta närmare på Retrieval-Augmented Generation. Även om det kan verka intuitivt att interagera med en chattbot ur en användares perspektiv, gör en förståelse för mekanismerna bakom dess funktion att du till fullo kan uppskatta dess potential.
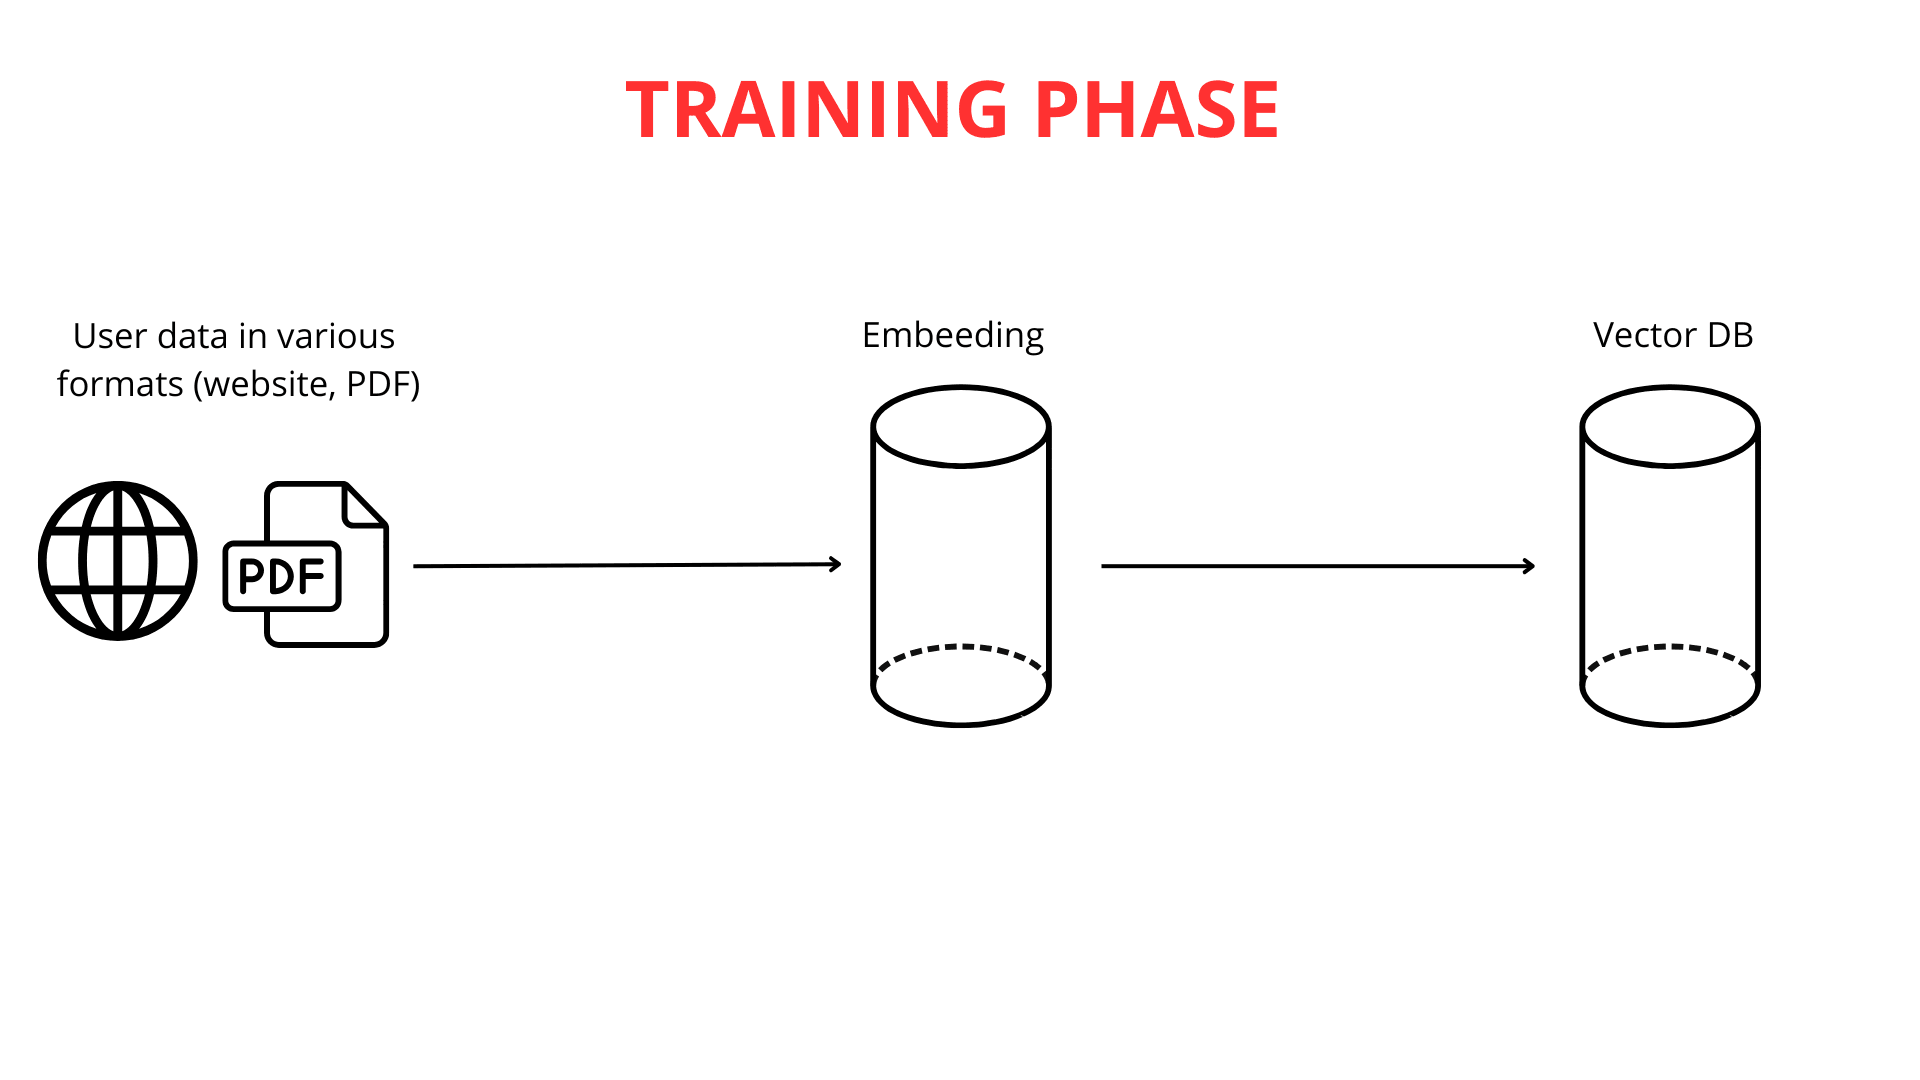
Att bygga en intelligent chattbot är en process med rötter i kunskap från flera vetenskapliga discipliner. Det första och viktigaste steget är att förse chattbotten med data. På ChatLab gör vi detta möjligt på flera smidiga sätt: genom att läsa in webbplatsinnehåll, omfattande dokumentation eller till och med dina egna PDF-filer. Möjligheterna att anpassa kunskapsbasen efter dina behov är praktiskt taget obegränsade.
Nästa steg innebär att dela upp långa texter i mindre delar (upp till 600 tokens vardera), vilket gör det enklare för systemet att bearbeta informationen effektivt. När datan har laddats upp och delats upp börjar processen med vektormappning.
Det är viktigt att betona att mappning från text till vektor är avgörande för RAG:s funktion. Kraftfulla stora språkmodeller (LLM) ansvarar för att generera dessa vektorrepresentationer.
Vektormappningens roll för textförståelse
Vektorisering av text innebär i praktiken att ord omvandlas till listor med siffror - konstruerade på ett sådant sätt att ord med liknande betydelse får liknande numeriska representationer (vektorer). Detta gör att vår chattbot kan "förstå" relationer mellan olika ordsekvenser. Till exempel skulle orden "stor" och "enorm" omvandlas till mycket lika sifferlistor, medan "stor" och "myra" skulle få helt olika representationer.
Genom att analysera dessa numeriska likheter och skillnader kan chattbotten dra slutsatsen att "katt" och "hund" är närmare besläktade än "katt" och "grön".
När vektorerna har genererats lagras dessa numeriska kunskapsrepresentationer i en vektordatabas tillsammans med det ursprungliga innehållet. Vektordatabasen fungerar som en avancerad katalog över vektoriserad kunskap, optimerad för snabb hämtning av relaterade betydelser.
Vektordatabasen: Ett intelligent kunskapsbibliotek
För att bättre förstå hur en vektordatabas fungerar kan vi använda analogin med ett bibliotek med ett smart söksystem. Varje "bok" (textfragment) "taggas" med en unik vektor (en sekvens av siffror). Denna kod innehåller flera siffror som representerar bokens författare, stil och ämne. Två böcker om liknande ämnen kommer att ha mycket lika koder.
I detta "bibliotek" placeras böcker på "hyllor" i ett flerdimensionellt rum baserat på sina koder. Böcker med liknande koder grupperas nära varandra - ungefär som böcker i samma kategori, men ytterligare organiserade efter subtila likheter i innehållet. När du ställer en fråga (t.ex. "Vad är receptet på chokladkaka?"), omvandlas den till en sådan "kod". Det smarta söksystemet i vektordatabasen skannar "hyllorna" (textfragmenten) efter koder som bäst matchar din frågas kod.
Algoritmen identifierar snabbt de "böcker" (fragment) som mest sannolikt innehåller svaret. Istället för att söka igenom hela "biblioteket" lokaliserar chattbotten omedelbart de kunskapsbitar som är mest relevanta ur betydelsesynpunkt. Detta säkerställer snabbare, mer exakta och kontextfokuserade svar.
Vad händer när du ställer en fråga?
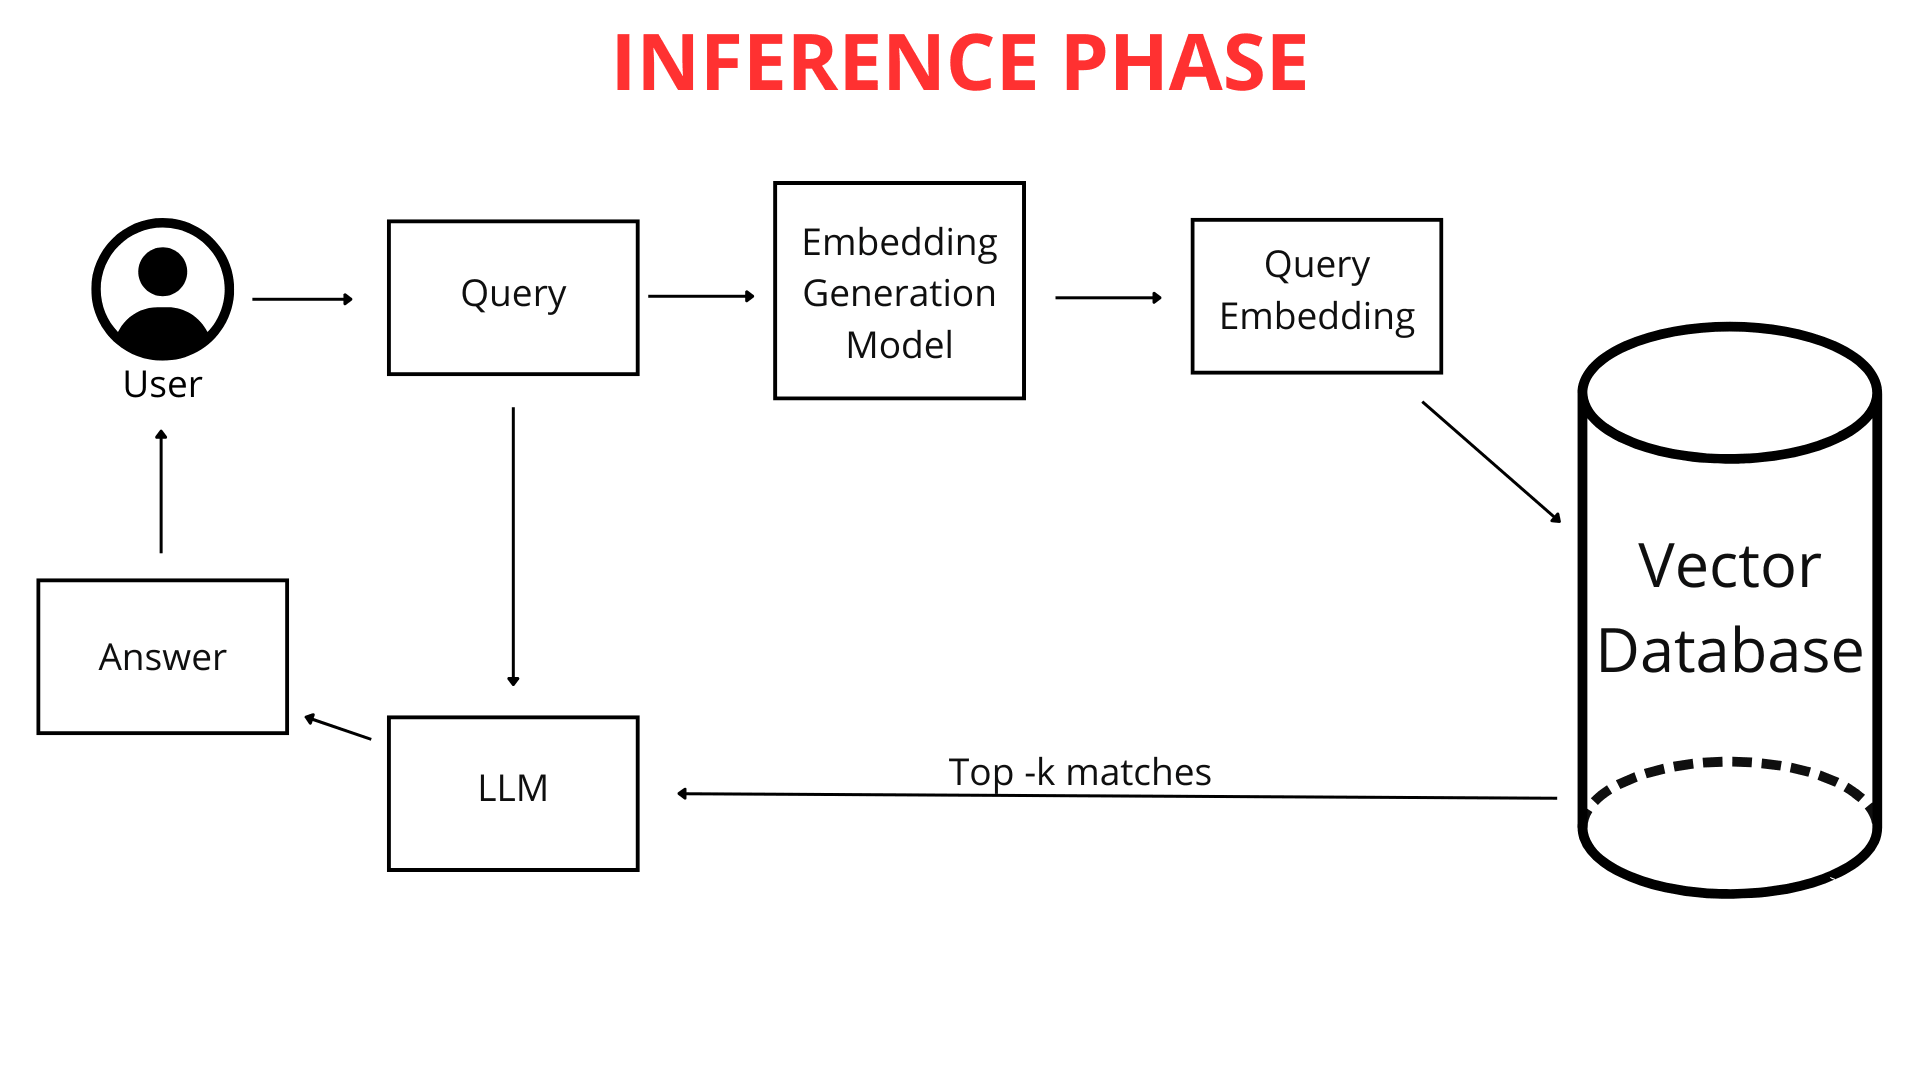
När du som användare skriver en fråga till chattbotten (t.ex. "Hur blir vädret i Krakow imorgon?"), jämförs den inte omedelbart med chattbottens kunskap i form av ren text. Först mappas frågan till en numerisk vektor. Eftersom både din fråga och chattbottens hela kunskapsbas representeras i samma format - som vektorkartor (listor med siffror) - kan chattbotten effektivt jämföra dem. Den identifierar de fragment av sin kunskap som är närmast relaterade till din frågas vektor, vilket gör att den kan generera bästa möjliga svar.
RAG träder i kraft
Det är här RAG-tekniken spelar en avgörande roll. RAG-systemet analyserar vektorrepresentationen av din fråga och använder den för att söka i vektordatabasen efter de sifferlistor som är mest lika den (närmast i det flerdimensionella rummet). Dessa mest likartade vektorer pekar på de ursprungliga filfragment som är mest relevanta för din fråga.
RAG fungerar som en intelligent "brygga" mellan din fråga och chattbottens stora kunskapsbas. Det möjliggör dynamisk hämtning av endast den information som bäst behövs för att den stora språkmodellen (LLM) ska kunna formulera ett svar. En LLM är, enkelt uttryckt, en avancerad algoritm och datamängd som tränats på enorma mängder text och som kan förstå och generera naturligt språk. Om du vill lära dig mer om denna teknik kan du läsa om hur ChatGPT faktiskt fungerar. Språkmodeller kan svara på frågor och till och med skapa varierat innehåll.
Utan RAG skulle en LLM behöva förlita sig enbart på sin inbyggda kunskap, som kanske inte innehåller specifika detaljer från dina filer eller som kan vara föråldrad. Tack vare RAG får chattbotten förmågan att hämta in ytterligare extern kunskap precis när du ställer en fråga. Denna färska kunskap kommer direkt från dina uppladdade filer och webbsidor, som har bearbetats på rätt sätt.
Skillnaden mellan en chattbot med och utan RAG
Den avgörande skillnaden ligger i hur kunskap nås.
Tränad kunskap (utan RAG): Detta är språkmodellens "inbyggda" kunskap, förvärvad under intensiv träning på enorma datamängder innan din interaktion med ChatLab. Om du frågar om något som inte ingick i den informationen vet modellen helt enkelt inte svaret.
Kunskap från dina filer (används via RAG): Detta är din unika, specialiserade kunskap som du förser chattbotten med. RAG gör att chattbotten dynamiskt kan komma åt denna kunskap när den svarar på frågor och kombinera den med sin allmänna träningskunskap för att generera ett heltäckande svar. Detta tillvägagångssätt driver modern konversationell AI för kundservice.
En analogi:
Föreställ dig en LLM som en extremt intelligent student som har läst oräkneliga böcker (träningsdata) och besitter imponerande allmänbildning. Nu ger du personen dina föreläsningsanteckningar och utdelade blad (dina filer). RAG fungerar som ett system som låter studenten snabbt kontrollera dina anteckningar när en fråga ska besvaras, istället för att enbart förlita sig på vad hen minns från alla böcker. Denna förstärkning garanterar bättre, mer precisa och - viktigast av allt - mer aktuella svar.
Tack vare RAG kan chattbotten utöka sin kunskap med dina unika data och aktivt använda den i interaktioner. Den är inte begränsad till enbart det den lärde sig under sin initiala träning.
Det är därför RAG är ovärderligt när du behöver en chattbot som kan svara på frågor om din specifika information - detaljer som inte är offentligt tillgängliga eller är för nischade för att ingå i allmän träningsdata för språkmodeller.
Om din fråga är: "Var kan jag hitta böcker om rymden?", kommer "bibliotekarien" (chattbotten) först att "översätta" din fråga till "hyllornas språk" - och identifiera lämplig bokkategori - innan sökningen på hyllorna börjar. Att skapa en vektorkarta av din fråga är som att katalogisera din fråga i kategorier som chattbotten förstår och kan nå via vektordatabasen.
Fasen för träning och kunskapsanvändning
Som förklarats tidigare omvandlas din fråga till en lista med siffror som representerar dess betydelse. Chattbotten söker sedan i vektordatabasen efter de mest likartade vektorerna som representerar kunskapsfragment. Ju närmare vektorrepresentationerna är, desto större är likheten mellan din fråga och dessa kunskapsfragment.
Chattbotten väljer ut de fragment från sin förbehandlade kunskap som matchar bäst - de vars vektorer ligger närmast din frågas vektorkarta. Viktigt är att ChatLab vid analysen av din fråga inte bara tar hänsyn till själva frågan utan även till kontexten för hela konversationen hittills. Detta gör att RAG-systemet mer precist kan välja ut den bästa informationen från anslutna kunskapskällor.
Om du till exempel först frågar om "de senaste telefonmodellerna" och sedan följer upp med "Har de bra kameror?", förstår chattbotten - tack vare konversationskontexten - att du fortfarande syftar på just dessa telefoner.
De utvalda kunskapsfragmenten kombineras med din ursprungliga fråga och instruktioner från avsnittet "Roll och beteende". Dessa instruktioner, även kända som en prompt, är vår anpassade uppsättning riktlinjer för chattbotten. Om vi vill att chattbotten alltid ska lägga till en källänk i slutet av sitt svar eller hälsa på användare på ett visst sätt, inkluderar vi detta i prompten.
Detta skapar en förstärkt förfrågan (augmented query), som sedan skickas till chattbottens "hjärna" - den stora språkmodellen (LLM) från OpenAI, Google eller andra leverantörer.
Språkmodellen analyserar denna komplexa uppsättning information: prompten, konversationshistoriken och den kunskap som hämtats för användarens fråga. Dessutom utnyttjar språkmodellen sin allmänna omvärldskunskap för att generera ett svar. Detta möjliggör mycket personliga kundupplevelser med AI. Slutligen presenteras det bearbetade och finjusterade svaret i ChatLabs rena gränssnitt.
Sammanfattning
I den här artikeln har vi gått igenom arkitekturen för RAG-systemet i chattbotens funktion - från datainmatning till svarsgenerering. RAG är en grundläggande komponent i moderna konversationssystem som möjliggör effektiv användning av extern kunskap. Företag som ChatLab integrerar aktivt denna banbrytande teknik i sina produkter och levererar avancerade och intelligenta interaktionsmöjligheter till sina kunder.
Även om RAG-systemet har en viss teknisk komplexitet är dess inverkan på AI-genererad text obestridlig. Det faktum att tekniken framgångsrikt används av ledande teknikföretag som Google, Microsoft och Amazon understryker dess avgörande roll i den dynamiska utvecklingen av artificiell intelligens.
Är du redo att uppleva RAG-teknik på nära håll? Utforska ChatLabs funktioner eller läs om hur du bygger din egen AI-chattbot som drivs av denna teknik.


