Jak ChatLab wykorzystuje technologię RAG?


Jak ChatLab wykorzystuje technologię RAG?
W ChatLab tworzymy inteligentne chatboty, które rewolucjonizują interakcje online. Kluczową siłą napędową ich możliwości jest innowacyjna technologia o nazwie Retrieval-Augmented Generation (RAG). Stanowi ona fundament naszego systemu, pozwalając nam dostarczać rozwiązania wykraczające daleko poza standardowe rozmowy.
W świecie chatbotów istnieją dwie główne metody trenowania. Zrozumienie tego, jakie są rodzaje chatbotów, pomaga zobaczyć, czym różnią się te podejścia. Pierwsza metoda polega na intensywnym trenowaniu złożonych sieci neuronowych - procesie skomplikowanym, czasochłonnym i kosztownym. Drugim podejściem, które z powodzeniem stosujemy w ChatLab, jest właśnie RAG. Jest ono nie tylko prostsze, bardziej opłacalne i szybsze we wdrożeniu, ale daje też naszym chatbotom dostęp do nieograniczonych zewnętrznych źródeł informacji - takich jak Twoje własne pliki. Dzięki temu możemy generować odpowiedzi wyjątkowo precyzyjne, świadome kontekstu i spersonalizowane.
Zapraszamy do lektury, aby dowiedzieć się więcej o tym, jak technologia RAG napędza ChatLab!
Czym dokładnie jest RAG?
Aby zrozumieć działanie naszego systemu, warto przyjrzeć się bliżej koncepcji Retrieval-Augmented Generation. Choć interakcja z chatbotem wydaje się użytkownikowi intuicyjna, poznanie mechanizmów stojących za jego funkcjonowaniem pozwala w pełni docenić jego potencjał.
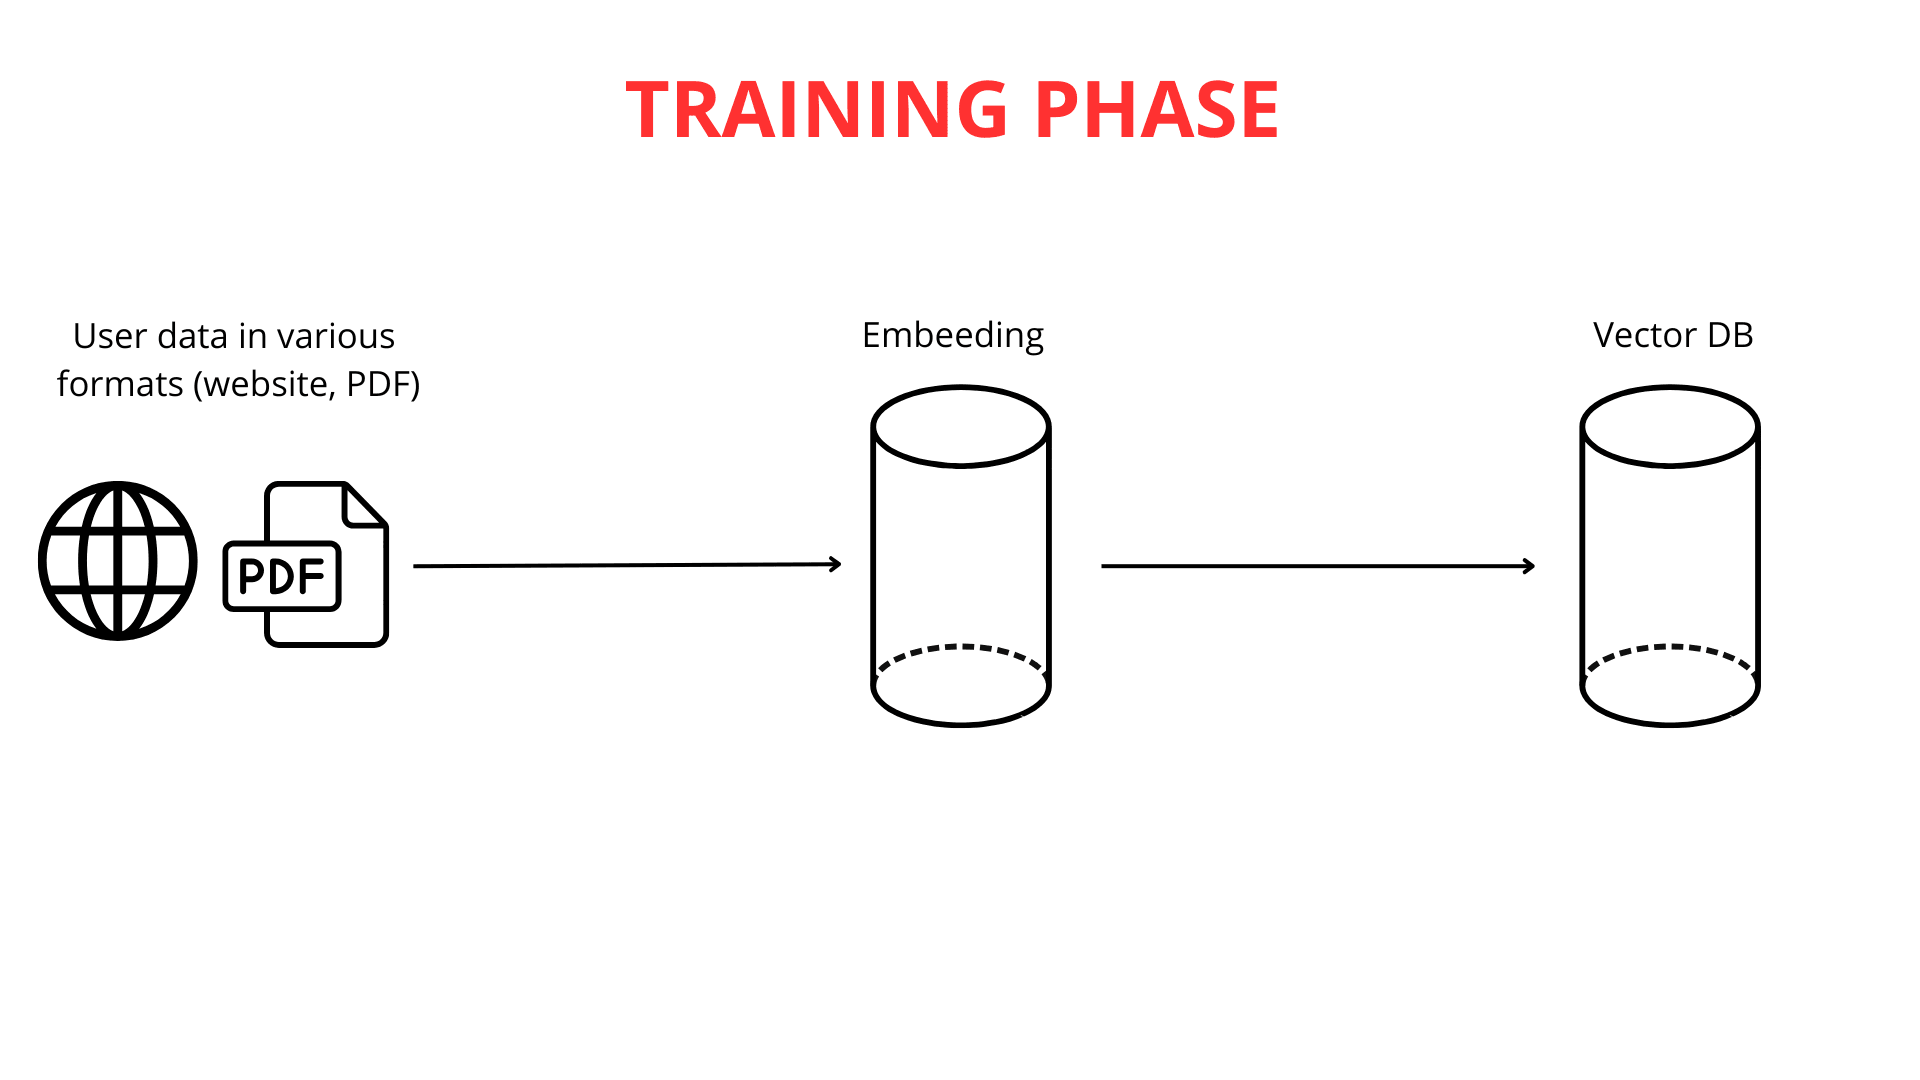
Budowa inteligentnego chatbota to proces oparty na wiedzy z wielu dziedzin nauki. Pierwszym i najważniejszym krokiem jest dostarczenie chatbotowi danych. W ChatLab umożliwiamy to na kilka wygodnych sposobów: poprzez dodanie zawartości strony internetowej, obszernej dokumentacji, a nawet własnych plików PDF. Możliwości dostosowania bazy wiedzy do Twoich potrzeb są praktycznie nieograniczone.
Kolejny etap polega na podzieleniu długich tekstów na mniejsze fragmenty (do 600 tokenów każdy), co ułatwia systemowi efektywne przetwarzanie informacji. Po przesłaniu i posegmentowaniu danych rozpoczyna się proces mapowania wektorowego.
Warto podkreślić, że mapowanie tekstu na wektory ma kluczowe znaczenie dla działania RAG. Za generowanie tych reprezentacji wektorowych odpowiadają potężne silniki dużych modeli językowych (LLM).
Rola mapowania wektorowego w rozumieniu tekstu
Wektoryzacja tekstu to w istocie przekształcanie słów w listy liczb - skonstruowane w taki sposób, że słowa o podobnym znaczeniu otrzymują zbliżone reprezentacje liczbowe (wektory). Pozwala to naszemu chatbotowi "rozumieć" relacje między różnymi ciągami słów. Na przykład słowa "duży" i "ogromny" zostaną przekształcone w bardzo podobne listy liczb, podczas gdy "duży" i "mrówka" otrzymają zupełnie różne reprezentacje.
Analizując te liczbowe podobieństwa i różnice, chatbot może wywnioskować, że "kot" i "pies" są ze sobą bliżej powiązane niż "kot" i "zielony".
Po wygenerowaniu wektorów te liczbowe reprezentacje wiedzy są zapisywane w wektorowej bazie danych wraz z oryginalną treścią. Wektorowa baza danych działa jak zaawansowany katalog zwektoryzowanej wiedzy, zoptymalizowany pod kątem błyskawicznego wyszukiwania powiązanych znaczeń.
Wektorowa baza danych: inteligentna biblioteka wiedzy
Aby lepiej zrozumieć działanie wektorowej bazy danych, posłużmy się analogią biblioteki z inteligentnym systemem wyszukiwania. Każda "książka" (fragment tekstu) jest "oznaczona" unikalnym wektorem (sekwencją liczb). Kod ten zawiera wiele liczb opisujących autora, styl oraz tematykę książki. Dwie książki o podobnej tematyce będą miały bardzo zbliżone kody.
W tej "bibliotece" książki są umieszczane na "półkach" w wielowymiarowej przestrzeni na podstawie swoich kodów. Pozycje o podobnych kodach znajdują się blisko siebie - zupełnie jak książki z tej samej kategorii, dodatkowo uporządkowane według subtelnych podobieństw treści. Kiedy zadajesz pytanie (np. "Jaki jest przepis na ciasto czekoladowe?"), zostaje ono przekształcone w taki właśnie "kod". Inteligentny system wyszukiwania w wektorowej bazie danych skanuje "półki" (fragmenty tekstu) w poszukiwaniu kodów najbardziej zbliżonych do kodu Twojego zapytania.
Algorytm błyskawicznie identyfikuje "książki" (fragmenty), które z największym prawdopodobieństwem zawierają odpowiedź. Zamiast przeszukiwać całą "bibliotekę", chatbot natychmiast wskazuje najtrafniejsze pod względem znaczenia elementy wiedzy. Zapewnia to szybsze, dokładniejsze i ściśle powiązane z kontekstem odpowiedzi.
Co się dzieje, gdy zadajesz pytanie?
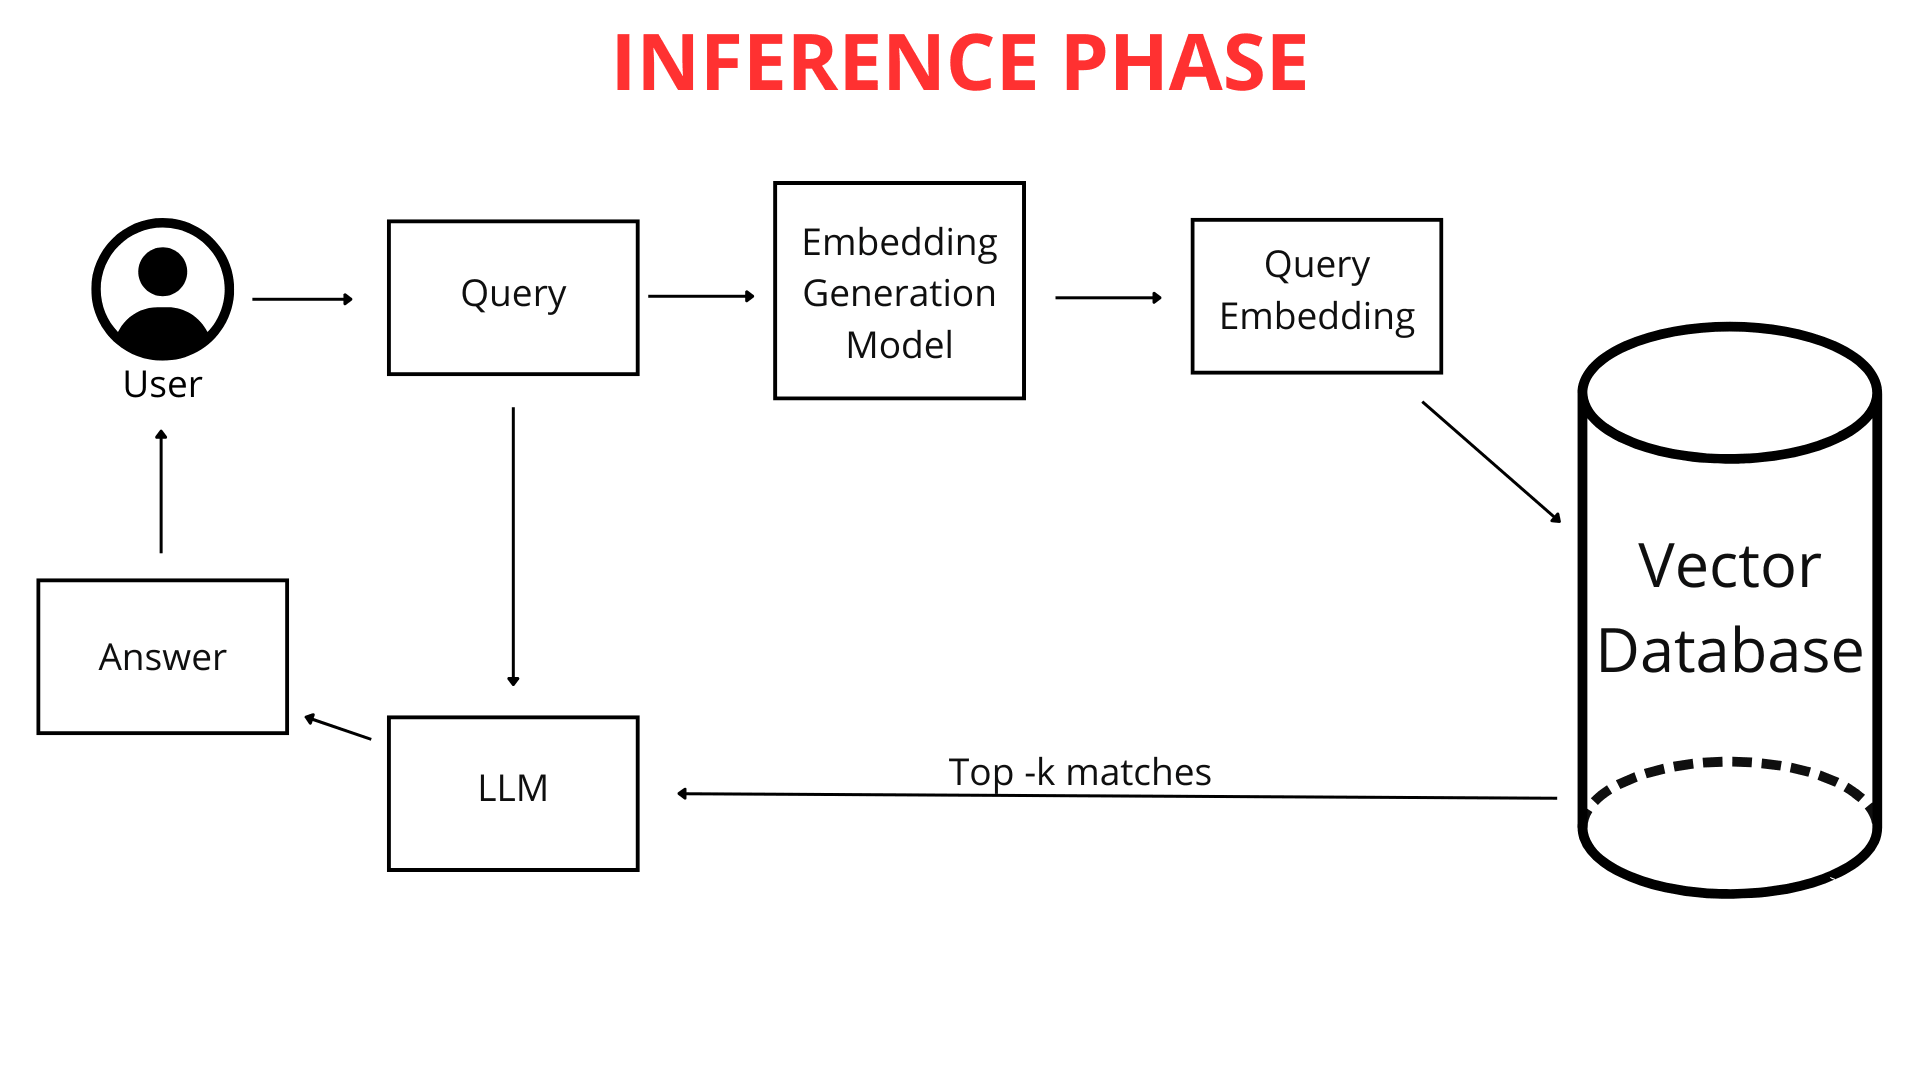
Gdy jako użytkownik wpisujesz pytanie do chatbota (np. "Jaka będzie jutro pogoda w Krakowie?"), nie jest ono od razu porównywane z wiedzą chatbota w postaci surowego tekstu. Najpierw pytanie jest mapowane na wektor liczbowy. Ponieważ zarówno Twoje pytanie, jak i cała baza wiedzy chatbota są reprezentowane w tym samym formacie - jako mapy wektorowe (listy liczb) - chatbot może je sprawnie porównać. Wskazuje fragmenty swojej wiedzy najbardziej zbliżone do wektora Twojego zapytania, co pozwala mu wygenerować najlepszą możliwą odpowiedź.
RAG wkracza do akcji
W tym momencie kluczową rolę odgrywa technologia RAG. System RAG analizuje reprezentację wektorową Twojego zapytania i wykorzystuje ją do przeszukania wektorowej bazy danych w celu znalezienia najbardziej zbliżonych do niej list liczbowych (najbliższych w przestrzeni wielowymiarowej). Te najbardziej podobne wektory wskazują na oryginalne fragmenty plików, które są najistotniejsze dla Twojego pytania.
RAG działa jak inteligentny "pomost" między Twoim zapytaniem a obszerną bazą wiedzy chatbota. Umożliwia dynamiczne pobieranie tylko tych informacji, które są najbardziej potrzebne modelowi LLM (Large Language Model) do sformułowania odpowiedzi. LLM, mówiąc najprościej, to zaawansowany algorytm i zbiór danych wytrenowany na ogromnych ilościach tekstu, zdolny do rozumienia i generowania języka naturalnego. Aby dowiedzieć się więcej o tej technologii, sprawdź, jak właściwie działa ChatGPT. Modele LLM potrafią odpowiadać na pytania, a nawet tworzyć różnorodne treści.
Bez RAG model LLM musiałby polegać wyłącznie na swojej wbudowanej wiedzy, która może nie zawierać szczegółowych informacji z Twoich plików lub być nieaktualna. Dzięki RAG chatbot zyskuje możliwość sięgania po dodatkową, zewnętrzną wiedzę dokładnie wtedy, gdy zadajesz pytanie. Ta świeża wiedza pochodzi bezpośrednio z przesłanych przez Ciebie plików i stron internetowych, które zostały odpowiednio przetworzone.
Różnica między chatbotem z RAG a bez RAG
Kluczowa różnica polega na sposobie dostępu do wiedzy.
Wiedza z treningu (bez RAG): To "wbudowana" wiedza modelu LLM, zdobyta podczas intensywnego trenowania na ogromnych zbiorach danych przed Twoją interakcją z ChatLab. Jeśli zapytasz o coś, czego te dane nie obejmowały, model może po prostu nie znać odpowiedzi.
Wiedza z Twoich plików (wykorzystywana przez RAG): To Twoja unikalna, specjalistyczna wiedza, którą przekazujesz chatbotowi. RAG pozwala chatbotowi na dynamiczny dostęp do tej wiedzy podczas odpowiadania na pytania, łącząc ją z ogólną wiedzą z treningu w celu wygenerowania wyczerpującej odpowiedzi. To podejście napędza nowoczesną konwersacyjną sztuczną inteligencję w obsłudze klienta.
Analogia:
Wyobraź sobie model LLM jako niezwykle inteligentnego studenta, który przeczytał niezliczoną liczbę książek (dane treningowe) i posiada imponującą wiedzę ogólną. Teraz przekazujesz mu swoje notatki z wykładów i materiały (Twoje pliki). RAG działa jak system, który pozwala temu studentowi szybko sprawdzić Twoje notatki podczas odpowiadania na pytanie, zamiast polegać wyłącznie na tym, co pamięta ze wszystkich przeczytanych książek. To usprawnienie gwarantuje lepsze, bardziej precyzyjne i - co najważniejsze - bardziej aktualne odpowiedzi.
Dzięki RAG chatbot może rozszerzać swoją wiedzę o Twoje unikalne dane i aktywnie z nich korzystać podczas interakcji. Nie jest ograniczony wyłącznie do tego, czego nauczył się podczas wstępnego trenowania.
Właśnie dlatego RAG jest nieoceniony, gdy potrzebujesz chatbota odpowiadającego na pytania o Twoje konkretne informacje - szczegóły, które nie są publicznie dostępne lub są zbyt niszowe, by znaleźć się w ogólnych danych treningowych LLM.
Jeśli Twoje pytanie brzmi: "Gdzie znajdę książki o kosmosie?", zanim "bibliotekarz" (chatbot) zacznie "przeszukanie półek", najpierw "tłumaczy" Twoje pytanie na "język półek" - identyfikując odpowiednią kategorię książek. Utworzenie mapy wektorowej Twojego pytania przypomina skatalogowanie zapytania do kategorii, które chatbot rozumie i do których ma dostęp za pośrednictwem wektorowej bazy danych.
Faza trenowania i wykorzystania wiedzy
Jak wyjaśniliśmy wcześniej, Twoje pytanie jest przekształcane w listę liczb reprezentującą jego znaczenie. Następnie chatbot przeszukuje wektorową bazę danych w poszukiwaniu najbardziej podobnych wektorów reprezentujących fragmenty wiedzy. Im bliższe są reprezentacje wektorowe, tym większe podobieństwo między Twoim pytaniem a danymi fragmentami wiedzy.
Chatbot wybiera najbardziej pasujące fragmenty swojej wstępnie przetworzonej wiedzy - te, których wektory znajdują się najbliżej mapy wektorowej Twojego pytania. Co ważne, analizując zapytanie, ChatLab bierze pod uwagę nie tylko samo pytanie, ale także kontekst całej dotychczasowej rozmowy. Pozwala to systemowi RAG jeszcze precyzyjniej dobierać najlepsze informacje z podłączonych źródeł wiedzy.
Na przykład, jeśli najpierw zapytasz o "najnowsze modele telefonów", a potem dodasz "Czy mają dobre aparaty?", chatbot - pamiętając kontekst rozmowy - zrozumie, że wciąż masz na myśli te konkretne telefony.
Wybrane fragmenty wiedzy są łączone z Twoim pierwotnym pytaniem oraz instrukcjami z sekcji "Role & Behavior". Instrukcje te, znane również jako prompt, to nasz spersonalizowany zestaw wytycznych dla chatbota. Jeśli chcemy, aby chatbot zawsze dodawał link do źródła na końcu swojej odpowiedzi lub witał użytkowników w określony sposób, zawieramy to właśnie w prompcie.
Tworzy to zapytanie rozszerzone (augmented query), które jest następnie przekazywane do "mózgu" chatbota - dużego modelu językowego (LLM) od OpenAI, Google lub innych dostawców.
Model językowy analizuje ten złożony zestaw informacji: prompt, historię rozmowy oraz wiedzę pobraną dla zapytania użytkownika. Dodatkowo LLM wykorzystuje swoją ogólną wiedzę o świecie, aby wygenerować odpowiedź. Umożliwia to wysoce spersonalizowane doświadczenia klientów dzięki AI. Na koniec dopracowana i przejrzysta odpowiedź pojawia się w minimalistycznym interfejsie ChatLab.
Podsumowanie
W tym artykule omówiliśmy architekturę systemu RAG w działaniu chatbotów - od wprowadzenia danych po wygenerowanie odpowiedzi. RAG to fundamentalny element nowoczesnych systemów konwersacyjnych, umożliwiający efektywne wykorzystanie wiedzy zewnętrznej. Firmy takie jak ChatLab aktywnie integrują tę przełomową technologię ze swoimi produktami, zapewniając klientom zaawansowane i inteligentne możliwości interakcji.
Choć system RAG wiąże się z pewną złożonością techniczną, jego wpływ na tekst generowany przez AI jest niezaprzeczalny. Fakt, że z powodzeniem korzystają z niego wiodące firmy technologiczne, takie jak Google, Microsoft czy Amazon, tylko podkreśla jego kluczową rolę w dynamicznym rozwoju sztucznej inteligencji.
Chcesz poznać technologię RAG w praktyce? Odkryj funkcje ChatLab lub dowiedz się, jak zbudować własnego chatbota AI opartego na tej technologii.


