Hoe ChatLab RAG-technologie inzet


Hoe ChatLab RAG-technologie inzet
Bij ChatLab bouwen we intelligente chatbots die online interacties transformeren. De drijvende kracht achter hun mogelijkheden is een innovatieve technologie genaamd Retrieval-Augmented Generation (RAG). Dit vormt het fundament van ons systeem, waardoor we oplossingen kunnen bieden die veel verder gaan dan standaardgesprekken.
In de wereld van chatbots bestaan er twee belangrijke trainingsmethoden. Inzicht in de verschillende soorten chatbots helpt je te begrijpen waarin deze trainingsaanpakken verschillen. De eerste methode omvat het intensief trainen van complexe neurale netwerken - een proces dat ingewikkeld, tijdrovend en kostbaar is. De tweede aanpak, die we bij ChatLab met succes toepassen, is RAG. Dit is niet alleen eenvoudiger, kosteneffectiever en sneller te implementeren, maar geeft onze chatbots ook toegang tot onbeperkte externe informatiebronnen - zoals je eigen bestanden. Hierdoor kunnen we antwoorden genereren die uiterst nauwkeurig, contextbewust en gepersonaliseerd zijn.
Lees snel verder om te ontdekken hoe RAG-technologie ChatLab aandrijft!
Wat is RAG precies?
Om te begrijpen hoe ons systeem werkt, is het goed om Retrieval-Augmented Generation van dichterbij te bekijken. Hoewel de interactie met een chatbot vanuit het perspectief van de gebruiker intuïtief aanvoelt, helpt inzicht in de achterliggende mechanismen om het volledige potentieel ervan te benutten.
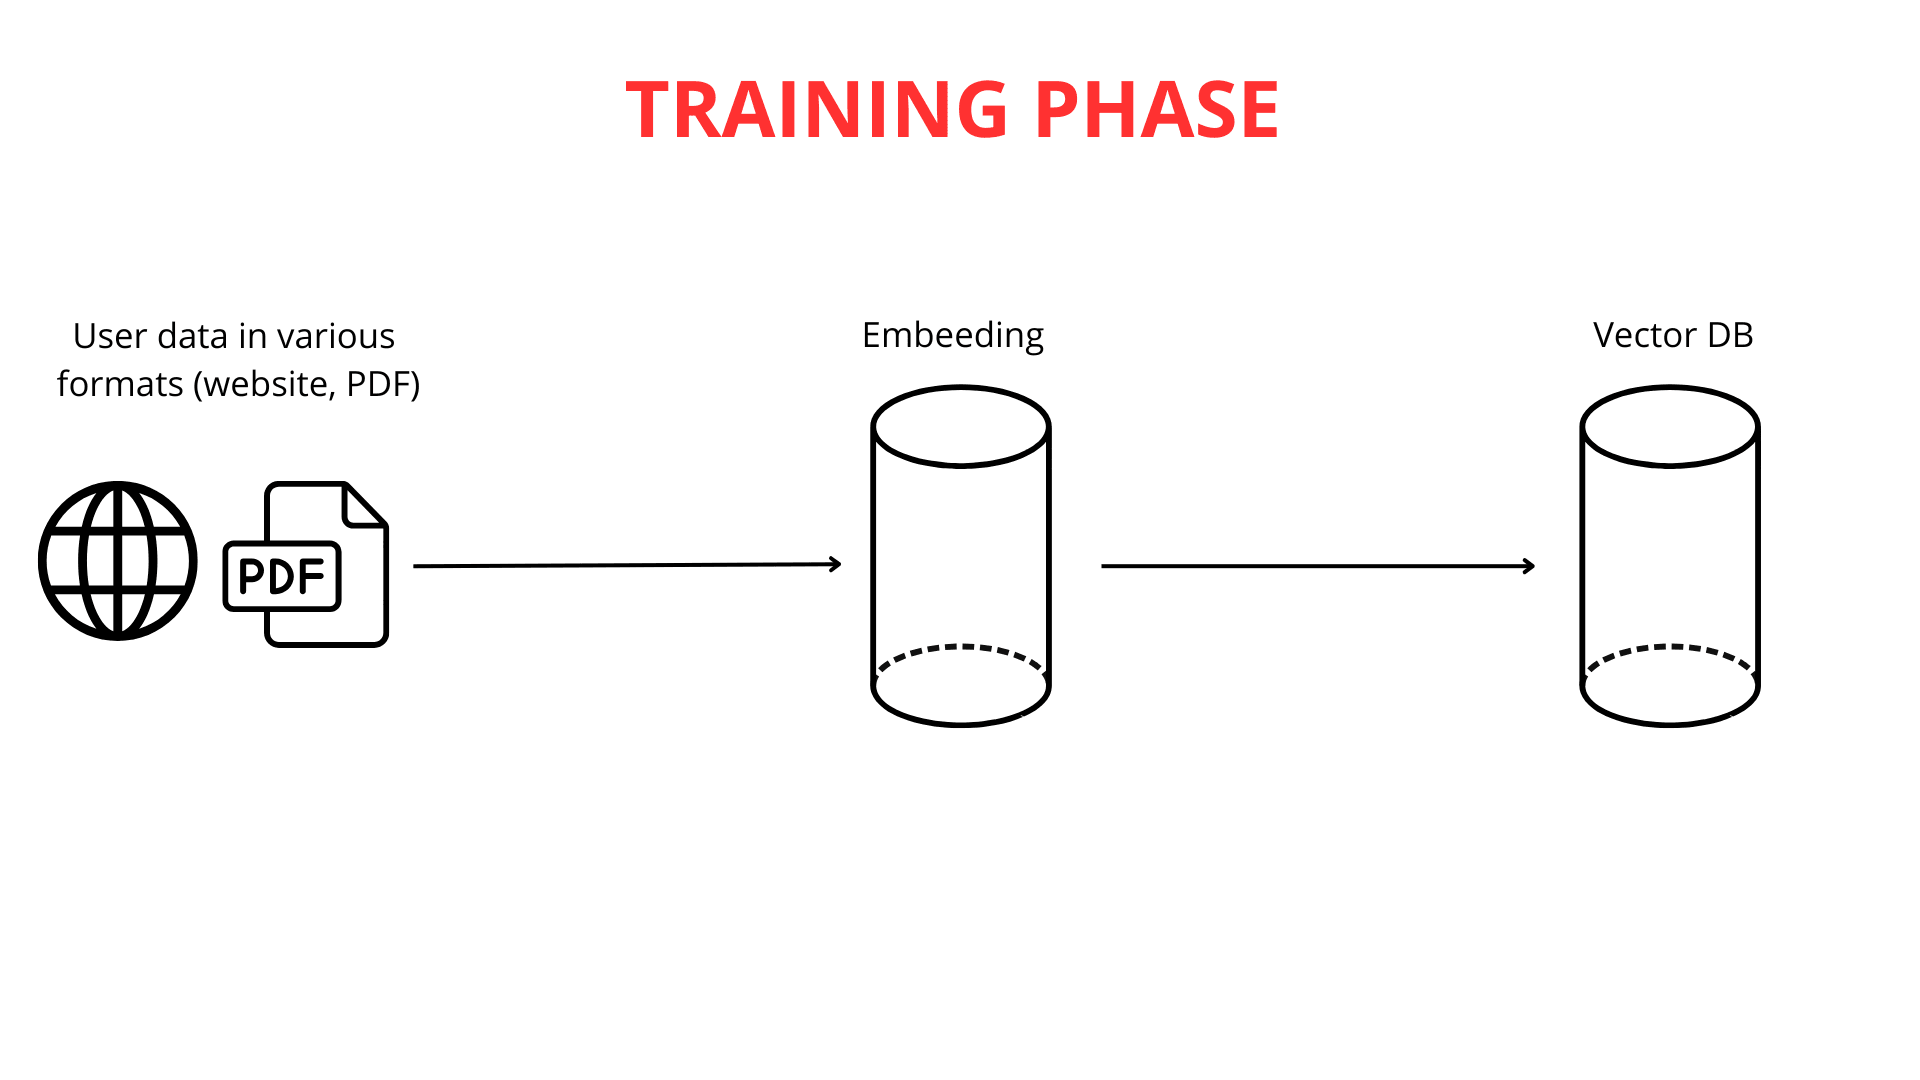
Het bouwen van een intelligente chatbot is een proces dat steunt op kennis uit verschillende wetenschappelijke disciplines. De eerste en belangrijkste stap is de chatbot van data voorzien. Bij ChatLab maken we dit op verschillende handige manieren mogelijk: door websitecontent, uitgebreide documentatie of zelfs je eigen pdf-bestanden te uploaden. De mogelijkheden om de kennisbank aan te passen aan jouw behoeften zijn vrijwel eindeloos.
De volgende fase bestaat uit het opdelen van lange teksten in kleinere fragmenten (chunks van maximaal 600 tokens elk), waardoor het systeem de informatie veel efficiënter kan verwerken. Zodra de data is geüpload en opgedeeld, begint het vector-mappingproces.
Het is belangrijk om te benadrukken dat het omzetten van tekst naar vectoren essentieel is voor de werking van RAG. Krachtige engines van grote taalmodellen (LLM's) zijn verantwoordelijk voor het genereren van deze vectorrepresentaties.
De rol van vector mapping bij tekstbegrip
Tekstvectorisatie is in feite het omzetten van woorden in reeksen getallen - zo opgebouwd dat woorden met een vergelijkbare betekenis ook vergelijkbare numerieke representaties (vectoren) krijgen. Hierdoor kan onze chatbot de verbanden tussen verschillende woordreeksen "begrijpen". De woorden "groot" en "enorm" worden bijvoorbeeld omgezet in sterk op elkaar lijkende getallenreeksen, terwijl "groot" en "mier" juist compleet verschillende representaties krijgen.
Door deze numerieke overeenkomsten en verschillen te analyseren, kan de chatbot afleiden dat "kat" en "hond" sterker aan elkaar verwant zijn dan "kat" en "groen".
Zodra de vectoren zijn gegenereerd, worden deze numerieke representaties van kennis samen met de originele content opgeslagen in een vectordatabase. De vectordatabase fungeert als een geavanceerde catalogus van gevectoriseerde kennis, geoptimaliseerd voor het razendsnel terugvinden van verwante betekenissen.
De vectordatabase: een intelligente kennisbibliotheek
Om beter te begrijpen hoe een vectordatabase werkt, gebruiken we de analogie van een bibliotheek met een slim zoeksysteem. Elk "boek" (tekstfragment) wordt "gelabeld" met een unieke vector (een reeks getallen). Deze code bevat meerdere getallen die de auteur, de stijl en het onderwerp van het boek vertegenwoordigen. Twee boeken over vergelijkbare onderwerpen krijgen vrijwel identieke codes.
In deze "bibliotheek" worden boeken op basis van hun codes op "planken" in een multidimensionale ruimte geplaatst. Boeken met vergelijkbare codes staan dicht bij elkaar - net als boeken in dezelfde categorie, maar dan nog verfijnder geordend op basis van inhoudelijke nuances. Wanneer je een vraag stelt (bijv. "Wat is het recept voor chocoladetaart?"), wordt deze omgezet in zo'n "code". Het slimme zoeksysteem in de vectordatabase scant de "planken" (tekstfragmenten) op zoek naar codes die het dichtst bij de code van jouw vraag liggen.
Het algoritme herkent snel welke "boeken" (fragmenten) hoogstwaarschijnlijk het antwoord bevatten. In plaats van de hele "bibliotheek" te doorzoeken, vindt de chatbot direct de inhoudelijk meest relevante stukjes kennis. Dit zorgt voor snellere, nauwkeurigere en contextgerichtere antwoorden.
Wat gebeurt er als je een vraag stelt?
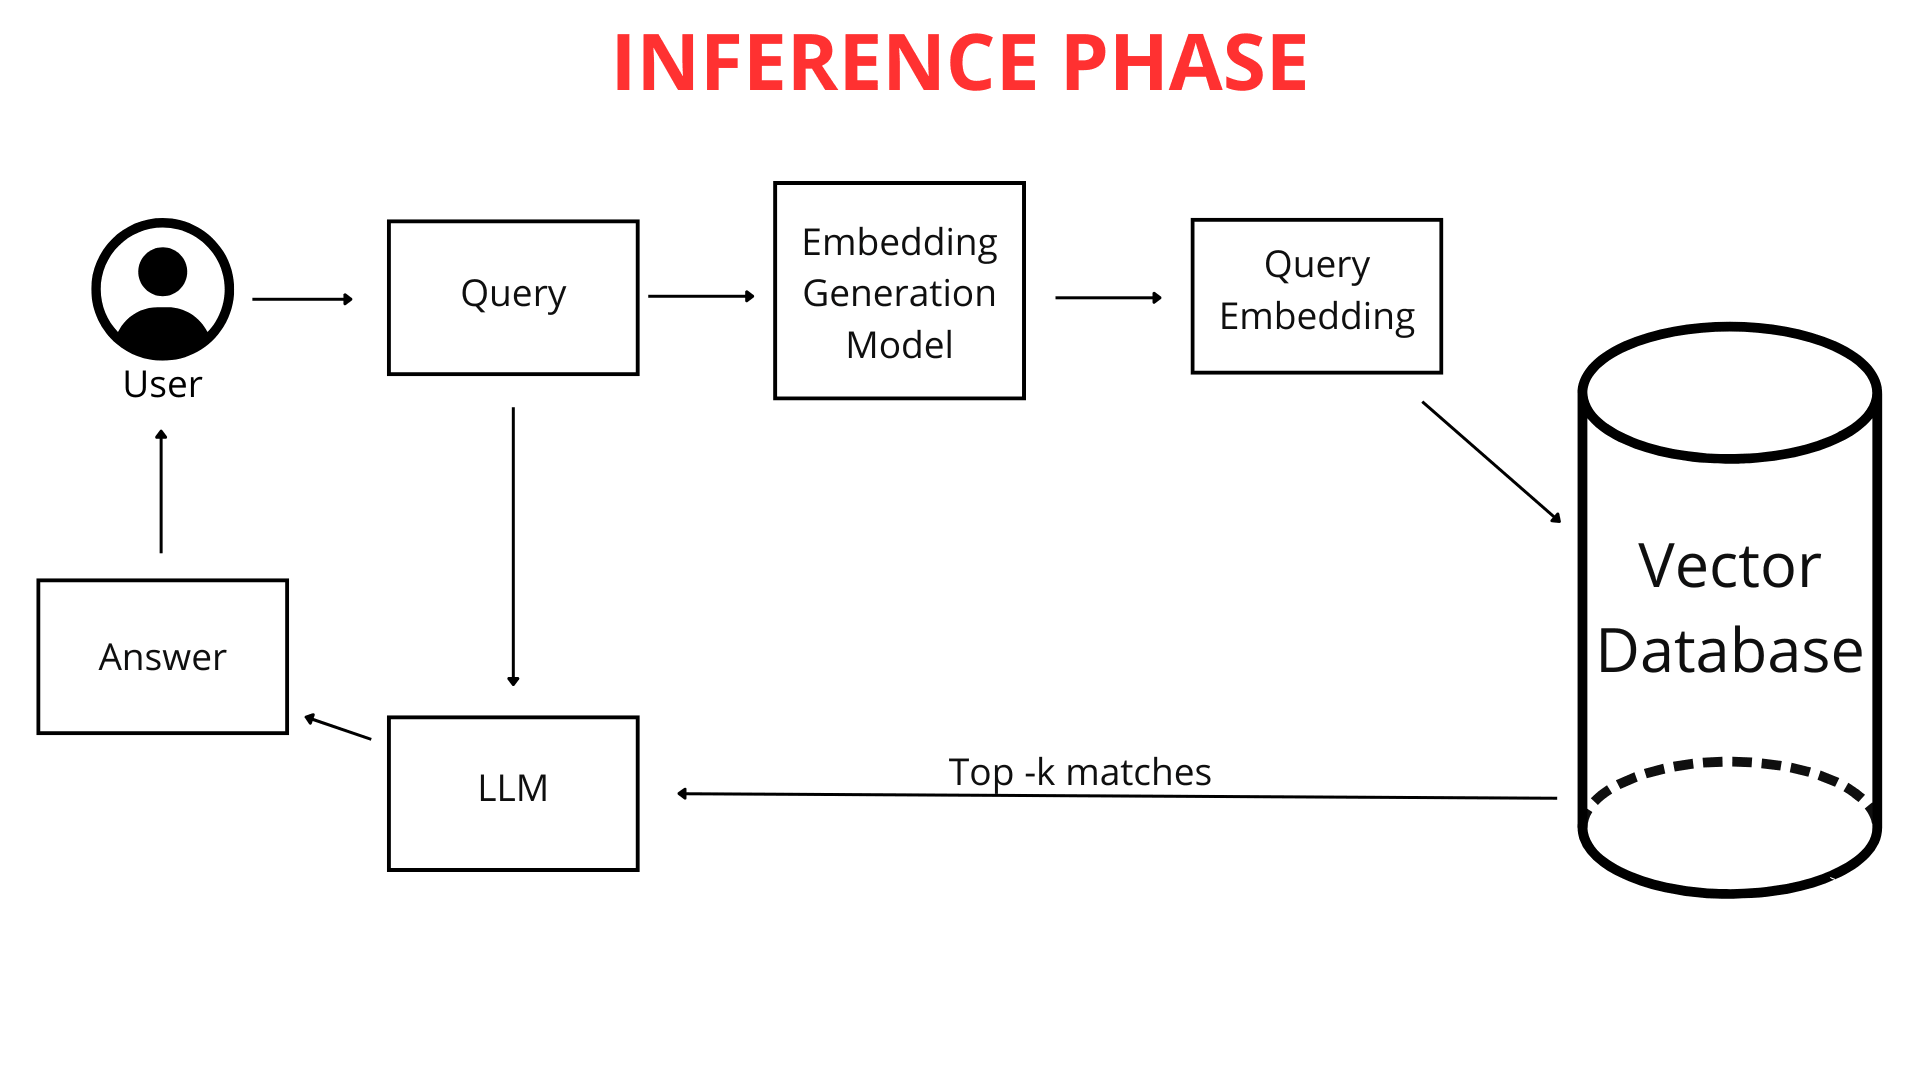
Wanneer je als gebruiker een vraag typt in de chatbot (bijv. "Wat voor weer wordt het morgen in Krakau?"), wordt deze niet direct in ruwe tekstvorm vergeleken met de kennis van de chatbot. Eerst wordt de vraag omgezet in een numerieke vector. Omdat zowel jouw vraag als de volledige kennisbank van de chatbot in hetzelfde format zijn vastgelegd - als vectorkaarten (getallenreeksen) - kan de chatbot ze uiterst efficiënt vergelijken. Het systeem identificeert de kennisfragmenten die het nauwst aansluiten op de vector van jouw vraag, om zo het best mogelijke antwoord te formuleren.
RAG komt in actie
Hier speelt RAG-technologie een doorslaggevende rol. Het RAG-systeem analyseert de vectorrepresentatie van je vraag en gebruikt deze om in de vectordatabase te zoeken naar de numerieke reeksen die hier het meest op lijken (die er in de multidimensionale ruimte het dichtst bij liggen). Deze meest vergelijkbare vectoren verwijzen naar de oorspronkelijke bestandsfragmenten die het meest relevant zijn voor jouw vraag.
RAG fungeert als een intelligente "brug" tussen jouw vraag en de uitgebreide kennisbank van de chatbot. Het maakt het mogelijk om dynamisch alleen díé informatie op te halen die het LLM (Large Language Model) nodig heeft om een antwoord te formuleren. Een LLM is, simpel gezegd, een geavanceerd algoritme met een dataset die getraind is op enorme hoeveelheden tekst, waardoor het natuurlijke taal kan begrijpen en genereren. Wil je meer weten over deze technologie? Lees dan hoe ChatGPT daadwerkelijk werkt. LLM's kunnen vragen beantwoorden en uiteenlopende content creëren.
Zonder RAG zou een LLM volledig moeten vertrouwen op zijn ingebouwde kennis, waarin specifieke details uit jouw bestanden kunnen ontbreken of die verouderd kan zijn. Dankzij RAG kan de chatbot op het exacte moment dat jij een vraag stelt putten uit aanvullende externe kennis. Deze actuele kennis is rechtstreeks afkomstig uit jouw geüploade bestanden en webpagina's, die vooraf zorgvuldig zijn verwerkt.
Het verschil tussen een chatbot met en zonder RAG
Het belangrijkste verschil zit in de manier waarop kennis wordt benaderd.
Getrainde kennis (zonder RAG): Dit is de "ingebouwde" kennis van het LLM, opgedaan tijdens intensieve trainingen op enorme datasets vóór jouw interactie met ChatLab. Als je vraagt naar iets wat niet in die data voorkomt, weet het model simpelweg het antwoord niet.
Kennis uit jouw bestanden (gebruikt via RAG): Dit is jouw unieke, gespecialiseerde kennis die je aan de chatbot toevoegt. RAG stelt de chatbot in staat om deze kennis dynamisch te raadplegen bij het beantwoorden van vragen, en combineert dit met zijn algemene getrainde kennis om een compleet antwoord te geven. Deze aanpak vormt de basis voor moderne conversational AI voor klantenservice.
Een vergelijking:
Stel je een LLM voor als een buitengewoon slimme student die talloze boeken heeft gelezen (trainingsdata) en over een indrukwekkende algemene kennis beschikt. Nu geef je hem jouw eigen collegeaantekeningen en samenvattingen (jouw bestanden). RAG werkt als een systeem waarmee deze student tijdens het beantwoorden van een vraag snel jouw aantekeningen kan raadplegen, in plaats van alleen te vertrouwen op wat hij heeft onthouden uit al die boeken. Deze verrijking garandeert betere, preciezere en - bovenal - actuelere antwoorden.
Dankzij RAG kan de chatbot zijn kennis uitbreiden met jouw unieke data en deze actief inzetten tijdens interacties. Hij is niet langer beperkt tot wat hij tijdens de initiële training heeft geleerd.
Daarom is RAG van onschatbare waarde wanneer je wilt dat een chatbot vragen beantwoordt over jouw specifieke informatie - details die niet openbaar beschikbaar zijn of te specifiek zijn om deel uit te maken van de algemene trainingsdata van een LLM.
Als je vraag luidt: "Waar vind ik boeken over de ruimte?", zal de "bibliothecaris" (de chatbot) je vraag eerst "vertalen" naar de "taal van de planken" voordat hij begint met zoeken - door de juiste boekencategorie te bepalen. Het maken van een vectorkaart van je vraag staat gelijk aan het categoriseren van je zoekopdracht, zodat de chatbot deze begrijpt en kan opzoeken via de vectordatabase.
De fase van training en kennisbenutting
Zoals eerder uitgelegd, wordt je vraag omgezet in een getallenreeks die de betekenis ervan weergeeft. De chatbot zoekt vervolgens in de vectordatabase naar de meest vergelijkbare vectoren die kennisfragmenten vertegenwoordigen. Hoe dichter de vectorrepresentaties bij elkaar liggen, hoe groter de inhoudelijke overeenkomst tussen je vraag en die kennisfragmenten.
De chatbot selecteert de best passende fragmenten uit zijn vooraf verwerkte kennis - de fragmenten waarvan de vectoren het dichtst bij de vectorkaart van jouw vraag liggen. Belangrijk hierbij is dat ChatLab bij het analyseren van je vraag niet alleen naar de losse vraag kijkt, maar ook naar de context van het hele gesprek tot dan toe. Hierdoor kan het RAG-systeem nog gerichter de beste informatie uit de gekoppelde kennisbronnen selecteren.
Vraag je bijvoorbeeld eerst naar "de nieuwste telefoonmodellen" en daarna "Hebben ze goede camera's?", dan begrijpt de chatbot - dankzij de gesprekscontext - dat je nog steeds verwijst naar die specifieke telefoons.
De geselecteerde kennisfragmenten worden gecombineerd met je oorspronkelijke vraag en de instructies uit de sectie "Role & Behavior". Deze instructies, ook wel de prompt genoemd, vormen onze gepersonaliseerde richtlijnen voor de chatbot. Willen we bijvoorbeeld dat de chatbot altijd een bronlink toevoegt aan het einde van zijn antwoord of gebruikers op een specifieke manier begroet, dan leggen we dat vast in de prompt.
Zo ontstaat een verrijkte query (augmented query), die vervolgens wordt doorgestuurd naar het "brein" van de chatbot - het grote taalmodel (LLM) van OpenAI, Google of andere providers.
Het taalmodel analyseert deze complete set aan informatie: de prompt, de gespreksgeschiedenis en de opgehaalde kennis voor de gebruikersvraag. Daarnaast benut het LLM zijn algemene wereldkennis om een antwoord te formuleren. Dit maakt uiterst gepersonaliseerde klantervaringen met AI mogelijk. Tot slot wordt het verfijnde en verzorgde antwoord gepresenteerd in de overzichtelijke interface van ChatLab.
Samenvatting
In dit artikel hebben we de architectuur van het RAG-systeem binnen chatbots doorlopen - van data-invoer tot het genereren van antwoorden. RAG is een essentieel onderdeel van moderne conversatiesystemen en maakt efficiënt gebruik van externe kennisbronnen mogelijk. Bedrijven zoals ChatLab integreren deze baanbrekende technologie actief in hun producten, waarmee ze geavanceerde en intelligente interactiemogelijkheden bieden aan hun klanten.
Hoewel het RAG-systeem technisch complex is, is de positieve impact ervan op door AI gegenereerde teksten overduidelijk. Dat toonaangevende techbedrijven zoals Google, Microsoft en Amazon hier met succes gebruik van maken, onderstreept de cruciale rol van RAG in de snelle evolutie van kunstmatige intelligentie.
Klaar om RAG-technologie zelf te ervaren? Ontdek de functies van ChatLab of leer hoe je je eigen AI-chatbot bouwt op basis van deze technologie.


