Як ChatLab використовує технологію RAG?


Як ChatLab використовує технологію RAG?
У ChatLab ми створюємо інтелектуальних чатботів, які докорінно змінюють онлайн-комунікацію. Ключовою рушійною силою їхніх можливостей є інноваційна технологія під назвою Retrieval-Augmented Generation (RAG). Вона формує фундамент нашої системи, дозволяючи нам надавати рішення, що виходять далеко за межі стандартних розмов.
У світі чатботів існують два основні методи навчання. Розуміння різних типів чатботів допомагає побачити, чим різняться ці підходи до навчання. Перший метод передбачає інтенсивне навчання складних нейронних мереж - процес складний, тривалий і дорогий. Другий підхід, який ми успішно застосовуємо в ChatLab, - це RAG. Він не лише простіший, економічніший і швидший у впровадженні, але й надає нашим чатботам доступ до необмежених зовнішніх джерел інформації - таких як ваші власні файли. Це дозволяє нам генерувати відповіді, які є надзвичайно точними, контекстуальними та персоналізованими.
Запрошуємо вас читати далі, щоб детальніше дізнатися, як технологія RAG забезпечує роботу ChatLab!
Що таке RAG?
Щоб зрозуміти, як працює наша система, варто детальніше розглянути Retrieval-Augmented Generation (генерацію з доповненим пошуком). Хоча взаємодія з чатботом може здаватися інтуїтивно зрозумілою з точки зору користувача, розуміння механізмів його роботи дозволяє повною мірою оцінити його потенціал.
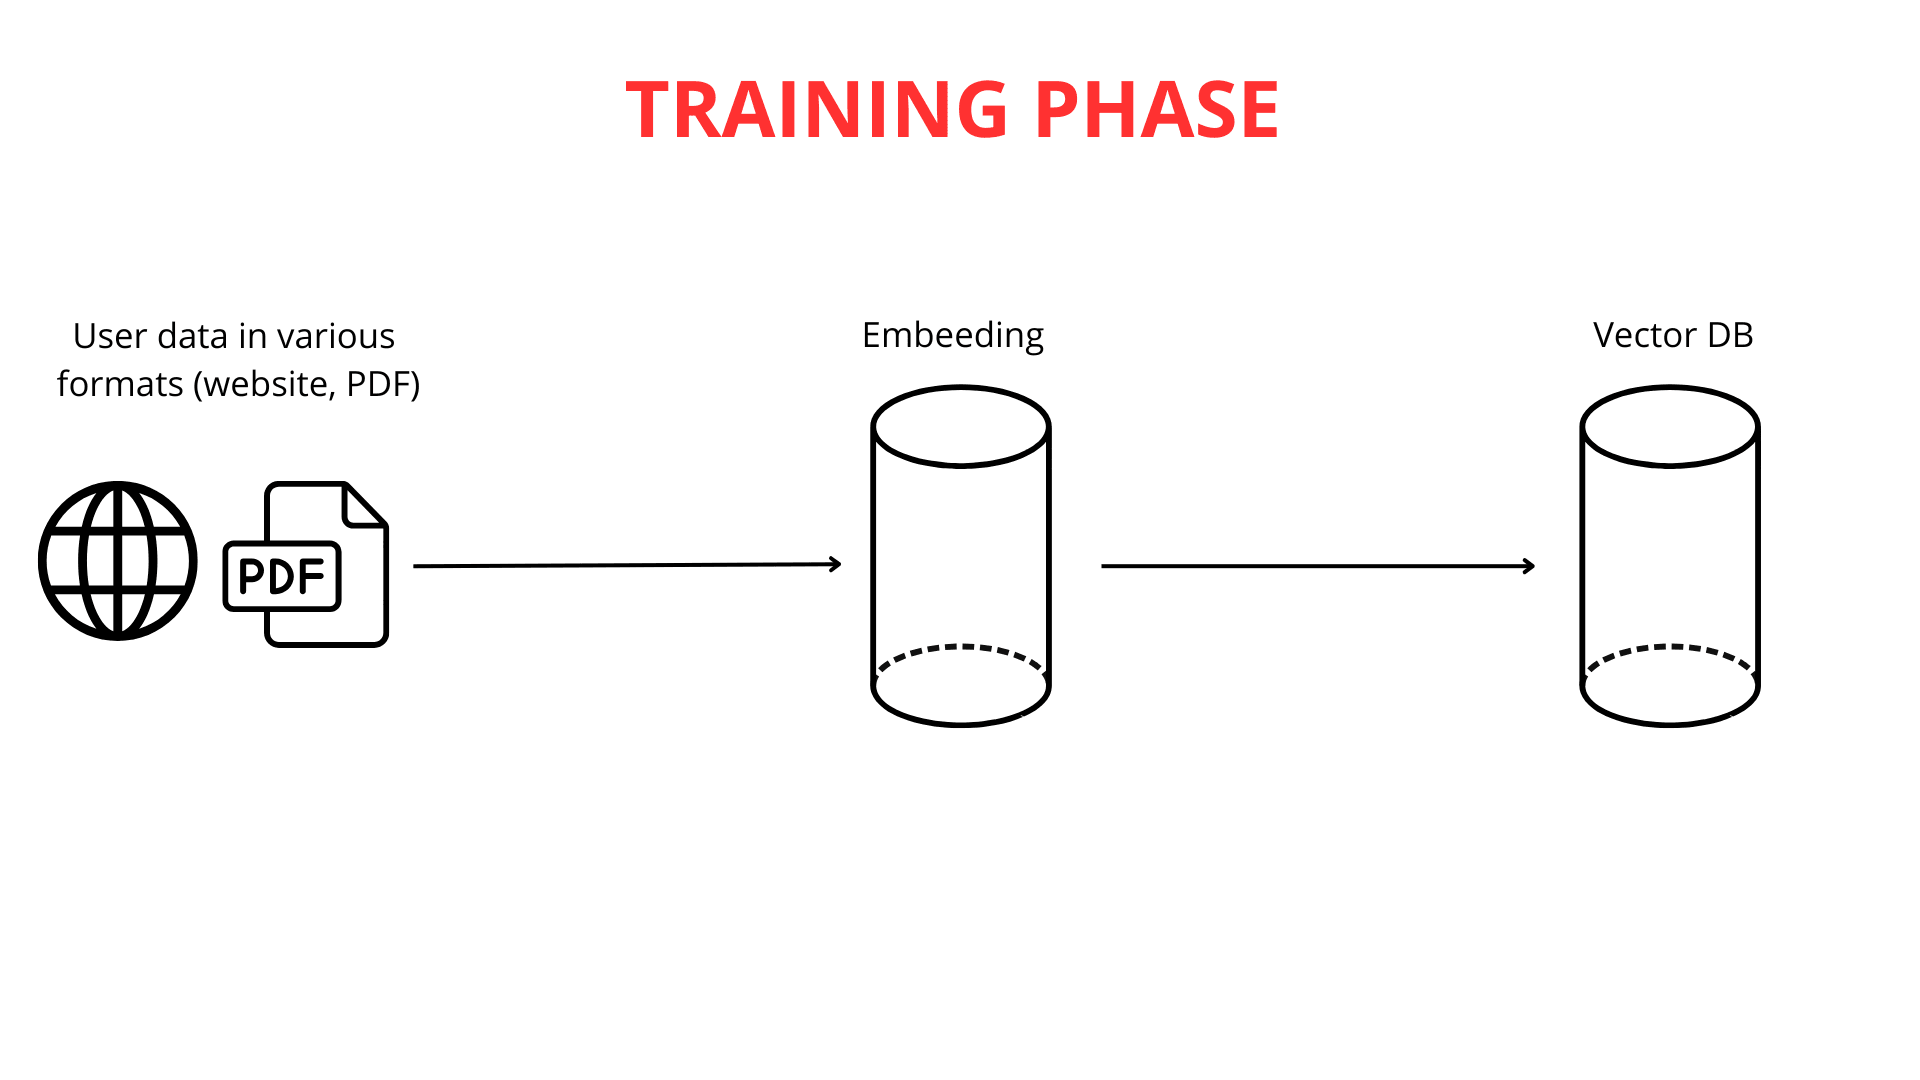
Створення інтелектуального чатбота - це процес, що ґрунтується на знаннях з кількох наукових дисциплін. Перший і найважливіший крок - це наповнення чатбота даними. У ChatLab ми забезпечуємо це кількома зручними способами: завантаженням контенту сайту, великої документації або навіть ваших власних PDF-файлів. Можливості налаштування бази знань під ваші потреби практично безмежні.
Наступний етап передбачає розбиття довгих текстів на менші фрагменти (до 600 токенів кожен), що дозволяє системі ефективно обробляти інформацію. Щойно дані завантажено та сегментовано, починається процес векторного відображення.
Важливо підкреслити, що перетворення тексту на вектори має вирішальне значення для функціональності RAG. За генерацію цих векторних представлень відповідають потужні рушії великих мовних моделей (LLM).
Роль векторного відображення в розумінні тексту
Векторизація тексту - це, по суті, перетворення слів на списки чисел, побудовані таким чином, що слова зі схожим значенням отримують схожі числові представлення (вектори). Це дозволяє нашому чатботу «розуміти» зв'язки між різними послідовностями слів. Наприклад, слова «великий» і «величезний» будуть перетворені на дуже схожі числові списки, тоді як «великий» і «мураха» отримають абсолютно різні представлення.
Аналізуючи ці числові подібності та відмінності, чатбот може зробити висновок, що «кіт» і «собака» пов'язані між собою тісніше, ніж «кіт» і «зелений».
Після генерації векторів ці числові представлення знань зберігаються у векторній базі даних разом з оригінальним контентом. Векторна база даних діє як розширений каталог векторизованих знань, оптимізований для швидкого пошуку пов'язаних за змістом фрагментів.
Векторна база даних: інтелектуальна бібліотека знань
Щоб краще зрозуміти, як працює векторна база даних, скористаймося аналогією бібліотеки з розумною системою пошуку. Кожна «книга» (фрагмент тексту) має свій унікальний вектор (послідовність чисел). Цей код містить набір чисел, що представляють автора, стиль і тематику книги. Дві книги на схожі теми матимуть дуже схожі коди.
У цій «бібліотеці» книги розміщені на «полицях» у багатовимірному просторі відповідно до їхніх кодів. Книги зі схожими кодами групуються поруч - подібно до книг однієї категорії, але додатково організованих за тонкими смисловими ознаками змісту. Коли ви ставите запитання (наприклад: «Який рецепт шоколадного торта?»), воно також перетворюється на такий «код». Розумна система пошуку у векторній базі даних сканує «полиці» (фрагменти тексту) на наявність кодів, що найбільше відповідають коду вашого запиту.
Алгоритм швидко визначає «книги» (фрагменти), які з найбільшою ймовірністю містять відповідь. Замість пошуку по всій «бібліотеці» чатбот миттєво знаходить найактуальніші за змістом фрагменти знань. Це забезпечує швидші, точніші та сфокусовані на контексті відповіді.
Що відбувається, коли ви ставите запитання?
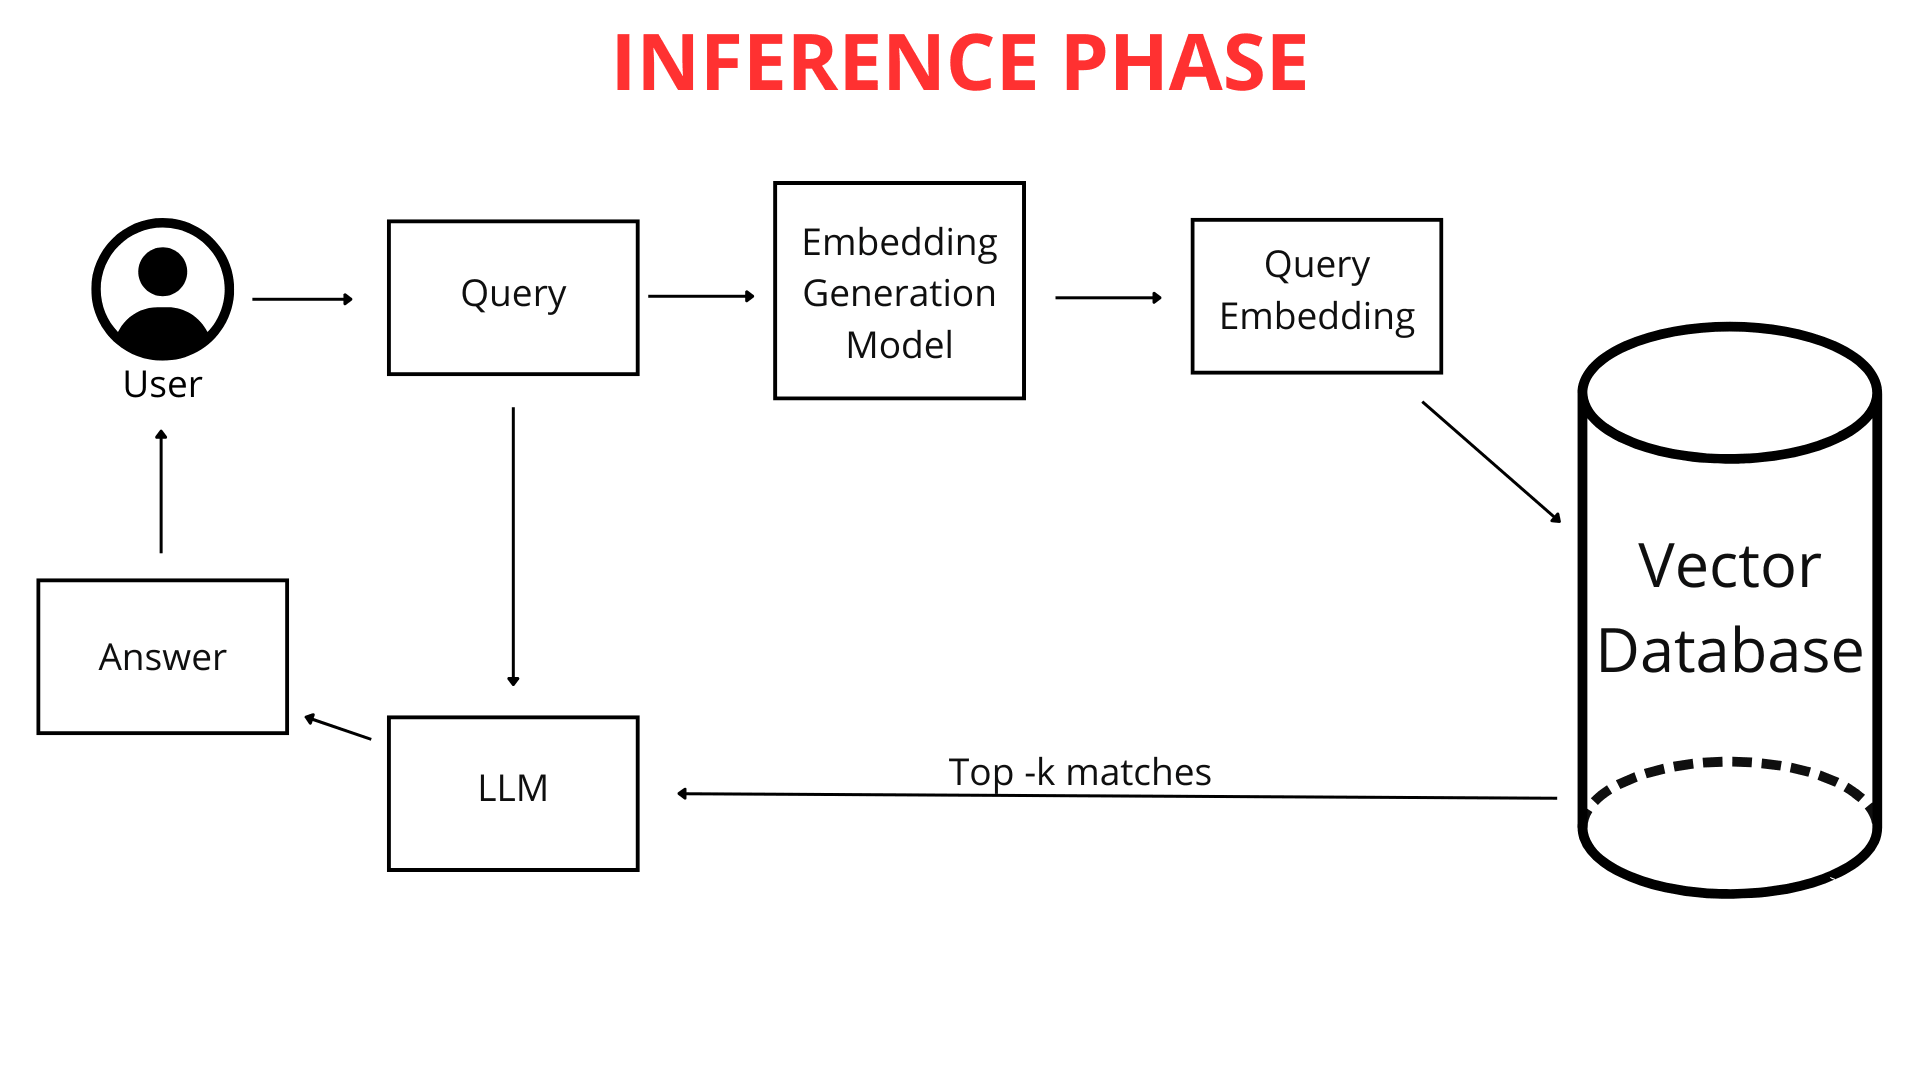
Коли ви, як користувач, вводите запитання чатботу (наприклад: «Яка погода завтра в Кракові?»), воно не зіставляється зі знаннями чатбота безпосередньо у вигляді звичайного тексту. Спочатку запитання перетворюється на числовий вектор. Оскільки і ваше запитання, і вся база знань чатбота представлені в однаковому форматі - у вигляді векторних карт (списків чисел) - чатбот може ефективно їх порівнювати. Він визначає фрагменти своїх знань, найбільш пов'язані з вектором вашого запиту, що дозволяє згенерувати найкращу відповідь.
RAG починає діяти
Саме тут технологія RAG відіграє ключову роль. Система RAG аналізує векторне представлення вашого запиту та використовує його для пошуку у векторній базі даних числових списків, найбільш схожих на нього (найближчих у багатовимірному просторі). Ці найбільш схожі вектори вказують на оригінальні фрагменти файлів, найбільш релевантні вашому запитанню.
RAG працює як розумний «міст» між вашим запитом і великою базою знань чатбота. Вона забезпечує динамічне вилучення лише тієї інформації, яка найбільше потрібна LLM (великій мовній моделі) для формулювання відповіді. LLM, просто кажучи, - це передовий алгоритм і набір даних, навчений на масивах тексту, здатний розуміти та генерувати природну мову. Щоб дізнатися більше про цю технологію, ознайомтеся з тим, як насправді працює ChatGPT. LLM можуть відповідати на запитання і навіть створювати різноманітний контент.
Без RAG мовна модель мусила б покладатися виключно на свої вбудовані знання, які можуть не містити конкретних деталей з ваших файлів або бути застарілими. Завдяки RAG чатбот отримує можливість звертатися до додаткових зовнішніх знань саме в той момент, коли ви ставите запитання. Ці свіжі знання надходять безпосередньо з ваших завантажених файлів і вебсторінок, які були належним чином оброблені.
Різниця між чатботом з RAG і без RAG
Ключова різниця полягає в тому, як здійснюється доступ до знань.
Навчені знання (без RAG): це «вбудовані» знання LLM, отримані під час інтенсивного навчання на величезних масивах даних до вашої взаємодії з ChatLab. Якщо ви запитаєте про те, чого не було в цих даних, модель може просто не знати відповіді.
Знання з ваших файлів (використовуються через RAG): це ваші унікальні, спеціалізовані знання, які ви надаєте чатботу. RAG дозволяє чатботу динамічно звертатися до цих знань під час відповіді на запитання, поєднуючи їх зі своїми загальними базовими знаннями для генерації вичерпної відповіді. Цей підхід забезпечує роботу сучасного розмовного AI для обслуговування клієнтів.
Аналогія:
Уявіть LLM як надзвичайно розумного студента, який прочитав безліч книг (навчальні дані) і має вражаючі загальні знання. Тепер ви даєте йому свої конспекти лекцій і роздаткові матеріали (ваші файли). RAG діє як система, що дозволяє цьому студенту швидко перевірити ваші конспекти під час відповіді на запитання, а не покладатися лише на те, що він пам'ятає з усіх прочитаних книг. Таке доповнення гарантує кращі, точніші та - найголовніше - актуальніші відповіді.
Завдяки RAG чатбот може розширювати свої знання вашими унікальними даними та активно використовувати їх у діалогах. Він не обмежений лише тим, чого навчився під час початкового навчання.
Ось чому RAG незамінна, коли вам потрібно, щоб чатбот відповідав на запитання щодо вашої специфічної інформації - даних, які не є публічними або надто вузькопрофільні, щоб потрапити в загальні дані для навчання LLM.
Якщо ваше запитання: «Де знайти книги про космос?», то перш ніж «бібліотекар» (чатбот) почне «шукати на полицях», він спочатку «перекладає» ваше запитання «мовою полиць» - визначаючи відповідну категорію книг. Створення векторної карти вашого запитання схоже на каталогізацію запиту за категоріями, які чатбот розуміє і до яких може отримати доступ через векторну базу даних.
Етап навчання та використання знань
Як пояснювалося раніше, ваше запитання перетворюється на список чисел, що відображає його зміст. Потім чатбот шукає у векторній базі даних найбільш схожі вектори, що представляють фрагменти знань. Що ближчі векторні представлення, то більша схожість між вашим запитанням і цими фрагментами знань.
Чатбот вибирає найбільш відповідні фрагменти своїх попередньо оброблених знань - ті, чиї вектори знаходяться найближче до векторної карти вашого запитання. Важливо, що під час аналізу запиту ChatLab враховує не лише саме запитання, але й контекст усієї поточної розмови. Це дозволяє системі RAG точніше вибирати найкращу інформацію з підключених джерел знань.
Наприклад, якщо ви спочатку запитаєте про «найновіші моделі телефонів», а потім додасте: «Чи мають вони гарні камери?», чатбот, пам'ятаючи контекст розмови, зрозуміє, що ви все ще маєте на увазі саме ці телефони.
Вибрані фрагменти знань об'єднуються з вашим оригінальним запитанням та інструкціями з розділу «Роль і поведінка» («Role & Behavior»). Ці інструкції, також відомі як промпт, є нашим персоналізованим набором вказівок для чатбота. Якщо ми хочемо, щоб чатбот завжди додавав посилання на джерело в кінці відповіді або вітав користувачів певним чином, ми вказуємо це в промпті.
Це створює доповнений запит, який потім передається до «мозку» чатбота - великої мовної моделі (LLM) від OpenAI, Google чи інших постачальників.
Мовна модель аналізує цей комплексний набір інформації: промпт, історію розмови та знання, отримані за запитом користувача. Крім того, LLM використовує свої загальні знання про світ для генерації відповіді. Це забезпечує високо персоналізований клієнтський досвід за допомогою AI. Зрештою, відшліфована та вивірена відповідь відображається в зрозумілому інтерфейсі ChatLab.
Підсумок
У цій статті ми розглянули архітектуру системи RAG у роботі чатбота - від введення даних до генерації відповіді. RAG є фундаментальним компонентом сучасних розмовних систем, що забезпечує ефективне використання зовнішніх знань. Такі компанії, як ChatLab, активно інтегрують цю проривну технологію у свої продукти, надаючи клієнтам передові можливості інтелектуальної взаємодії.
Хоча система RAG має певну технічну складність, її вплив на згенерований штучним інтелектом текст беззаперечний. Той факт, що її успішно використовують провідні технологічні компанії, такі як Google, Microsoft та Amazon, підкреслює її ключову роль у стрімкому розвитку штучного інтелекту.
Готові випробувати технологію RAG на практиці? Дізнайтеся більше про можливості ChatLab або прочитайте про те, як створити власного AI-чатбота на базі цієї технології.


