¿Cómo aprovecha ChatLab la tecnología RAG?


¿Cómo aprovecha ChatLab la tecnología RAG?
En ChatLab, creamos chatbots inteligentes que revolucionan las interacciones online. El motor clave detrás de sus capacidades es una tecnología innovadora llamada generación aumentada por recuperación (RAG, por sus siglas en inglés). Esta constituye la base de nuestro sistema y nos permite ofrecer soluciones que van mucho más allá de las conversaciones estándar.
En el mundo de los chatbots, existen dos métodos principales de entrenamiento. Entender los diferentes tipos de chatbots te ayuda a ver en qué se diferencian estos enfoques de entrenamiento. El primer método implica el entrenamiento intensivo de redes neuronales complejas - un proceso intrincado, lento y costoso. El segundo enfoque, que empleamos con éxito en ChatLab, es RAG. No solo es más sencillo, económico y rápido de implementar, sino que también otorga a nuestros chatbots acceso a fuentes externas ilimitadas de información - como tus propios archivos. Esto nos permite generar respuestas sumamente precisas, adaptadas al contexto y personalizadas.
¡Te invitamos a seguir leyendo para descubrir más a fondo cómo la tecnología RAG potencia ChatLab!
¿Qué es exactamente RAG?
Para comprender cómo funciona nuestro sistema, vale la pena analizar más de cerca la generación aumentada por recuperación. Aunque interactuar con un chatbot puede parecer intuitivo desde la perspectiva del usuario, entender los mecanismos que hay detrás de su funcionamiento te permite apreciar todo su potencial.
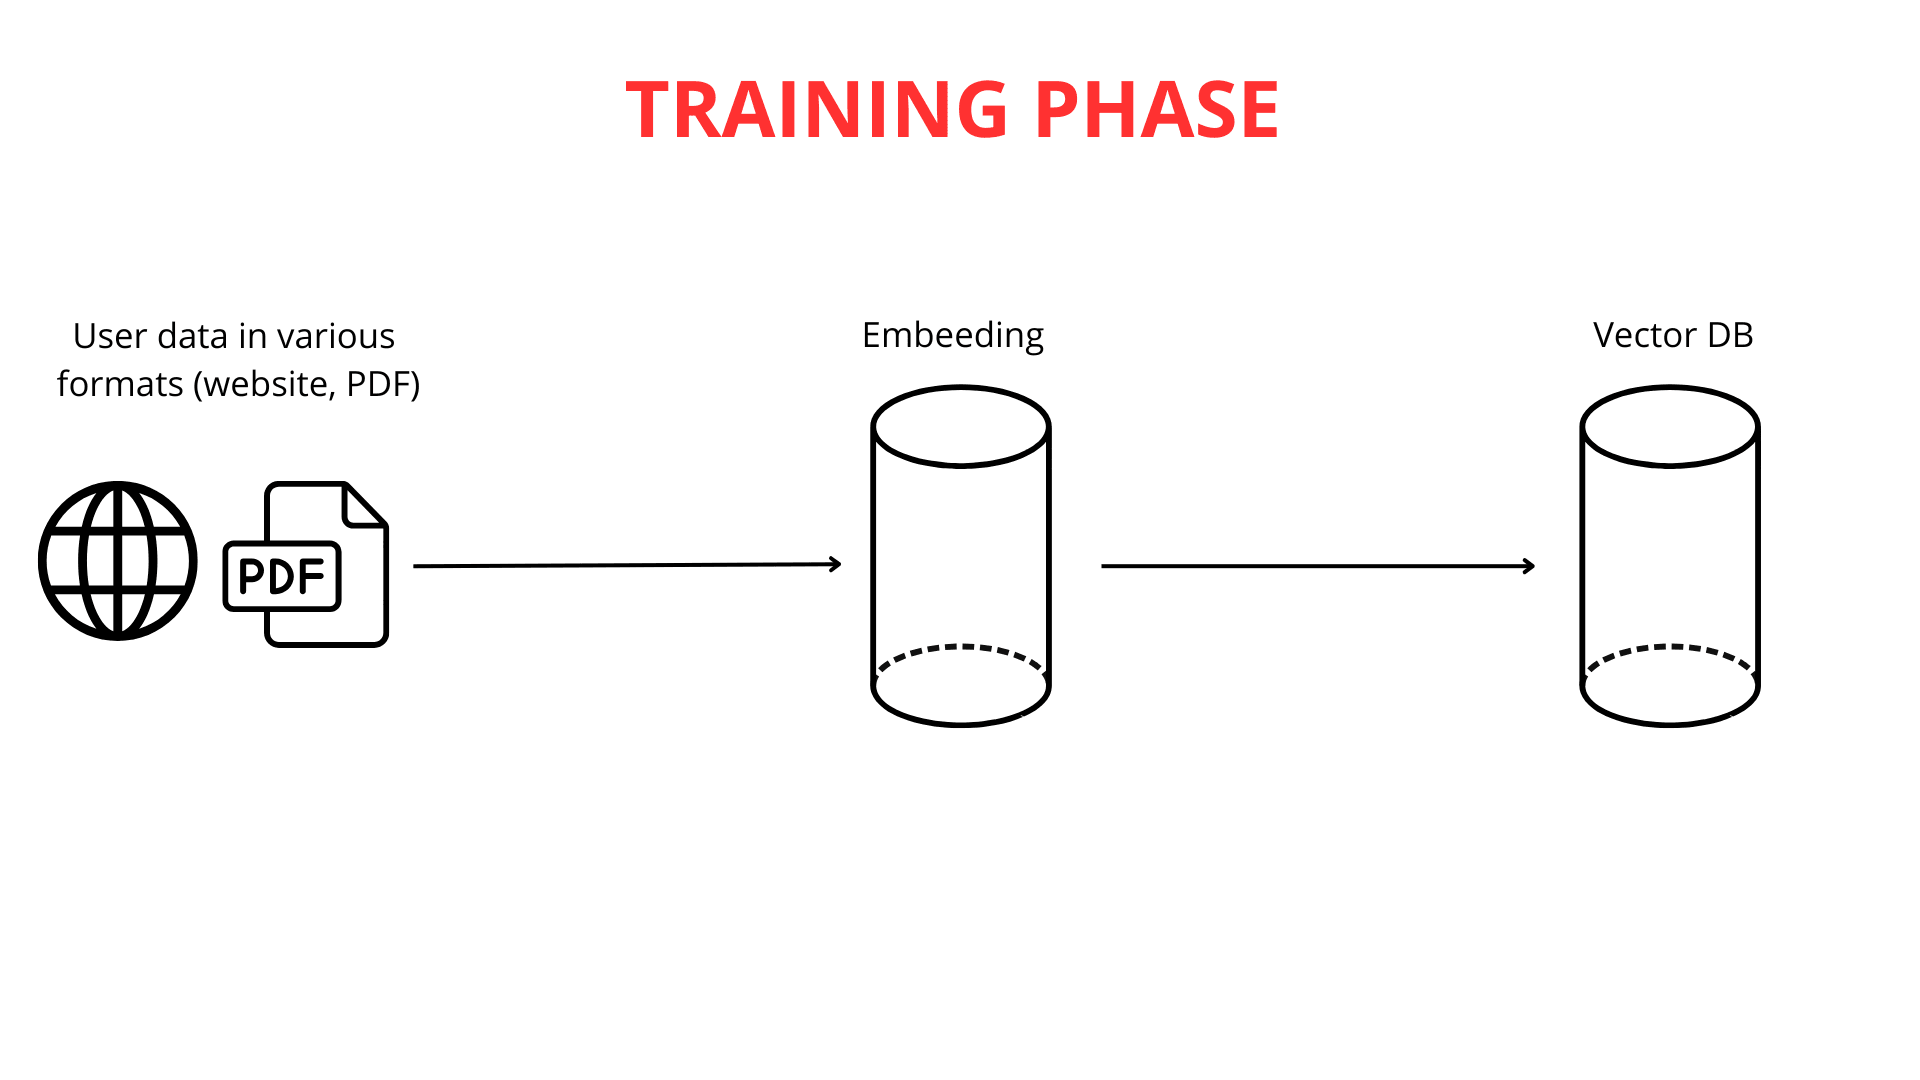
Construir un chatbot inteligente es un proceso arraigado en el conocimiento de múltiples disciplinas científicas. El primer paso, y el más crucial, es alimentar al chatbot con datos. En ChatLab, lo hacemos posible de varias formas prácticas: subiendo el contenido de un sitio web, documentación extensa o incluso tus propios archivos PDF. Las posibilidades de personalizar la base de conocimiento según tus necesidades son prácticamente ilimitadas.
La siguiente etapa consiste en dividir textos largos en fragmentos más pequeños (de hasta 600 tokens cada uno), lo que facilita que el sistema procese la información de manera eficiente. Una vez que los datos se han subido y segmentado, comienza el proceso de mapeo vectorial.
Es importante destacar que el mapeo de texto a vectores es fundamental para el funcionamiento de RAG. Los potentes motores de modelos de lenguaje grandes (LLM) son los responsables de generar estas representaciones vectoriales.
El papel del mapeo vectorial en la comprensión del texto
La vectorización de texto consiste esencialmente en convertir palabras en listas de números - construidas de tal manera que las palabras con significados similares reciben representaciones numéricas (vectores) similares. Esto permite que nuestro chatbot "entienda" las relaciones entre diferentes secuencias de palabras. Por ejemplo, las palabras "grande" y "enorme" se transformarían en listas numéricas muy parecidas, mientras que "grande" y "hormiga" recibirían representaciones completamente diferentes.
Al analizar estas similitudes y diferencias numéricas, el chatbot puede deducir que "gato" y "perro" están más estrechamente relacionados que "gato" y "verde".
Una vez generados los vectores, estas representaciones numéricas del conocimiento se almacenan en una base de datos vectorial junto con el contenido original. La base de datos vectorial actúa como un catálogo avanzado de conocimiento vectorizado, optimizado para la recuperación rápida de significados afines.
La base de datos vectorial: una biblioteca de conocimiento inteligente
Para comprender mejor cómo funciona una base de datos vectorial, utilicemos la analogía de una biblioteca con un sistema de búsqueda inteligente. Cada "libro" (fragmento de texto) está "etiquetado" con un vector único (una secuencia de números). Este código contiene múltiples números que representan el autor, el estilo y la temática del libro. Dos libros sobre temas similares tendrán códigos muy parecidos.
En esta "biblioteca", los libros se colocan en "estanterías" dentro de un espacio multidimensional en función de sus códigos. Los libros con códigos similares se agrupan muy cerca unos de otros - de forma parecida a los libros de una misma categoría, pero organizados de manera aún más precisa según sutiles similitudes de contenido. Cuando haces una pregunta (por ejemplo, "¿Cuál es la receta del pastel de chocolate?"), esta se convierte en uno de esos "códigos". El sistema de búsqueda inteligente de la base de datos vectorial escanea las "estanterías" (fragmentos de texto) en busca de los códigos que más se aproximen al código de tu consulta.
El algoritmo identifica rápidamente los "libros" (fragmentos) con mayor probabilidad de contener la respuesta. En lugar de buscar en toda la "biblioteca", el chatbot localiza al instante las piezas de conocimiento más relevantes en términos de significado. Esto garantiza respuestas más rápidas, precisas y centradas en el contexto.
¿Qué ocurre cuando haces una pregunta?
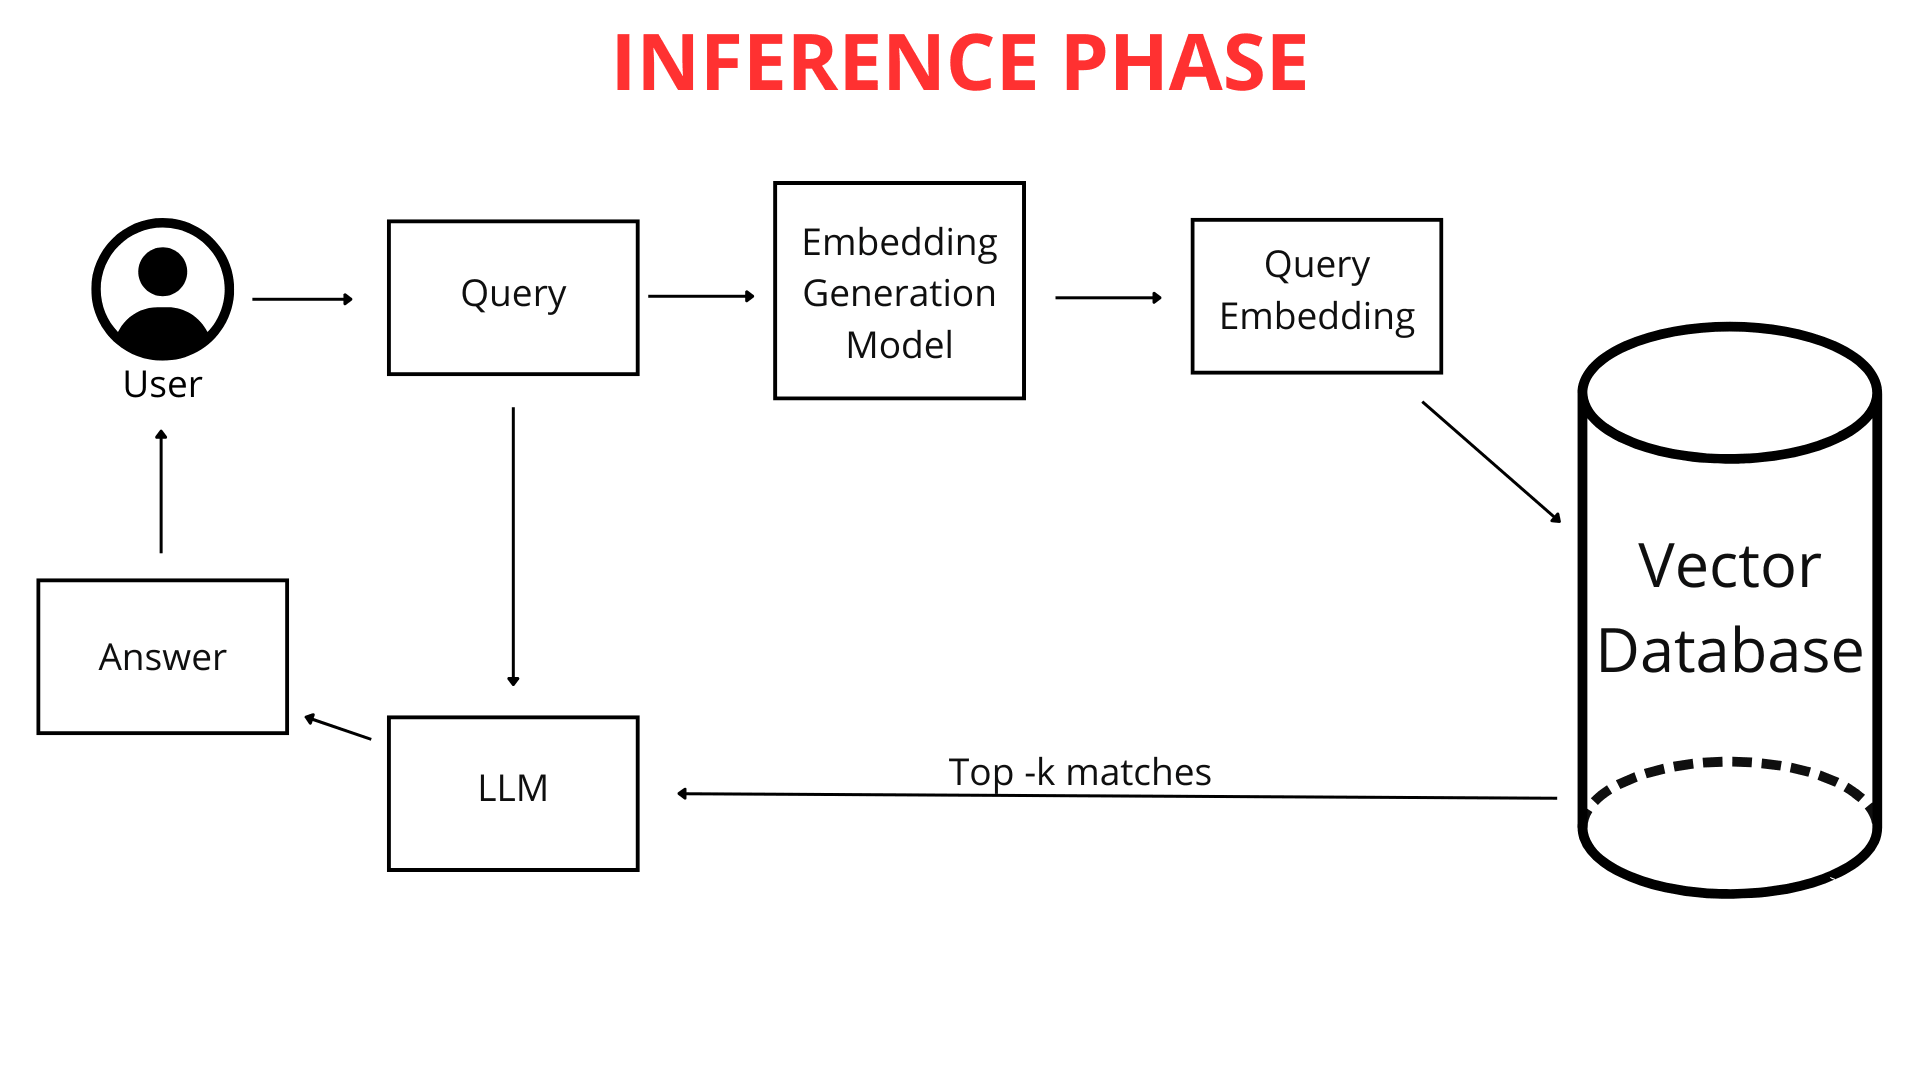
Cuando tú, como usuario, escribes una pregunta en el chatbot (por ejemplo, "¿Qué tiempo hará mañana en Cracovia?"), esta no se compara de inmediato con el conocimiento del chatbot en formato de texto sin procesar. Primero, la pregunta se mapea en un vector numérico. Dado que tanto tu pregunta como toda la base de conocimiento del chatbot están representadas en el mismo formato - como mapas vectoriales (listas de números) -, el chatbot puede compararlas de manera eficiente. Identifica los fragmentos de su conocimiento más estrechamente relacionados con el vector de tu consulta, lo que le permite generar la mejor respuesta posible.
RAG entra en acción
Aquí es donde la tecnología RAG desempeña un papel fundamental. El sistema RAG analiza la representación vectorial de tu consulta y la utiliza para buscar en la base de datos vectorial las listas numéricas más similares a ella (las más cercanas en el espacio multidimensional). Estos vectores más afines apuntan a los fragmentos de los archivos originales más relevantes para tu pregunta.
RAG actúa como un "puente" inteligente entre tu consulta y la amplia base de conocimiento del chatbot. Permite recuperar dinámicamente solo la información más necesaria para que el LLM (modelo de lenguaje grande) formule una respuesta. Un LLM, en términos sencillos, es un algoritmo avanzado y un conjunto de datos entrenado con cantidades masivas de texto, capaz de comprender y generar lenguaje natural. Para saber más sobre esta tecnología, echa un vistazo a cómo funciona realmente ChatGPT. Los LLM pueden responder preguntas e incluso crear contenidos muy diversos.
Sin RAG, un LLM tendría que depender exclusivamente de su conocimiento integrado, que podría no incluir detalles específicos de tus archivos o estar desactualizado. Gracias a RAG, el chatbot adquiere la capacidad de recurrir a conocimiento externo adicional justo en el momento en que haces una pregunta. Este conocimiento actualizado proviene directamente de tus archivos y páginas web subidas, debidamente procesados.
La diferencia entre un chatbot con y sin RAG
La diferencia fundamental radica en cómo se accede al conocimiento.
Conocimiento entrenado (sin RAG): Es el conocimiento "integrado" del LLM, adquirido durante un entrenamiento intensivo con enormes conjuntos de datos antes de tu interacción con ChatLab. Si preguntas sobre algo que no estaba cubierto en esos datos, es posible que el modelo simplemente no sepa la respuesta.
El conocimiento de tus archivos (utilizado mediante RAG): Es tu conocimiento único y especializado, el que tú proporcionas al chatbot. RAG le permite acceder dinámicamente a este conocimiento al responder preguntas, combinándolo con su conocimiento general de entrenamiento para generar una respuesta exhaustiva. Este enfoque impulsa la moderna IA conversacional para la atención al cliente.
Una analogía:
Imagina un LLM como un estudiante extremadamente inteligente que ha leído infinidad de libros (datos de entrenamiento) y posee una cultura general impresionante. Ahora, tú le entregas tus apuntes de clase y folletos (tus archivos). RAG actúa como un sistema que permite a este estudiante consultar rápidamente tus notas al responder una pregunta, en lugar de depender únicamente de lo que recuerda de todos esos libros. Esta mejora garantiza respuestas mejores, más precisas y, lo más importante, más actualizadas.
Gracias a RAG, el chatbot puede ampliar su conocimiento con tus datos exclusivos y utilizarlos activamente en las interacciones. Ya no está limitado solo a lo que aprendió durante su entrenamiento inicial.
Por esta razón, RAG resulta invaluable cuando necesitas que un chatbot responda preguntas sobre tu información específica - detalles que no están disponibles públicamente o que son demasiado de nicho como para formar parte de los datos de entrenamiento generales de un LLM.
Si tu pregunta es: "¿Dónde puedo encontrar libros sobre el espacio?", antes de que el "bibliotecario" (chatbot) comience a "buscar en las estanterías", primero "traduce" tu pregunta al "idioma de las estanterías", identificando la categoría adecuada de libros. Crear un mapa vectorial de tu pregunta equivale a catalogar tu consulta en categorías que el chatbot comprende y a las que puede acceder a través de la base de datos vectorial.
La fase de entrenamiento y utilización del conocimiento
Como se explicó antes, tu pregunta se convierte en una lista de números que representa su significado. A continuación, el chatbot busca en la base de datos vectorial los vectores más similares que representan fragmentos de conocimiento. Cuanto más próximas sean las representaciones vectoriales, mayor será la similitud entre tu pregunta y dichos fragmentos.
El chatbot selecciona los fragmentos más afines de su conocimiento previamente procesado - aquellos cuyos vectores están más cerca del mapa vectorial de tu pregunta. Es importante destacar que, al analizar tu consulta, ChatLab no solo tiene en cuenta la pregunta en sí, sino también el contexto de toda la conversación mantenida hasta ese momento. Esto permite que el sistema RAG elija con mayor precisión la mejor información a partir de las fuentes de conocimiento conectadas.
Por ejemplo, si primero preguntas por "los últimos modelos de teléfono" y luego continúas con "¿Tienen buenas cámaras?", el chatbot - al recordar el contexto de la conversación - entiende que sigues refiriéndote a esos teléfonos en concreto.
Los fragmentos de conocimiento seleccionados se combinan con tu pregunta original y las instrucciones de la sección "Rol y comportamiento". Estas instrucciones, también conocidas como prompt, constituyen nuestro conjunto personalizado de directrices para el chatbot. Si queremos que el chatbot añada siempre un enlace a la fuente al final de su respuesta o salude a los usuarios de una forma determinada, lo indicamos en el prompt.
Esto genera una consulta enriquecida, que luego se traslada al "cerebro" del chatbot - el modelo de lenguaje grande (LLM) de OpenAI, Google u otros proveedores.
El modelo de lenguaje analiza este complejo conjunto de información: el prompt, el historial de conversaciones y el conocimiento recuperado para la consulta del usuario. Además, el LLM aprovecha su conocimiento general del mundo para generar una respuesta. Esto hace posibles experiencias de cliente altamente personalizadas con IA. Por último, la respuesta afinada y pulida se presenta en la intuitiva interfaz de ChatLab.
Resumen
En este artículo, hemos recorrido la arquitectura del sistema RAG en el funcionamiento de los chatbots - desde la entrada de datos hasta la generación de respuestas. RAG es un componente esencial de los sistemas conversacionales modernos, ya que permite un uso eficiente del conocimiento externo. Empresas como ChatLab integran activamente esta innovadora tecnología en sus productos, ofreciendo a sus clientes capacidades de interacción avanzadas e inteligentes.
Aunque el sistema RAG presenta cierta complejidad técnica, su impacto en el texto generado por IA es innegable. El hecho de que gigantes tecnológicos como Google, Microsoft y Amazon lo utilicen con éxito subraya su papel protagonista en la constante evolución de la inteligencia artificial.
¿Quieres comprobar en primera persona el potencial de la tecnología RAG? Descubre las funciones de ChatLab o aprende cómo crear tu propio chatbot de IA impulsado por esta tecnología.


