Как ChatLab использует технологию RAG?


Как ChatLab использует технологию RAG?
В ChatLab мы создаем умных чат-ботов, которые кардинально меняют онлайн-взаимодействие. Главный двигатель их возможностей - инновационная технология Retrieval-Augmented Generation (RAG), или генерация с расширенным поиском. Она лежит в основе нашей системы, позволяя нам предоставлять решения, выходящие далеко за рамки стандартных диалогов.
В мире чат-ботов существуют два основных метода обучения. Понимание различных типов чат-ботов помогает увидеть, чем различаются эти подходы к обучению. Первый метод предполагает интенсивное обучение сложных нейронных сетей - запутанный, трудоемкий и дорогостоящий процесс. Второй подход, который мы успешно применяем в ChatLab, - это RAG. Он не только проще, экономичнее и быстрее во внедрении, но и открывает нашим чат-ботам доступ к неограниченным внешним источникам информации - например, к вашим собственным файлам. Это позволяет нам генерировать ответы с высочайшей точностью, пониманием контекста и персонализацией.
Предлагаем вам дочитать статью до конца и подробнее узнать о том, как технология RAG обеспечивает работу ChatLab!
Что такое RAG на самом деле?
Чтобы понять, как устроена наша система, стоит внимательнее присмотреться к Retrieval-Augmented Generation. Хотя с точки зрения пользователя общение с чат-ботом кажется интуитивным, понимание внутренних механизмов его работы позволяет в полной мере оценить его потенциал.
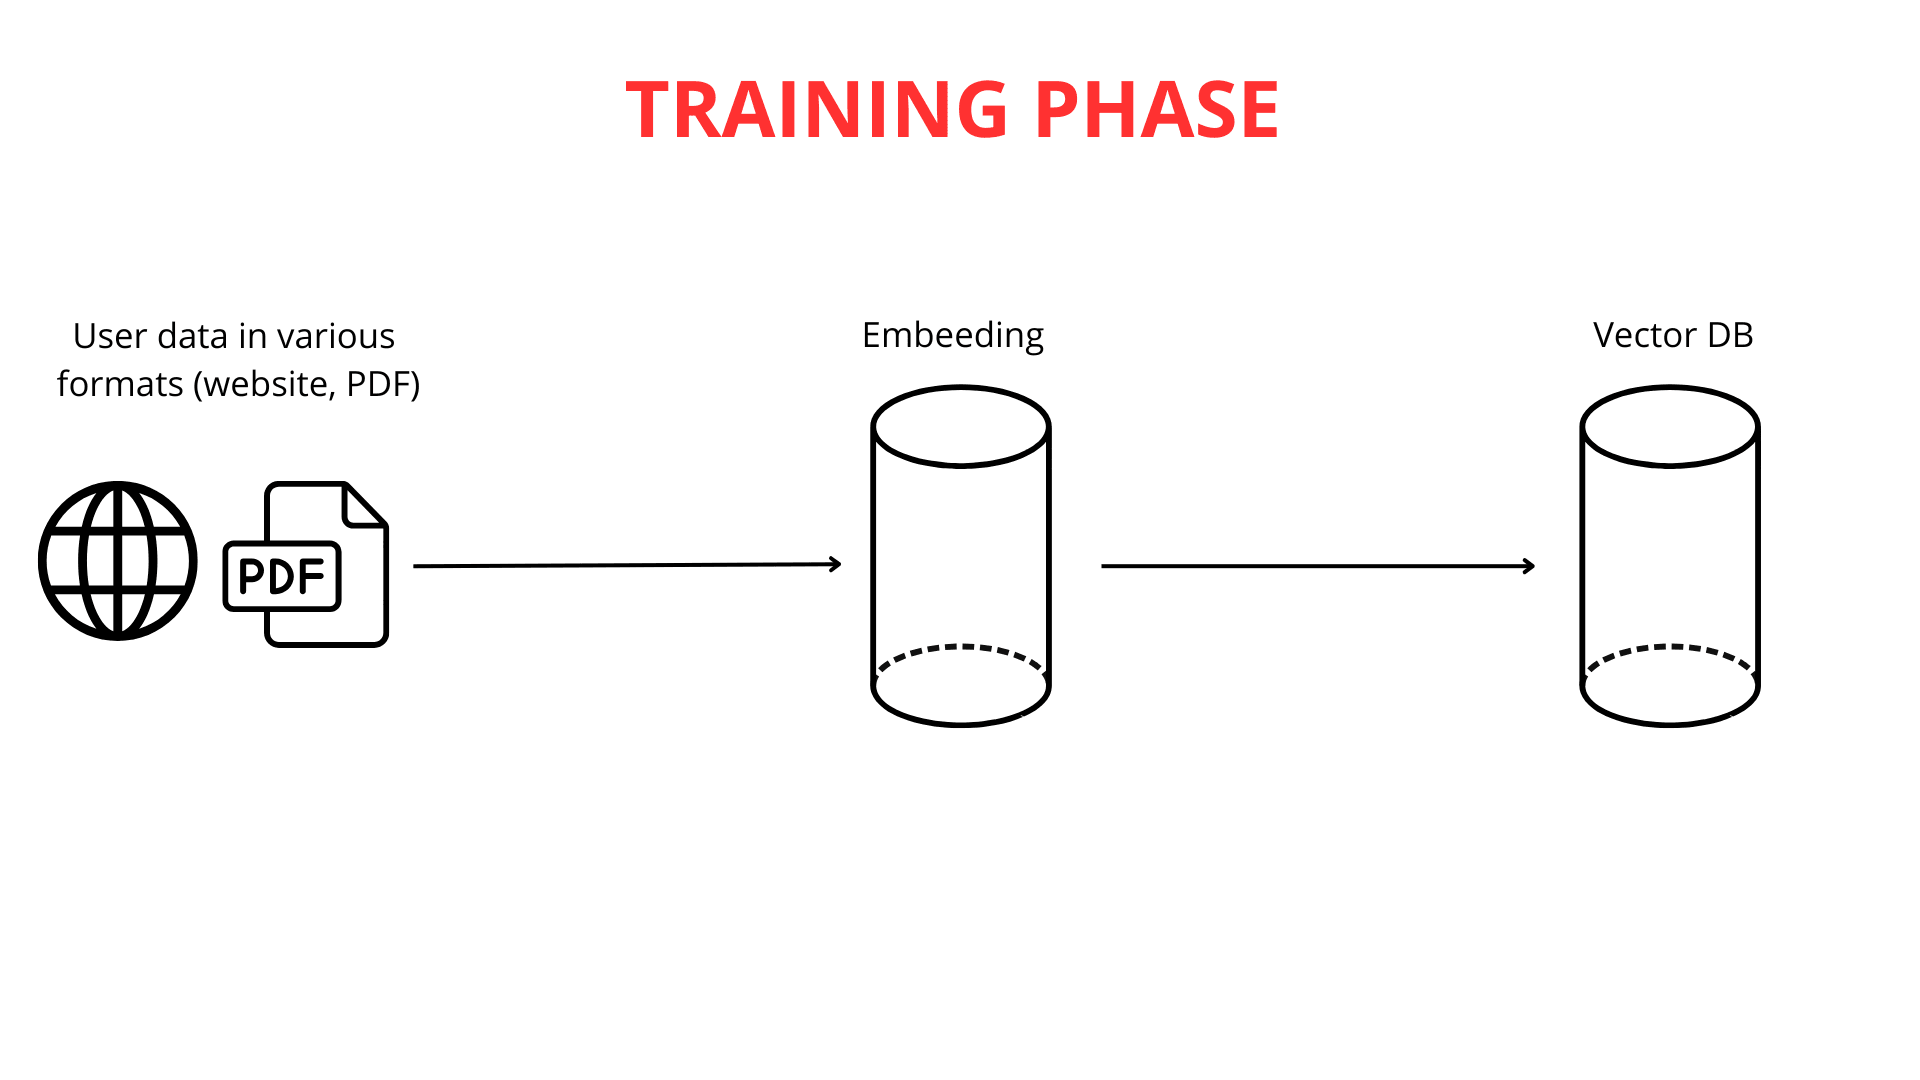
Создание умного чат-бота - это процесс, опирающийся на знания из множества научных дисциплин. Первый и самый важный шаг - наполнение чат-бота данными. В ChatLab мы предлагаем для этого несколько удобных способов: загрузка содержимого веб-сайта, обширной документации или ваших собственных PDF-файлов. Возможности адаптации базы знаний под ваши задачи практически безграничны.
Следующий этап включает разделение длинных текстов на более мелкие фрагменты (до 600 токенов каждый), что упрощает эффективную обработку информации системой. Как только данные загружены и разбиты на сегменты, начинается процесс векторного отображения.
Важно подчеркнуть, что преобразование текста в векторы играет решающую роль в работе RAG. Мощные движки больших языковых моделей (LLM) как раз и отвечают за генерацию этих векторных представлений.
Роль векторного отображения в понимании текста
Векторизация текста - это, по сути, преобразование слов в списки чисел, сформированные таким образом, что слова с похожим смыслом получают близкие числовые представления (векторы). Это позволяет нашему чат-боту «понимать» взаимосвязи между различными последовательностями слов. Например, слова «большой» и «огромный» будут преобразованы в очень похожие числовые списки, тогда как слова «большой» и «муравей» получат совершенно разные представления.
Анализируя эти числовые сходства и различия, чат-бот может сделать вывод, что слова «кошка» и «собака» ближе друг к другу по смыслу, чем «кошка» и «зеленый».
После генерации векторов эти числовые представления знаний сохраняются в векторной базе данных вместе с исходным содержимым. Векторная база данных выступает в роли продвинутого каталога векторизованных знаний, оптимизированного для быстрого поиска смысловых ассоциаций.
Векторная база данных: интеллектуальная библиотека знаний
Чтобы нагляднее представить работу векторной базы данных, воспользуемся аналогией с библиотекой с умной поисковой системой. Каждая «книга» (фрагмент текста) снабжена уникальным вектором (последовательностью чисел). Этот код содержит множество чисел, отражающих автора, стиль и тематику книги. Две книги на схожие темы будут иметь очень похожие коды.
В такой «библиотеке» книги расставлены по «полкам» в многомерном пространстве в соответствии с их кодами. Книги с близкими кодами располагаются рядом - во многом как книги из одной категории, но с дополнительной сортировкой по тонким смысловым оттенкам. Когда вы задаете вопрос (например: «Какой рецепт шоколадного торта?»), он преобразуется в аналогичный «код». Умная поисковая система векторной базы данных сканирует «полки» (фрагменты текста) в поисках кодов, наиболее точно соответствующих коду вашего запроса.
Алгоритм мгновенно определяет «книги» (фрагменты), которые с наибольшей вероятностью содержат ответ. Вместо поиска по всей «библиотеке» чат-бот безошибочно находит наиболее релевантные по смыслу фрагменты знаний. Это обеспечивает более быстрые, точные и сфокусированные на контексте ответы.
Что происходит, когда вы задаете вопрос?
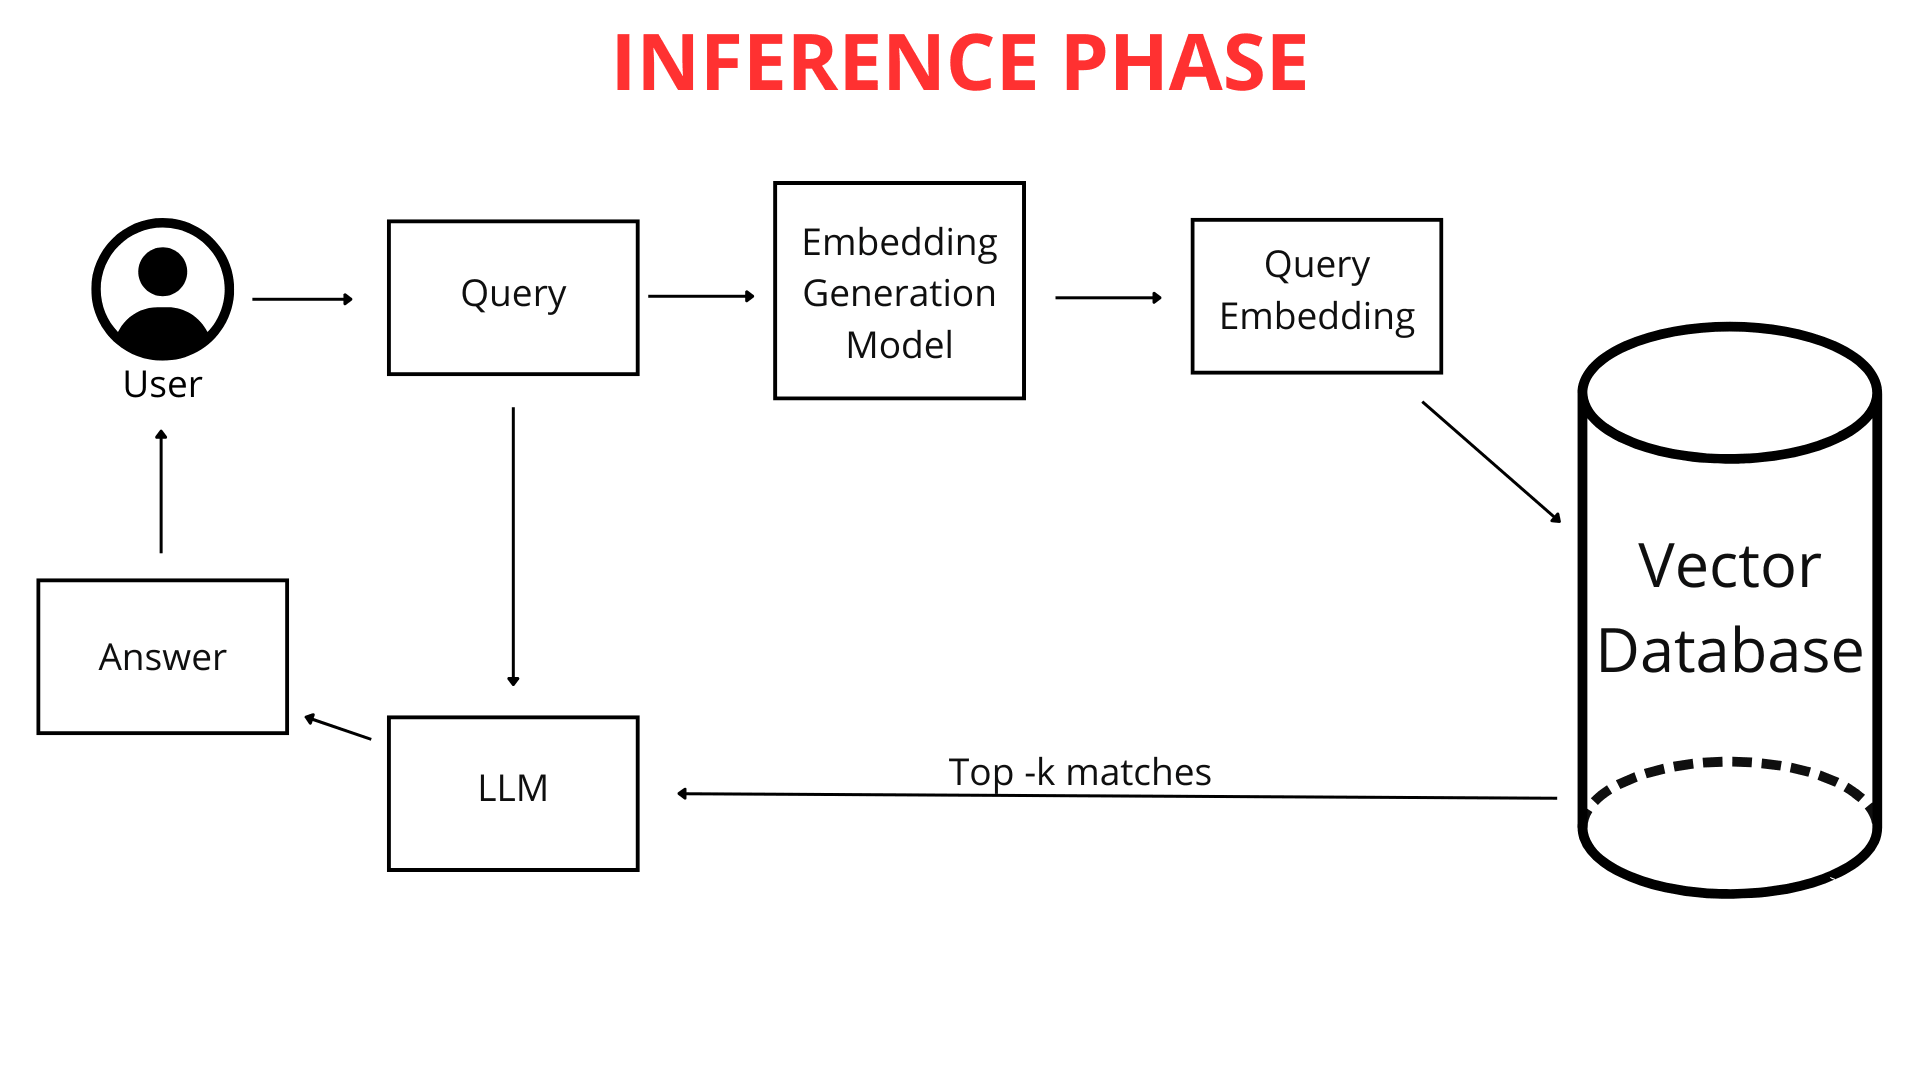
Когда вы вводите вопрос в чат-бот (например: «Какая погода в Кракове завтра?»), он не сопоставляется со знаниями чат-бота сразу в виде обычного текста. Сначала вопрос отображается в числовой вектор. Поскольку и ваш вопрос, и вся база знаний чат-бота представлены в одном и том же формате - в виде векторных карт (списков чисел), - чат-бот может эффективно их сопоставить. Он находит те фрагменты своих знаний, которые ближе всего к вектору вашего запроса, и за счет этого формирует наилучший ответ.
RAG вступает в действие
Именно здесь технология RAG берет на себя ведущую роль. Система RAG анализирует векторное представление вашего запроса и с его помощью ищет в векторной базе данных наиболее близкие к нему числовые списки (находящиеся ближе всего в многомерном пространстве). Эти наиболее похожие векторы указывают на фрагменты исходных файлов, максимально релевантные вашему вопросу.
RAG служит своеобразным интеллектуальным «мостиком» между вашим запросом и обширной базой знаний чат-бота. Технология обеспечивает динамическое извлечение только той информации, которая действительно необходима LLM (большой языковой модели) для формулирования ответа. LLM простыми словами - это продвинутый алгоритм и массив данных, обученный на колоссальных объемах текста, способный понимать и генерировать естественную речь. Чтобы узнать больше об этой технологии, прочитайте о том, как на самом деле работает ChatGPT. Модели LLM умеют отвечать на вопросы и создавать разнообразный контент.
Без RAG языковой модели пришлось бы опираться исключительно на свои встроенные знания, в которых может не оказаться специфических деталей из ваших файлов или которые могут просто устареть. Благодаря RAG чат-бот получает возможность обращаться к дополнительным внешним знаниям ровно в тот момент, когда вы задаете вопрос. Эти свежие знания поступают напрямую из ваших загруженных файлов и веб-страниц, прошедших предварительную обработку.
Разница между чат-ботом с RAG и без нее
Ключевое отличие заключается в том, как осуществляется доступ к знаниям.
Знания из обучающей выборки (без RAG): это «встроенные» знания LLM, приобретенные во время масштабного обучения на огромных наборах данных еще до вашего знакомства с ChatLab. Если вы спросите о том, чего не было в этих данных, модель может просто не знать ответа.
Знания из ваших файлов (с использованием RAG): это ваши уникальные специализированные данные, которые вы предоставляете чат-боту. RAG позволяет чат-боту динамически обращаться к этим сведениям при ответе на вопросы, объединяя их со своими общими знаниями для формирования исчерпывающего ответа. На таком подходе строится современный разговорный AI для клиентского сервиса.
Аналогия:
Представьте себе LLM как чрезвычайно эрудированного студента, прочитавшего бесчисленное множество книг (данные для обучения) и обладающего впечатляющим кругозором. Теперь вы передаете ему конспекты своих лекций и методички (ваши файлы). RAG работает как механизм, позволяющий этому студенту быстро заглянуть в ваши конспекты во время ответа на вопрос, а не полагаться исключительно на память о прочитанных когда-то книгах. Такое расширение гарантирует более качественные, точные и, что особенно важно, актуальные ответы.
Благодаря RAG чат-бот расширяет свои знания за счет ваших уникальных данных и активно использует их в диалоге. Он больше не ограничен лишь тем, чему обучился на начальном этапе.
Вот почему RAG незаменима, когда требуется, чтобы чат-бот отвечал на вопросы по вашей внутренней информации - фактам, которых нет в открытом доступе или которые слишком специфичны, чтобы войти в общедоступные обучающие данные LLM.
Если ваш вопрос звучит так: «Где найти книги о космосе?», то перед тем как «библиотекарь» (чат-бот) пойдет «проверять полки», он сначала «переведет» ваш вопрос на «язык полок» - определит подходящую категорию литературы. Создание векторной карты вашего вопроса аналогично каталогизации запроса по категориям, понятным чат-боту и доступным через векторную базу данных.
Этап обучения и использования знаний
Как отмечалось ранее, ваш вопрос преобразуется в список чисел, передающий его смысл. Затем чат-бот ищет в векторной базе данных наиболее похожие векторы, представляющие фрагменты знаний. Чем ближе векторные представления, тем выше сходство между вашим вопросом и найденными фрагментами.
Чат-бот отбирает фрагменты предварительно обработанных знаний с максимальным соответствием - те, чьи векторы ближе всего расположены к векторной карте вашего вопроса. Примечательно, что при анализе запроса ChatLab учитывает не только сам вопрос, но и контекст всей предшествующей беседы. Это помогает системе RAG точнее извлекать нужную информацию из подключенных источников знаний.
Например, если вы сначала спросите про «последние модели телефонов», а затем уточните: «У них хорошие камеры?», чат-бот, удерживая контекст разговора, поймет, что речь по-прежнему идет именно об этих конкретных телефонах.
Отобранные фрагменты знаний объединяются с вашим исходным вопросом и инструкциями из раздела "Role & Behavior". Эти инструкции, также известные как промпт, представляют собой наш индивидуальный набор правил поведения для чат-бота. Если требуется, чтобы чат-бот всегда добавлял ссылку на источник в конце ответа или приветствовал пользователей определенным образом, мы задаем это в промпте.
Так формируется обогащенный запрос, который затем направляется в «мозг» чат-бота - большую языковую модель (LLM) от OpenAI, Google или других провайдеров.
Языковая модель анализирует весь этот комплекс данных: промпт, историю диалога и знания, извлеченные под запрос пользователя. Кроме того, LLM задействует свои общие фоновые знания для составления ответа. Все это обеспечивает по-настоящему персонализированный клиентский опыт с помощью AI. В итоге точный и выверенный ответ отображается в лаконичном интерфейсе ChatLab.
Итоги
В этой статье мы подробно рассмотрели архитектуру системы RAG в работе чат-ботов - от загрузки данных до генерации ответов. RAG служит фундаментальной основой современных диалоговых систем, открывая путь к продуктивному использованию внешних знаний. Компании вроде ChatLab активно внедряют эту революционную технологию в свои продукты, предоставляя клиентам передовые возможности умного взаимодействия.
Несмотря на определенную техническую сложность системы RAG, ее влияние на качество генерируемого искусственным интеллектом текста неоспоримо. Тот факт, что ее успешно используют лидеры индустрии вроде Google, Microsoft и Amazon, лишний раз подтверждает ее ключевую роль в стремительном развитии искусственного интеллекта.
Готовы оценить технологию RAG в действии? Изучите возможности ChatLab или узнайте, как создать собственного AI-чат-бота на базе этой технологии.


