Aggiungere origini dal sito web consente al tuo chatbot di apprendere direttamente dai contenuti del tuo sito. Che si tratti di dettagli sui prodotti, FAQ o articoli del blog, la scansione del sito web crea uno snapshot dei suoi contenuti che il chatbot può consultare. Esegui il retrain quando questi contenuti cambiano. Per prima cosa crea il tuo chatbot e controlla la sua capacità di addestramento.
Gestisci un negozio online? Quando i prodotti provengono da AI Search o dalla ricerca in tempo reale dello store, escludi le pagine dei prodotti e delle categorie dalla scansione e scansiona solo le pagine informative, come spedizioni, resi e FAQ. Le pagine dei prodotti scansionate consumano caratteri di addestramento, e i relativi prezzi e disponibilità diventano obsoleti tra una scansione e l'altra. Consulta Come configurare ChatLab per il tuo store e-commerce.
Dove trovare il training da sito web
Seleziona il tuo chatbot, quindi passa alla scheda Training (Addestramento). Nella barra laterale sinistra, scegli Links (Link). Qui puoi gestire tutte le fonti di training basate su siti web.
Fai clic su Add New Training: Website (Aggiungi nuovo addestramento: Sito web) per aprire il modulo di addestramento.
Opzioni di scansione
Il modulo di addestramento offre due modi per aggiungere contenuti da un sito web, separati dal divisore OR (O).
Scan website contents (Scansiona contenuti del sito web) - Inserisci un URL nel campo Address (Indirizzo) e scegli tra:
- Whole website (Intero sito web) - Esegue la scansione di tutte le pagine rilevabili a partire dall'URL fornito
- Single address (Singolo indirizzo) - Esegue la scansione solo della pagina specifica inserita
Use sitemap (Usa sitemap) - Inserisci l'URL della tua sitemap (es. https://www.yourdomain.com/sitemap.xml) nel campo Sitemap. Verranno scansionate solo le pagine elencate nel file della sitemap.
Quando usi una sitemap, il campo Address viene disabilitato automaticamente (e viceversa), poiché puoi utilizzare solo un metodo per ogni processo di addestramento.

Addestra sull'intero sito web
- Inserisci l'URL principale del tuo sito web nel campo Address (Indirizzo) (es.
https://www.yourdomain.com) - Seleziona Whole website (Intero sito web) dal menu a discesa sotto il campo dell'indirizzo
- Fai clic su Start scanning the website (Avvia scansione del sito web)
Il sistema segue i link individuabili entro i filtri, la profondità e i limiti dell'account impostati per la scansione; potrebbe non raggiungere ogni singola pagina. Puoi monitorare l'avanzamento nella scheda Trainings (Addestramenti), dove vedrai in tempo reale il numero di link scansionati e di caratteri di addestramento raccolti.

Eseguire il training su una singola pagina
- Inserisci l'URL della pagina specifica nel campo Address (es.
https://www.yourdomain.com/pricing) - Seleziona Single address dal menu a discesa
- Fai clic su Start scanning the website
Questa opzione è utile quando devi aggiungere solo una pagina specifica alla knowledge base del chatbot, ad esempio un articolo appena pubblicato o una pagina FAQ aggiornata.
Eseguire il training da sitemap
- Inserisci l'URL della sitemap nel campo Sitemap (es.
https://www.yourdomain.com/sitemap.xml) - Fai clic su Start scanning the website
La scansione tramite sitemap offre un controllo preciso sulle pagine da includere, poiché elabora solo gli URL presenti nel file della sitemap.
Selezionare singole pagine per il training
Prima di avviare una scansione, puoi attivare l'opzione I want to select individual urls for training after scanning the website (Desidero selezionare singoli URL per il training dopo la scansione del sito web). Questa opzione è disponibile solo durante la scansione di un intero sito web (non per la modalità a singolo indirizzo).
Quando è abilitata:
- Il sistema scansiona il sito web e rileva tutte le pagine
- Al termine della scansione, visualizzerai una struttura ad albero di tutte le pagine rilevate con il relativo conteggio dei caratteri
- Seleziona o deseleziona le pagine per includerle o escluderle dal training
- Fai clic su Start the Training (Avvia il training) per avviare il training sulle pagine selezionate
Questa funzione è utile se il sito web contiene pagine da cui non vuoi che il chatbot impari, come pagine di accesso, aree amministrative o sezioni non pertinenti.
Scansione delle lingue del sito web
Se il tuo sito web è pubblicato in più lingue, ChatLab rileva le lingue disponibili durante la scansione e ti consente di decidere quali includere nella knowledge base del tuo chatbot. Troverai questi controlli nella sezione Languages (Lingue) del modulo di addestramento, subito sopra Advanced settings (Impostazioni avanzate).

Ambito della lingua
Il menu a discesa Language scope (Ambito della lingua) controlla quale porzione di un sito multilingue viene scansionata:
- Main website language (Lingua principale del sito) - consigliata e selezionata per impostazione predefinita quando la funzione multilingue non è disponibile e il bot non ha il multilingue abilitato. Viene scansionata solo la lingua principale del sito. Le altre versioni linguistiche vengono ignorate. Ciò mantiene i dati di addestramento snelli e mirati, consumando meno capacità di addestramento.
- All languages (Tutte le lingue) - consigliata e selezionata per impostazione predefinita quando il tuo account include la funzione multilingue o il bot ha il multilingue abilitato. Esegue la scansione delle versioni linguistiche individuate nel sito. Include tutte le tue pagine localizzate, ma raccoglie più contenuti e consuma più capacità di addestramento.
- Selected language (Lingua selezionata) - esegue la scansione di una singola lingua scelta tra quelle rilevate sul sito.
ChatLab rileva la lingua principale del sito per la scansione specifica per lingua. L'ambito predefinito dipende dalla disponibilità della funzione multilingue, non dalla lingua rilevata. Quando scegli Selected language, la lingua principale rilevata viene preselezionata automaticamente e contrassegnata come "main" nell'elenco. Puoi modificarla selezionando qualsiasi altra lingua rilevata.
Il rilevamento della lingua è disponibile in tutti i piani, compreso il piano gratuito. Puoi modificare l'ambito prima della scansione. L'opzione New training with same parameters (Nuovo addestramento con gli stessi parametri) riutilizza l'ambito dell'attività precedente, che potrebbe differire da quello predefinito per una nuova scansione.
Metodo di rilevamento della lingua
Quando l'ambito è impostato su Main website language o Selected language, puoi scegliere in che modo ChatLab riconosce le versioni linguistiche del tuo sito tramite il menu a discesa Language detection method (Metodo di rilevamento della lingua):
- Hreflang attributes (recommended) (Attributi hreflang - consigliato) - l'impostazione predefinita. Utilizza il markup
hreflangelangche la maggior parte dei siti multilingue include già per collegare tra loro le diverse versioni linguistiche. - URL path prefix (/en/, /de/, ...) (Prefisso del percorso URL) - per i siti che organizzano ciascuna lingua in un segmento di percorso come
/en/,/de/o/fr/senza markuphreflang.
Se ChatLab non riesce a rilevare le lingue automaticamente, puoi comunque eseguire la scansione della lingua principale o di tutte le lingue. Quando scegli Selected language, inserisci prima l'indirizzo del tuo sito web nei campi sovrastanti, quindi seleziona nuovamente l'opzione in modo da consentire l'analisi del sito.
Per una panoramica su come il tuo chatbot utilizza queste versioni linguistiche per rispondere, consulta Chatbot multilingue e Configurazione della lingua del chatbot. Le modalità della lingua della knowledge base descritte in queste guide si basano su sorgenti scansionate con il rilevamento della lingua, pertanto le sorgenti più vecchie potrebbero richiedere un nuovo addestramento per sfruttarle appieno.
Impostazioni avanzate
Fai clic sul pulsante Advanced settings (Impostazioni avanzate) nel modulo di addestramento per accedere ai controlli dettagliati di scansione.

Le impostazioni avanzate sono organizzate in quattro sezioni:
Filtro URL (URL Filtering)
- Include only URLs that contain (Includi solo gli URL che contengono) - Esegue la scansione solo degli URL corrispondenti a questi pattern (separati da punto e virgola, ad es.
/en;/help) - Exclude URLs that contain (Escludi gli URL che contengono) - Salta gli URL corrispondenti a questi pattern (ad es.
/news;/pictures). I pattern comuni come/wp-admin/,/feed/e le pagine del carrello sono esclusi per impostazione predefinita
Parametri di query (Query Parameters)
- Ignore all query parameters (Ignora tutti i parametri di query) - Tratta gli URL con parametri di query diversi come la stessa pagina (ad es.
/page?id=1e/page?id=2diventano entrambi/page) - Ignore specific query parameters (Ignora parametri di query specifici) - Ignora solo determinati parametri (i parametri di tracciamento comuni come
utm_source,fbclid,gclidvengono ignorati automaticamente)
Filtro contenuti (Content Filtering)
- Include element IDs (Includi ID elemento) - Estrae il contenuto solo da elementi HTML specifici (usa
#idper gli ID,.classnameper le classi,[data-id="82874db"]per gli elementi con un determinato attributo, separati da punto e virgola) - Exclude element IDs (Escludi ID elemento) - Salta il contenuto di elementi HTML specifici (ad es.
footer;header;#navigation;[data-nosnippet]) - Quando vengono impostati elementi da includere/escludere, compaiono degli interruttori condizionali che consentono di controllare se il crawler debba seguire i link trovati all'interno di tali elementi
Comportamento dello scraping (Scraping Behavior)
- Scrape documents (Esegui scraping dei documenti) - Estrae anche il contenuto dai file PDF trovati sul sito web
- Exclude image links (Escludi link alle immagini) - Salta gli URL delle immagini dal dataset di addestramento
- Scrape hidden contents (Esegui scraping dei contenuti nascosti) - Include il contenuto degli elementi HTML nascosti (abilitato per impostazione predefinita)
- Delay between pages (Ritardo tra le pagine) - Aggiunge un ritardo in secondi tra le richieste di pagina per ridurre il carico sul server
- Country code (Codice paese) - Instrada lo scraping attraverso un server proxy in un paese specifico (codice a due lettere, ad es.
us)
Notifiche via email
L'opzione Email me when training is finished or needs my attention (Inviami un'email quando il training è terminato o richiede la mia attenzione) è abilitata per impostazione predefinita. Quando è attiva, riceverai un'email di notifica se:
- Il training viene completato correttamente
- Il sistema richiede un tuo intervento (ad esempio la selezione delle pagine dopo la scansione)
- Si verificano problemi durante il training
Puoi modificare l'indirizzo email di notifica nel campo accanto all'opzione.
Monitorare l'avanzamento del training
Dopo aver avviato una scansione, passa alla scheda Trainings per monitorare l'avanzamento. Ogni sessione di training mostra:
- L'URL di origine
- Lo stato corrente (Scanning links, Awaiting links selection, Training, Training completed)
- Una barra di avanzamento durante la scansione o il training attivi
- La data dell'ultimo aggiornamento

Fai clic su More details (Maggiori dettagli) per visualizzare tutti i parametri usati per una specifica sessione di training, incluse le impostazioni avanzate configurate.

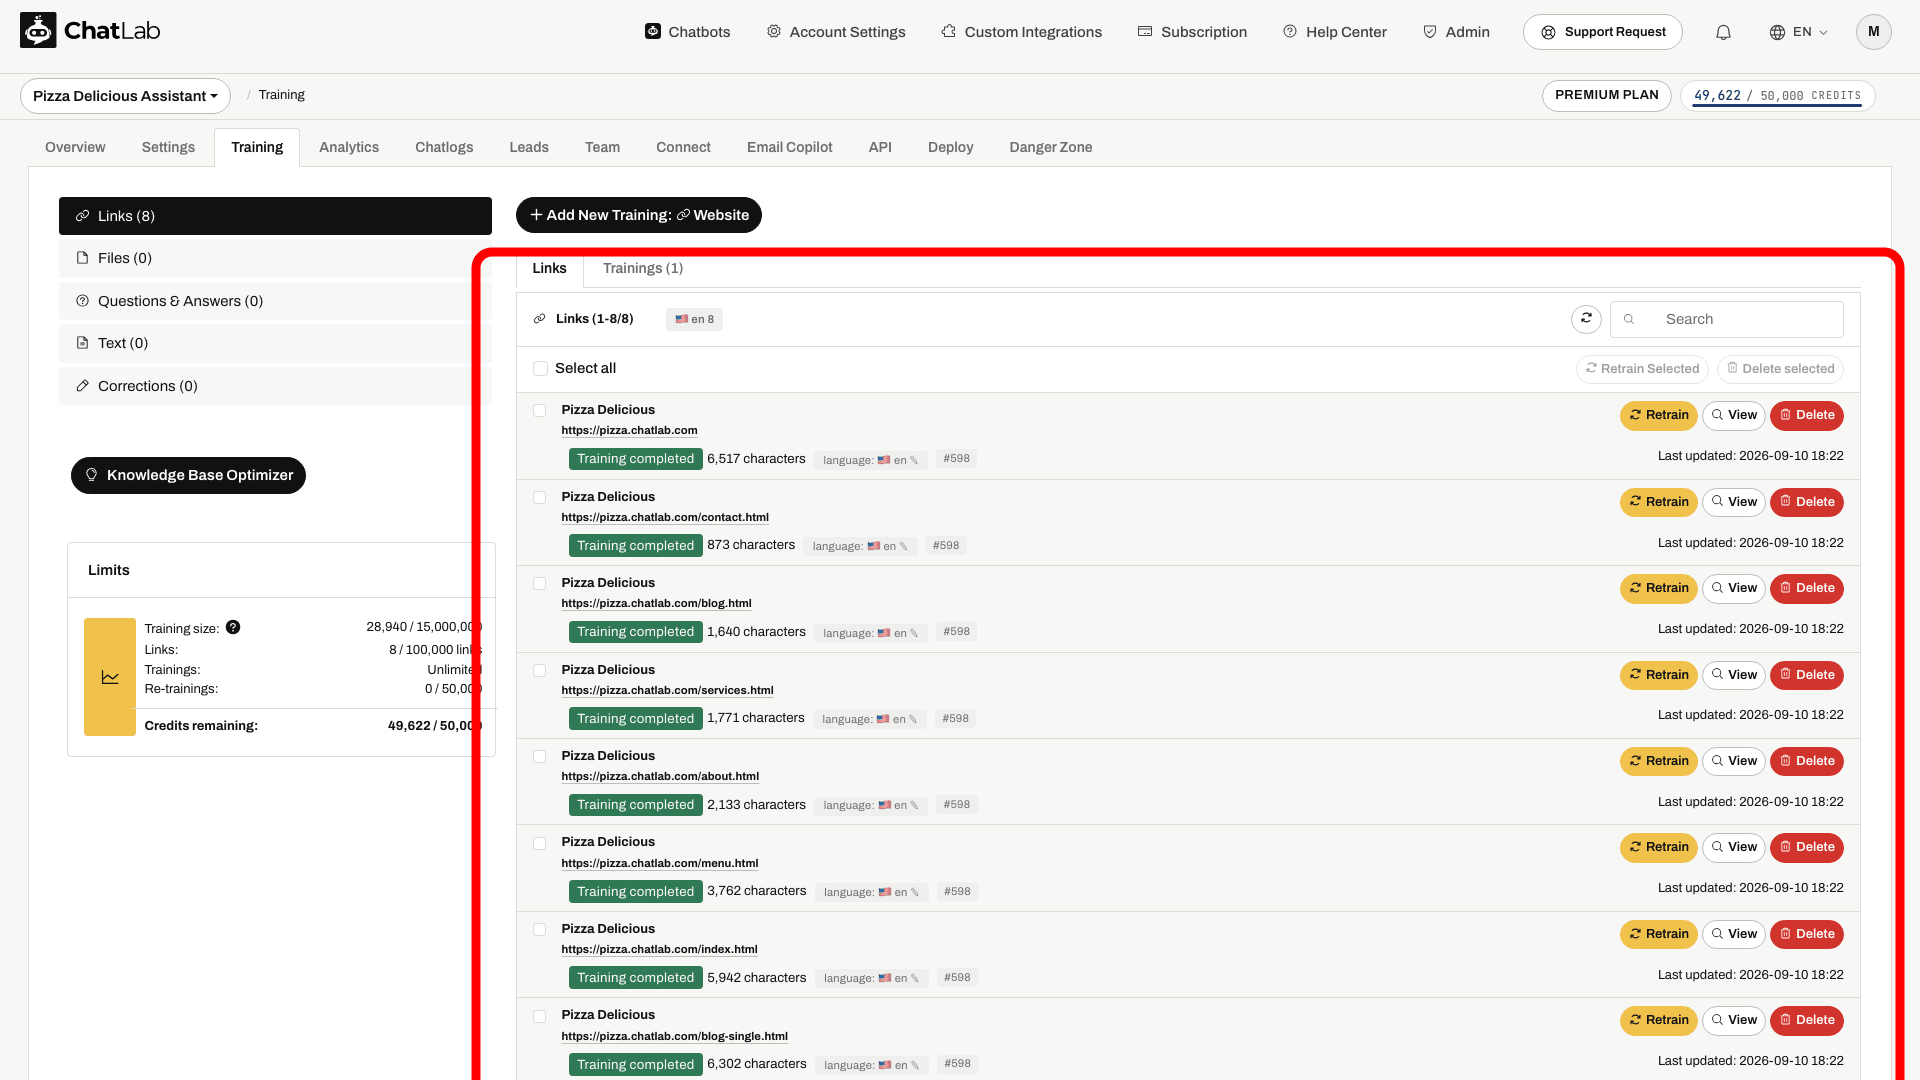
Gestione dei link addestrati
Al termine dell'addestramento, le pagine addestrate con successo compaiono nella scheda Links (Link). Non è garantito che tutte le pagine escluse dalle tue impostazioni, lasciate deselezionate o rifiutate a causa di un errore o di un limite diventino fonti di addestramento. Ciascun link mostra:
- Titolo della pagina e URL
- Conteggio dei caratteri (dimensione dei dati di addestramento)
- Stato dell'addestramento
- Data dell'ultimo aggiornamento
Per ciascun link puoi:
- Retrain (Riaddestra) - Esegui nuovamente la scansione e aggiorna il contenuto di questa pagina specifica
- View (Visualizza) - Controlla il contenuto esatto estratto dalla pagina
- Delete (Elimina) - Rimuovi questa pagina dalla knowledge base del tuo chatbot
Usa la casella di controllo Select all (Seleziona tutto) e i pulsanti delle azioni collettive per riaddestrare o eliminare più link contemporaneamente.
Visualizzare i contenuti scansionati
Fai clic sul pulsante View accanto a qualsiasi link sottoposto a training per visualizzare esattamente i contenuti estratti da quella pagina.

La finestra modale di visualizzazione della fonte mostra il titolo della pagina, l'URL, il conteggio dei caratteri, la data dell'ultimo aggiornamento e il testo completo su cui è stato addestrato il chatbot. Questo ti aiuta a verificare che siano stati acquisiti i contenuti corretti e a comprendere la knowledge base del chatbot.

Controlla il chatbot completato
La scansione e l'addestramento vengono eseguiti in background e possono richiedere alcuni minuti o più tempo per i siti web di grandi dimensioni. Nel frattempo puoi lasciare questa pagina e preparare l'integrazione del chatbot nel sito web. Se lo stato dell'operazione indica Awaiting links selection (In attesa della selezione dei link), torna indietro per selezionare le pagine e avviare l'addestramento. Al termine dell'addestramento, controlla le pagine importanti con View (Visualizza), quindi apri Overview (Panoramica) e prova alcune domande le cui risposte si trovano su tali pagine. Controlla eventuali errori e pagine mancanti prima di fare affidamento sui nuovi contenuti.
Articoli correlati
- Addestramento in background - Scopri come funziona l'addestramento in background
- Riaddestrare il chatbot - Come aggiornare il chatbot con nuovi contenuti
- Come ridurre i caratteri di addestramento durante la scansione di un sito web - Suggerimenti per ottimizzare le dimensioni dei dati di addestramento
- Addestrare il chatbot: nozioni di base e limiti - Comprendere i limiti dei dati di addestramento