Como o ChatLab Utiliza a Tecnologia RAG?


Como o ChatLab Utiliza a Tecnologia RAG?
No ChatLab, criamos chatbots inteligentes que revolucionam as interações online. O principal motor por trás das suas capacidades é uma tecnologia inovadora chamada Retrieval-Augmented Generation (RAG). Esta tecnologia constitui a base do nosso sistema, permitindo-nos disponibilizar soluções que vão muito além das conversas normais.
No universo dos chatbots, existem dois métodos principais de treino. Compreender os diferentes tipos de chatbots ajuda a ver a diferença entre estas abordagens de treino. O primeiro método envolve o treino intensivo de redes neuronais complexas - um processo intrincado, demorado e dispendioso. A segunda abordagem, que utilizamos com sucesso no ChatLab, é o RAG. Não só é mais simples, mais económica e mais rápida de implementar, como também permite aos nossos chatbots aceder a fontes externas ilimitadas de informação - tais como os seus próprios ficheiros. Isto permite-nos gerar respostas altamente precisas, conscientes do contexto e personalizadas.
Convidamo-lo a continuar a ler para descobrir em detalhe como a tecnologia RAG alimenta o ChatLab!
O que é exatamente o RAG?
Para compreender o funcionamento do nosso sistema, vale a pena analisar mais detalhadamente a Retrieval-Augmented Generation. Embora a interação com um chatbot possa parecer intuitiva do ponto de vista do utilizador, compreender os mecanismos por trás do seu funcionamento permite aproveitar todo o seu potencial.
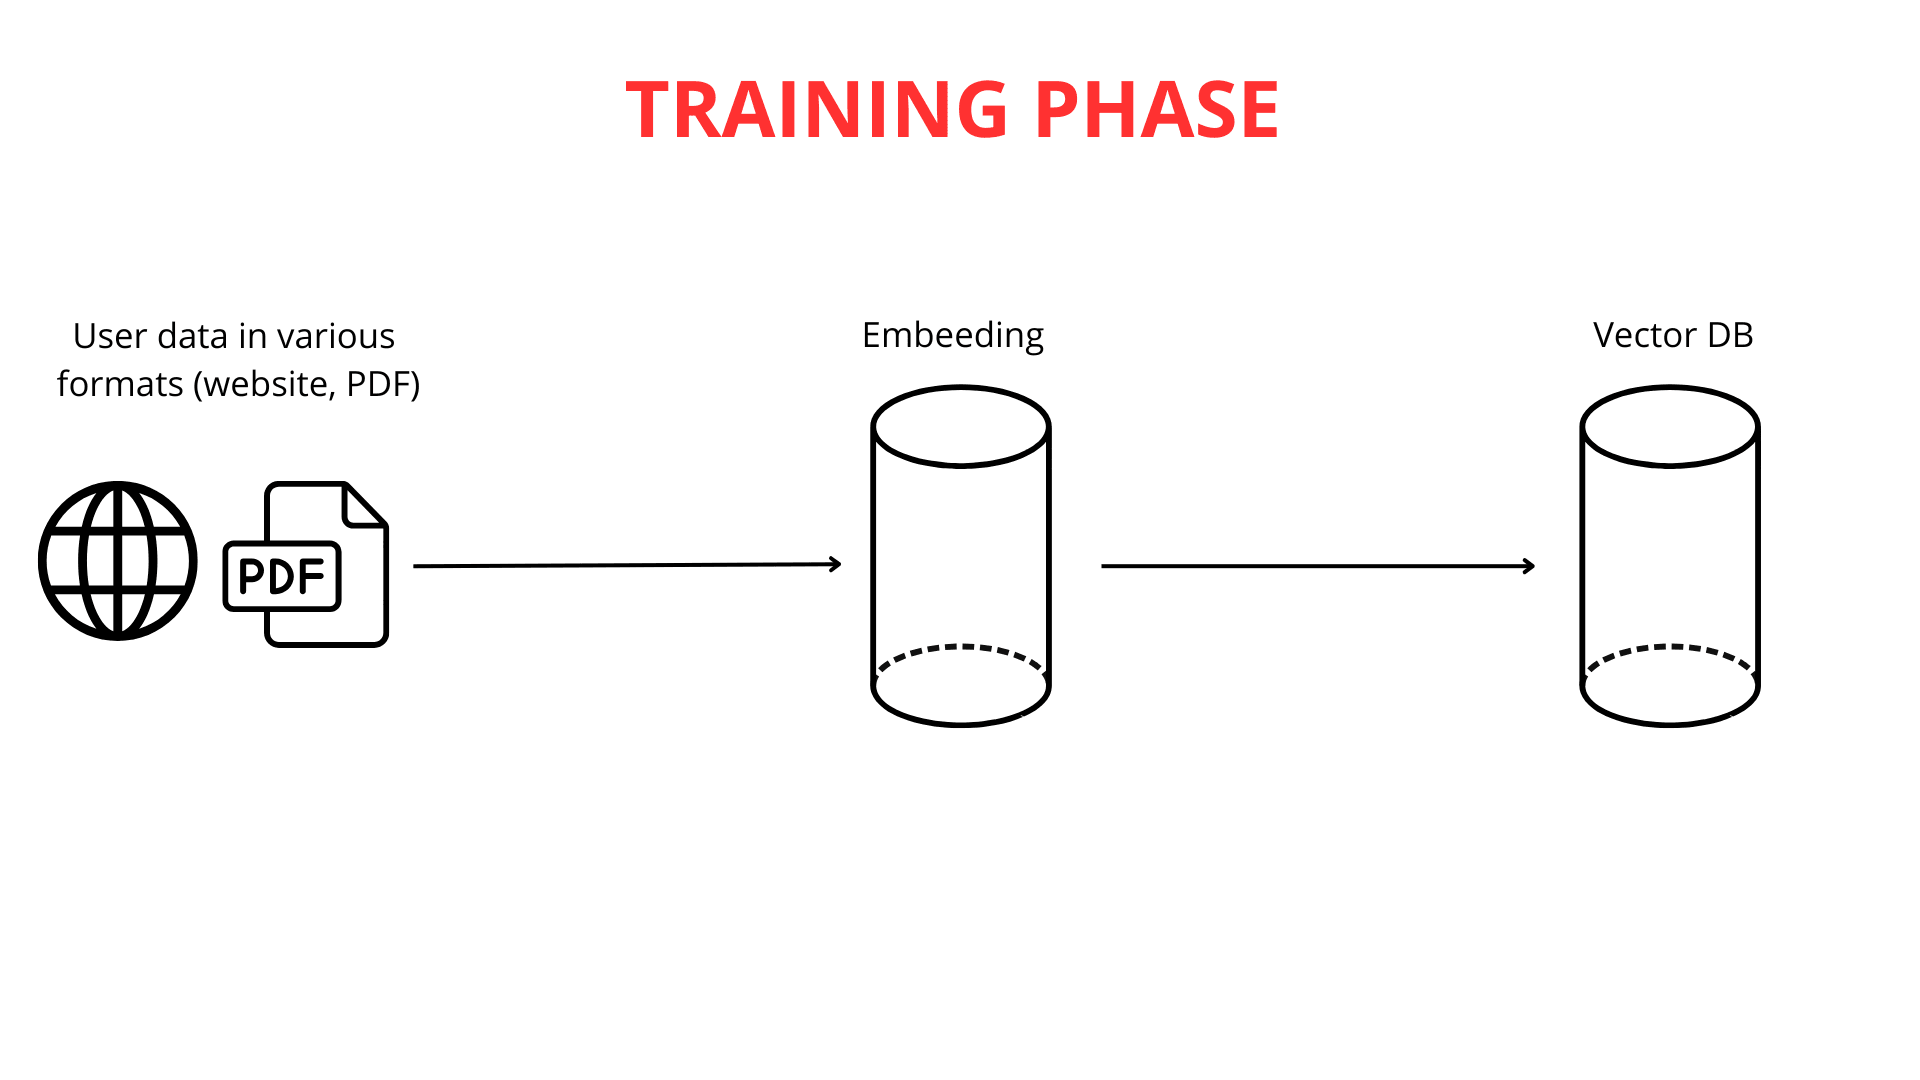
Construir um chatbot inteligente é um processo que se baseia no conhecimento de várias disciplinas científicas. O primeiro passo, e o mais crucial, consiste em alimentar o chatbot com dados. No ChatLab, permitimos fazê-lo de várias formas convenientes: carregando o conteúdo de um website, documentação extensa ou até os seus próprios ficheiros PDF. As possibilidades de personalização da base de conhecimento de acordo com as suas necessidades são praticamente ilimitadas.
A fase seguinte envolve a divisão de textos longos em blocos menores (até 600 tokens cada), facilitando o processamento eficiente da informação pelo sistema. Assim que os dados são carregados e segmentados, tem início o processo de mapeamento vetorial.
É importante sublinhar que o mapeamento de texto para vetores é fundamental para o funcionamento do RAG. Motores avançados de modelos de linguagem de grande escala (LLM) são responsáveis por gerar estas representações vetoriais.
O Papel do Mapeamento Vetorial na Compreensão de Texto
A vetorização de texto consiste essencialmente em converter palavras em listas de números - construídas de tal forma que palavras com significados semelhantes recebem representações numéricas (vetores) semelhantes. Isto permite que o nosso chatbot "compreenda" as relações entre diferentes sequências de palavras. Por exemplo, as palavras "grande" e "enorme" seriam transformadas em listas numéricas muito semelhantes, enquanto "grande" e "formiga" receberiam representações totalmente distintas.
Ao analisar estas semelhanças e diferenças numéricas, o chatbot consegue inferir que "gato" e "cão" têm uma relação mais próxima do que "gato" e "verde".
Assim que os vetores são gerados, estas representações numéricas do conhecimento são armazenadas numa base de dados vetorial, juntamente com o conteúdo original. A base de dados vetorial funciona como um catálogo avançado de conhecimento vetorizado, otimizado para a recuperação rápida de significados relacionados.
A Base de Dados Vetorial: Uma Biblioteca de Conhecimento Inteligente
Para compreender melhor como funciona uma base de dados vetorial, usemos a analogia de uma biblioteca com um sistema de pesquisa inteligente. Cada "livro" (fragmento de texto) é "etiquetado" por um vetor único (uma sequência de números). Este código contém múltiplos números que representam o autor, o estilo e o tema do livro. Dois livros sobre temas semelhantes terão códigos muito parecidos.
Nesta "biblioteca", os livros são colocados em "prateleiras" num espaço multidimensional com base nos seus códigos. Livros com códigos semelhantes são agrupados perto uns dos outros - tal como livros na mesma categoria, mas adicionalmente organizados por semelhanças subtis de conteúdo. Quando coloca uma questão (por exemplo, "Qual é a receita do bolo de chocolate?"), esta é convertida num "código" desse tipo. O sistema de pesquisa inteligente na base de dados vetorial percorre as "prateleiras" (fragmentos de texto) à procura dos códigos que mais se aproximam do código da sua questão.
O algoritmo identifica rapidamente os "livros" (fragmentos) com maior probabilidade de conterem a resposta. Em vez de procurar em toda a "biblioteca", o chatbot localiza instantaneamente os fragmentos de conhecimento mais relevantes em termos de significado. Isto garante respostas mais rápidas, mais precisas e focadas no contexto.
O Que Acontece Quando Faz uma Pergunta?
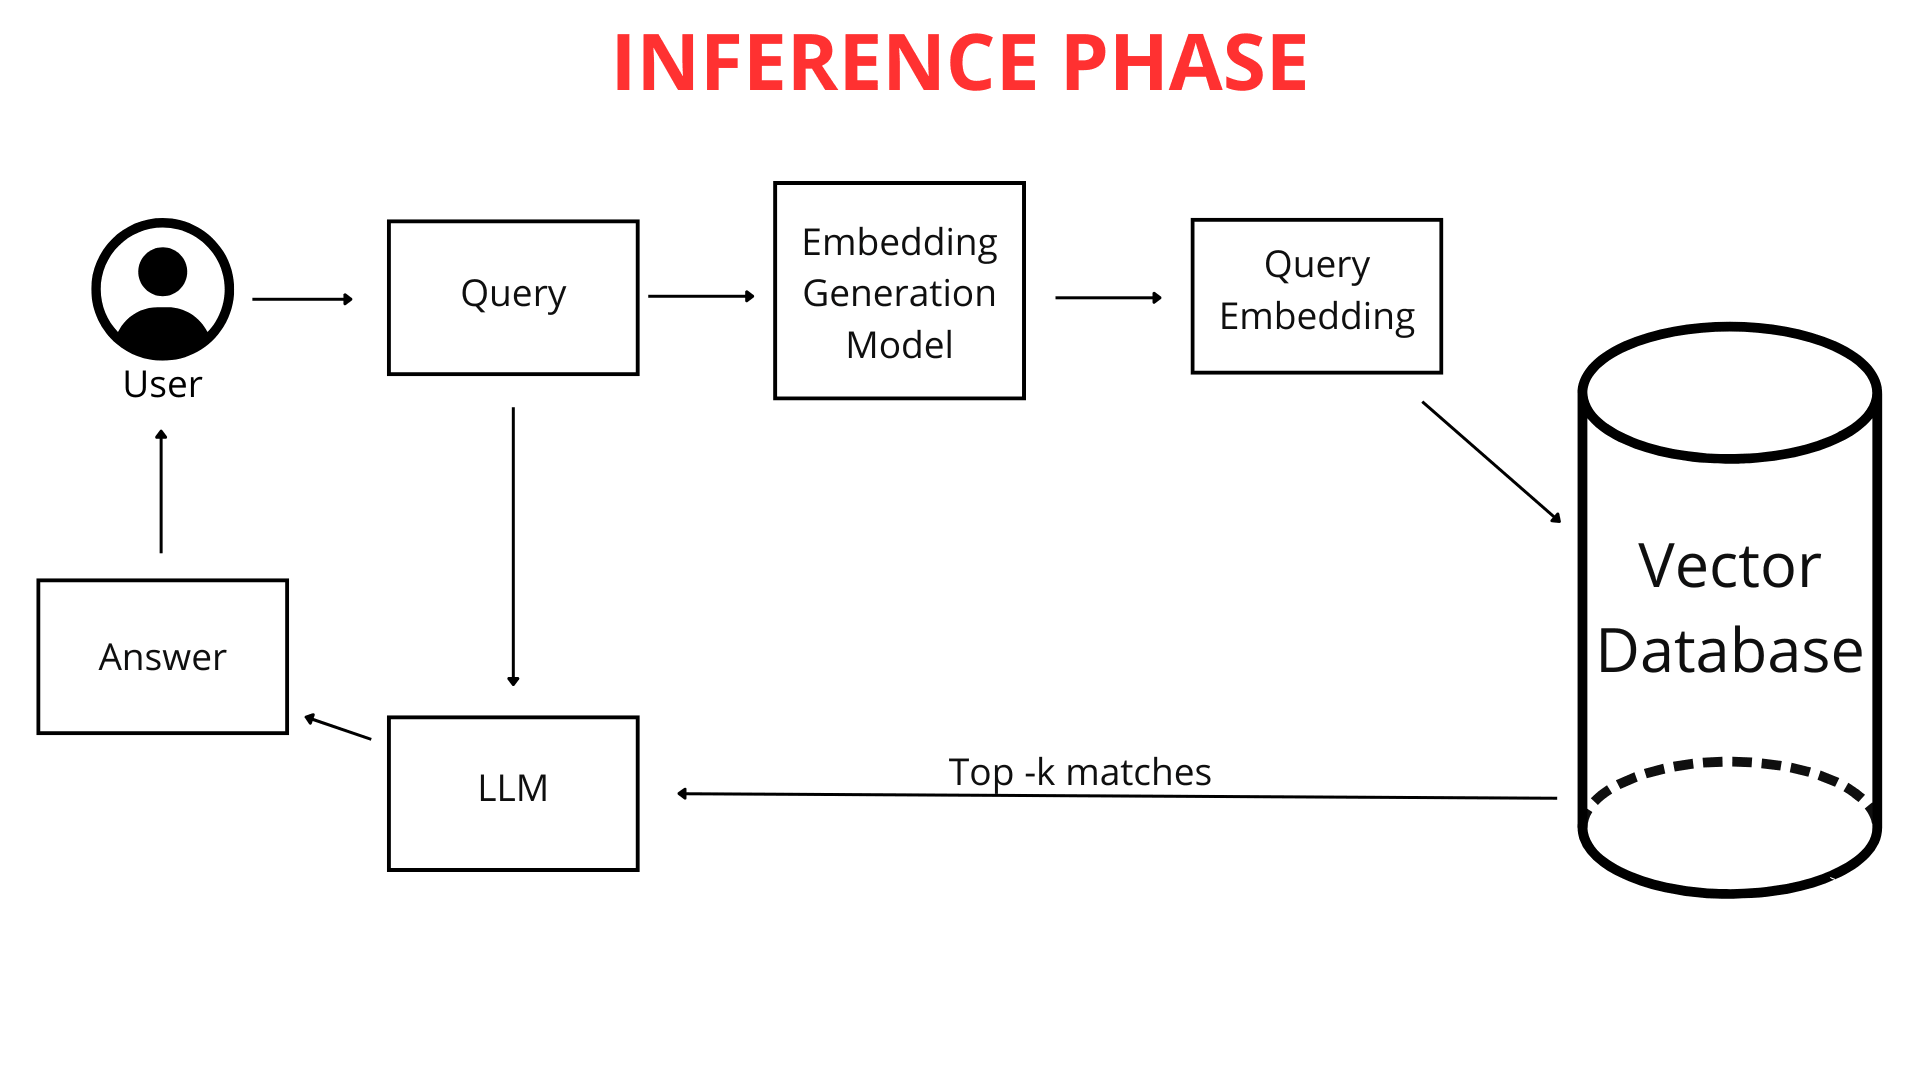
Quando, enquanto utilizador, escreve uma pergunta no chatbot (por exemplo, "Como está o tempo em Cracóvia amanhã?"), esta não é comparada de imediato com o conhecimento do chatbot em formato de texto simples. Em primeiro lugar, a pergunta é mapeada num vetor numérico. Como tanto a sua pergunta como toda a base de conhecimento do chatbot estão representadas no mesmo formato - como mapas vetoriais (listas de números) -, o chatbot consegue compará-las de forma eficiente. Identifica os fragmentos do seu conhecimento mais próximos do vetor da sua questão, o que lhe permite gerar a melhor resposta possível.
O RAG Entra em Ação
É aqui que a tecnologia RAG desempenha um papel determinante. O sistema RAG analisa a representação vetorial da sua questão e utiliza-a para pesquisar na base de dados vetorial as listas numéricas mais semelhantes (mais próximas no espaço multidimensional). Estes vetores mais semelhantes apontam para os fragmentos de ficheiro originais mais relevantes para a sua questão.
O RAG funciona como uma "ponte" inteligente entre a sua questão e a vasta base de conhecimento do chatbot. Permite a recuperação dinâmica apenas da informação estritamente necessária para que o LLM (Large Language Model) elabore uma resposta. Um LLM, em termos simples, é um algoritmo avançado e um conjunto de dados treinado em volumes maciços de texto, capaz de compreender e gerar linguagem natural. Para saber mais sobre esta tecnologia, consulte como funciona realmente o ChatGPT. Os LLMs conseguem responder a perguntas e até criar diversos tipos de conteúdo.
Sem o RAG, um LLM teria de depender unicamente do seu conhecimento pré-existente, que pode não incluir pormenores específicos dos seus ficheiros ou estar desatualizado. Graças ao RAG, o chatbot ganha a capacidade de recorrer a conhecimento externo adicional precisamente no momento em que faz uma pergunta. Este conhecimento atualizado provém diretamente dos seus ficheiros e páginas web carregados, que foram devidamente processados.
A Diferença Entre um Chatbot Com e Sem RAG
A principal diferença reside na forma como o conhecimento é acedido.
Conhecimento Treinado (Sem RAG): Trata-se do conhecimento "integrado" do LLM, adquirido durante um treino intensivo em vastos conjuntos de dados antes da sua interação com o ChatLab. Se perguntar sobre algo que não estava incluído nesses dados, o modelo pode simplesmente não saber a resposta.
Conhecimento dos Seus Ficheiros (Utilizado via RAG): Este é o seu conhecimento único e especializado, fornecido por si ao chatbot. O RAG permite ao chatbot aceder dinamicamente a este conhecimento ao responder a questões, combinando-o com o seu conhecimento geral de treino para gerar uma resposta completa. Esta abordagem impulsiona a moderna IA conversacional para apoio ao cliente.
Uma Analogia:
Imagine um LLM como um estudante extraordinariamente inteligente que leu inúmeros livros (dados de treino) e possui uma cultura geral impressionante. Agora, faculta-lhe os seus apontamentos e materiais das aulas (os seus ficheiros). O RAG atua como um sistema que permite a este estudante consultar rapidamente os seus apontamentos ao responder a uma pergunta, em vez de depender exclusivamente do que recorda de todos esses livros. Esta melhoria garante respostas superiores, mais precisas e - acima de tudo - mais atualizadas.
Graças ao RAG, o chatbot pode expandir o seu conhecimento com os seus dados exclusivos e utilizá-los ativamente nas interações. Não fica limitado apenas àquilo que aprendeu durante o seu treino inicial.
É por esta razão que o RAG é indispensável quando necessita de um chatbot para responder a perguntas sobre as suas informações específicas - detalhes que não estão disponíveis publicamente ou são demasiado de nicho para constar dos dados gerais de treino do LLM.
Se a sua pergunta for: "Onde posso encontrar livros sobre o espaço?", antes de o "bibliotecário" (chatbot) começar a "procurar nas prateleiras", este "traduz" primeiro a sua pergunta para a "linguagem das prateleiras" - identificando a categoria de livros adequada. Criar um mapa vetorial da sua pergunta é equivalente a catalogar a sua consulta em categorias que o chatbot compreende e a que consegue aceder através da base de dados vetorial.
A Fase de Treino e Utilização do Conhecimento
Tal como explicado anteriormente, a sua pergunta é convertida numa lista de números que representa o seu significado. O chatbot pesquisa de seguida na base de dados vetorial os vetores mais semelhantes que representam fragmentos de conhecimento. Quanto mais próximas forem as representações vetoriais, maior será a semelhança entre a sua pergunta e esses fragmentos de conhecimento.
O chatbot seleciona os fragmentos mais correspondentes do seu conhecimento pré-processado - aqueles cujos vetores estão mais próximos do mapa vetorial da sua pergunta. É importante notar que, ao analisar a sua consulta, o ChatLab tem em consideração não apenas a pergunta em si, mas também o contexto de toda a conversa até ao momento. Isto permite ao sistema RAG selecionar com maior precisão a melhor informação a partir das fontes de conhecimento associadas.
Por exemplo, se perguntar primeiro sobre "os modelos de telemóvel mais recentes" e em seguida perguntar "Têm boas câmaras?", o chatbot - ao recordar o contexto da conversa - compreende que continua a referir-se a esses telemóveis específicos.
Os fragmentos de conhecimento selecionados são combinados com a sua pergunta original e com as instruções da secção "Role & Behavior". Estas instruções, também conhecidas como prompt, representam o nosso conjunto personalizado de diretrizes para o chatbot. Se pretendermos que o chatbot adicione sempre uma hiperligação para a fonte no final da sua resposta ou saúde os utilizadores de uma forma específica, incluímos isso no prompt.
Isto gera uma consulta enriquecida, que é então enviada para o "cérebro" do chatbot - o modelo de linguagem de grande escala (LLM) da OpenAI, da Google ou de outros fornecedores.
O modelo de linguagem analisa este conjunto abrangente de informação: o prompt, o histórico de conversação e o conhecimento recuperado para a consulta do utilizador. Adicionalmente, o LLM recorre ao seu conhecimento geral do mundo para formular uma resposta. Isto viabiliza experiências de cliente altamente personalizadas com IA. Por fim, a resposta aprimorada e refinada é apresentada na interface limpa do ChatLab.
Resumo
Neste artigo, explorámos a arquitetura do sistema RAG no funcionamento de um chatbot - desde a introdução dos dados até à criação da resposta. O RAG é um componente fundamental dos sistemas conversacionais modernos, permitindo a utilização eficiente de conhecimento externo. Empresas como o ChatLab integram ativamente esta tecnologia inovadora nos seus produtos, proporcionando aos clientes capacidades de interação avançadas e inteligentes.
Embora o sistema RAG apresente alguma complexidade técnica, o seu impacto no texto gerado por IA é inegável. O facto de ser utilizado com sucesso por empresas tecnológicas de referência como a Google, a Microsoft e a Amazon reforça o seu papel central na evolução contínua da inteligência artificial.
Preparado para experimentar a tecnologia RAG em primeira mão? Explore as funcionalidades do ChatLab ou descubra como criar o seu próprio chatbot de IA com base nesta tecnologia.


