Adăugarea surselor de tip website îi permite chatbotului dumneavoastră să învețe direct din conținutul site-ului dumneavoastră. Fie că este vorba despre detalii ale produselor, secțiuni de întrebări frecvente (FAQ) sau articole de blog, scanarea site-ului dumneavoastră web adaugă un instantaneu al conținutului acestuia, pe care chatbotul îl poate consulta. Reantrenați chatbotul atunci când acel conținut se modifică. Mai întâi creați-vă chatbotul și verificați capacitatea sa de antrenare.
Gestionați un magazin online? Când produsele provin din AI Search sau din căutarea în timp real din magazin, excludeți paginile de produse și categorii din scanare și scanați doar paginile informative, cum ar fi cele de livrare, retururi și FAQ. Paginile de produse scanate consumă caractere de antrenare, iar prețurile și stocurile acestora devin neactualizate între scanări. Consultați Cum să configurați ChatLab pentru magazinul dumneavoastră de e-commerce.
Unde găsiți trenarea pe baza site-ului
Selectați chatbotul dumneavoastră, apoi navigați la fila Training (Trenare). În bara laterală din stânga, alegeți Links (Linkuri). Aici gestionați toate sursele de trenare bazate pe site-uri web.
Faceți clic pe Add New Training: Website (Adaugă o trenare nouă: Site web) pentru a deschide formularul de trenare.
Opțiuni de scanare
Formularul de trenare vă oferă două modalități de a adăuga conținut de pe site, separate printr-un separator OR (SAU).
Scan website contents (Scanează conținutul site-ului) - Introduceți o adresă URL în câmpul Address (Adresă) și alegeți între:
- Whole website (Site-ul întreg) - Parcurge toate paginile identificabile, pornind de la adresa URL furnizată
- Single address (Adresă unică) - Scanează doar pagina specifică pe care o introduceți
Use sitemap (Folosește sitemap) - Introduceți adresa URL a fișierului sitemap (de exemplu https://www.yourdomain.com/sitemap.xml) în câmpul Sitemap. Această opțiune scanează doar paginile listate în fișierul dumneavoastră sitemap.
Atunci când folosiți un sitemap, câmpul Address este dezactivat automat (și invers), deoarece puteți utiliza o singură metodă per sarcină de trenare.

Trenarea pe întregul site
- Introduceți adresa URL principală a site-ului dumneavoastră în câmpul Address (de exemplu
https://www.yourdomain.com) - Selectați Whole website din meniul derulant de sub câmpul de adresă
- Faceți clic pe Start scanning the website (Începe scanarea site-ului)
Sistemul urmărește linkurile identificabile respectând filtrele de scanare, adâncimea și limitele contului; este posibil să nu ajungă la fiecare pagină. Puteți monitoriza progresul în fila Trainings (Trenări), unde veți vedea în timp real numărul de linkuri scanate și caracterele de trenare colectate.

Trenarea pe o singură pagină
- Introduceți adresa URL a paginii specifice în câmpul Address (de exemplu
https://www.yourdomain.com/pricing) - Selectați Single address din meniul derulant
- Faceți clic pe Start scanning the website
Acest lucru este util atunci când trebuie să adăugați o singură pagină specifică în baza de cunoștințe a chatbotului, de exemplu un articol nou publicat sau o pagină FAQ actualizată.
Trenarea pe baza unui sitemap
- Introduceți adresa URL a fișierului sitemap în câmpul Sitemap (de exemplu
https://www.yourdomain.com/sitemap.xml) - Faceți clic pe Start scanning the website
Scanarea prin sitemap vă oferă un control precis asupra paginilor incluse, deoarece procesează exclusiv adresele URL listate în fișierul sitemap.
Selectarea paginilor individuale pentru trenare
Înainte de a începe o scanare, puteți activa comutatorul I want to select individual urls for training after scanning the website (Doresc să selectez adrese URL individuale pentru trenare după scanarea site-ului). Această opțiune este disponibilă doar atunci când scanați un site întreg (nu și pentru modul cu adresă unică).
Când este activată:
- Sistemul vă scanează site-ul și descoperă toate paginile
- După finalizarea scanării, veți vedea o vizualizare arborescentă a tuturor paginilor descoperite, împreună cu numărul lor de caractere
- Bifați sau debifați paginile pentru a le include sau exclude din trenare
- Faceți clic pe Start the Training (Începe trenarea) pentru a iniția trenarea pe paginile selectate
Acest lucru este util atunci când site-ul dumneavoastră conține pagini din care nu doriți ca chatbotul să învețe, cum ar fi paginile de autentificare, secțiunile de administrare sau secțiunile irelevante.
Scanarea limbilor site-ului web
Dacă site-ul dumneavoastră este publicat în mai multe limbi, ChatLab detectează limbile disponibile în timpul scanării și vă permite să decideți pe care dintre acestea să le includeți în baza de cunoștințe a chatbotului. Veți găsi aceste comenzi în secțiunea Languages (Limbi) din formularul de trenare, chiar deasupra Advanced settings (Setări avansate).

Acoperirea limbilor
Meniul derulant Language scope (Acoperirea limbilor) controlează cât de mult este scanat dintr-un site multilingv:
- Main website language (Limba principală a site-ului) - recomandat și selectat implicit atunci când funcția multilingvă nu este disponibilă și botul nu are opțiunea multilingvă activată. Este scanată doar limba principală a site-ului. Celelalte versiuni lingvistice sunt omise. Acest lucru vă menține datele de trenare concise și concentrate și utilizează mai puțin din capacitatea de trenare.
- All languages (Toate limbile) - recomandat și selectat implicit atunci când contul dumneavoastră include funcția multilingvă sau botul are opțiunea multilingvă activată. Scanează versiunile lingvistice descoperite ale site-ului. Această opțiune captează toate paginile localizate, dar colectează mai mult conținut și utilizează mai mult din capacitatea de trenare.
- Selected language (Limba selectată) - scanează o singură limbă pe care o alegeți dintre cele detectate pe site.
ChatLab detectează main language (limba principală) a site-ului pentru scanarea specifică unei limbi. Opțiunea implicită depinde de disponibilitatea funcției multilingve, nu de limba detectată. Când alegeți Selected language, limba principală detectată este preselectată automat și marcată ca „main” în listă. O puteți schimba cu oricare altă limbă detectată.
Detectarea limbii este disponibilă în orice plan, inclusiv în planul gratuit. Puteți modifica acoperirea înainte de scanare. Opțiunea New training with same parameters (Trenare nouă cu aceiași parametri) reutilizează acoperirea sarcinii anterioare, care poate fi diferită de setarea implicită a unei scanări noi.
Metoda de detectare a limbii
Când acoperirea este setată la Main website language sau Selected language, puteți alege modul în care ChatLab recunoaște versiunile lingvistice de pe site-ul dumneavoastră cu ajutorul meniului derulant Language detection method (Metoda de detectare a limbii):
- Hreflang attributes (recommended) (Atribute hreflang (recomandat)) - opțiunea implicită. Utilizează marcajul
hreflangșilangpe care majoritatea site-urilor multilingve îl oferă deja pentru a-și interconecta versiunile de limbă. - URL path prefix (/en/, /de/, ...) (Prefixul căii URL (/en/, /de/, ...)) - pentru site-urile care păstrează fiecare limbă sub un segment de cale precum
/en/,/de/sau/fr/, fără marcajhreflang.
Dacă ChatLab nu poate detecta automat limbile, puteți scana în continuare limba principală sau toate limbile. Când alegeți Selected language, introduceți mai întâi adresa site-ului dumneavoastră în câmpurile de mai sus, apoi selectați din nou opțiunea, astfel încât site-ul să poată fi analizat.
Pentru o prezentare generală a modului în care chatbotul utilizează apoi aceste versiuni lingvistice atunci când răspunde, consultați articolele Multilingual chatbots și Chatbot language setup. Modurile de limbă ale bazei de cunoștințe descrise acolo se bazează pe surse care au fost scanate cu detectarea limbii, astfel încât sursele mai vechi ar putea necesita retrenare pentru a beneficia pe deplin de acestea.
Setări avansate
Faceți clic pe butonul Advanced settings din formularul de trenare pentru a accesa comenzi detaliate de scanare.

Setările avansate sunt organizate în patru secțiuni:
URL Filtering (Filtrare URL-uri)
- Include only URLs that contain (Include doar URL-urile care conțin) - Scanează doar adresele URL care corespund acestor modele (separate prin punct și virgulă, de exemplu
/en;/help) - Exclude URLs that contain (Exclude URL-urile care conțin) - Omite adresele URL care corespund acestor modele (de exemplu
/news;/pictures). Modelele comune precum/wp-admin/,/feed/și paginile de coș sunt excluse în mod implicit
Query Parameters (Parametri de interogare)
- Ignore all query parameters (Ignoră toți parametrii de interogare) - Tratează adresele URL cu parametri de interogare diferiți ca fiind aceeași pagină (de exemplu,
/page?id=1și/page?id=2devin ambele/page) - Ignore specific query parameters (Ignoră parametri de interogare specifici) - Ignoră doar anumiți parametri (parametrii obișnuiți de urmărire precum
utm_source,fbclid,gclidsunt ignorați automat)
Content Filtering (Filtrare conținut)
- Include element IDs (Include ID-urile elementelor) - Extrage conținut doar din elemente HTML specifice (folosiți
#idpentru ID-uri,.classnamepentru clase,[data-id="82874db"]pentru elemente cu un anumit atribut, separate prin punct și virgulă) - Exclude element IDs (Exclude ID-urile elementelor) - Omite conținutul din elemente HTML specifice (de exemplu
footer;header;#navigation;[data-nosnippet]) - Apar comutatoare condiționate atunci când sunt configurate elemente de includere/excludere, permițându-vă să controlați dacă crawlerul urmărește linkurile găsite în interiorul acelor elemente
Scraping Behavior (Comportament de extragere)
- Scrape documents (Extrage documente) - Extrage conținut și din fișierele PDF găsite pe site
- Exclude image links (Exclude linkurile imaginilor) - Omite adresele URL ale imaginilor din setul de date de trenare
- Scrape hidden contents (Extrage conținutul ascuns) - Include conținutul din elementele HTML ascunse (activat implicit)
- Delay between pages (Întârziere între pagini) - Adaugă o întârziere în secunde între solicitările de pagini pentru a reduce încărcarea serverului
- Country code (Cod de țară) - Direcționează extragerea printr-un server proxy dintr-o anumită țară (cod din două litere, de exemplu
us)
Notificări prin e-mail
Comutatorul Email me when training is finished or needs my attention (Trimite-mi un e-mail când trenarea este finalizată sau necesită atenția mea) este activat implicit. Când este activ, primiți o notificare prin e-mail atunci când:
- Trenarea se finalizează cu succes
- Sistemul are nevoie de intervenția dumneavoastră (de exemplu, selectarea paginilor după o scanare)
- Apar probleme în timpul trenării
Puteți modifica adresa de e-mail pentru notificări în câmpul de lângă comutator.
Monitorizarea progresului trenării
După pornirea unei scanări, comutați la fila Trainings pentru a monitoriza progresul. Fiecare sarcină de trenare afișează:
- Adresa URL sursă
- Starea curentă (Scanning links, Awaiting links selection, Training, Training completed)
- O bară de progres în timpul scanării active sau al trenării
- Data ultimei actualizări

Faceți clic pe More details (Mai multe detalii) pentru a vedea toți parametrii utilizați pentru o anumită sarcină de trenare, inclusiv eventualele setări avansate care au fost configurate.

Gestionarea linkurilor trenate
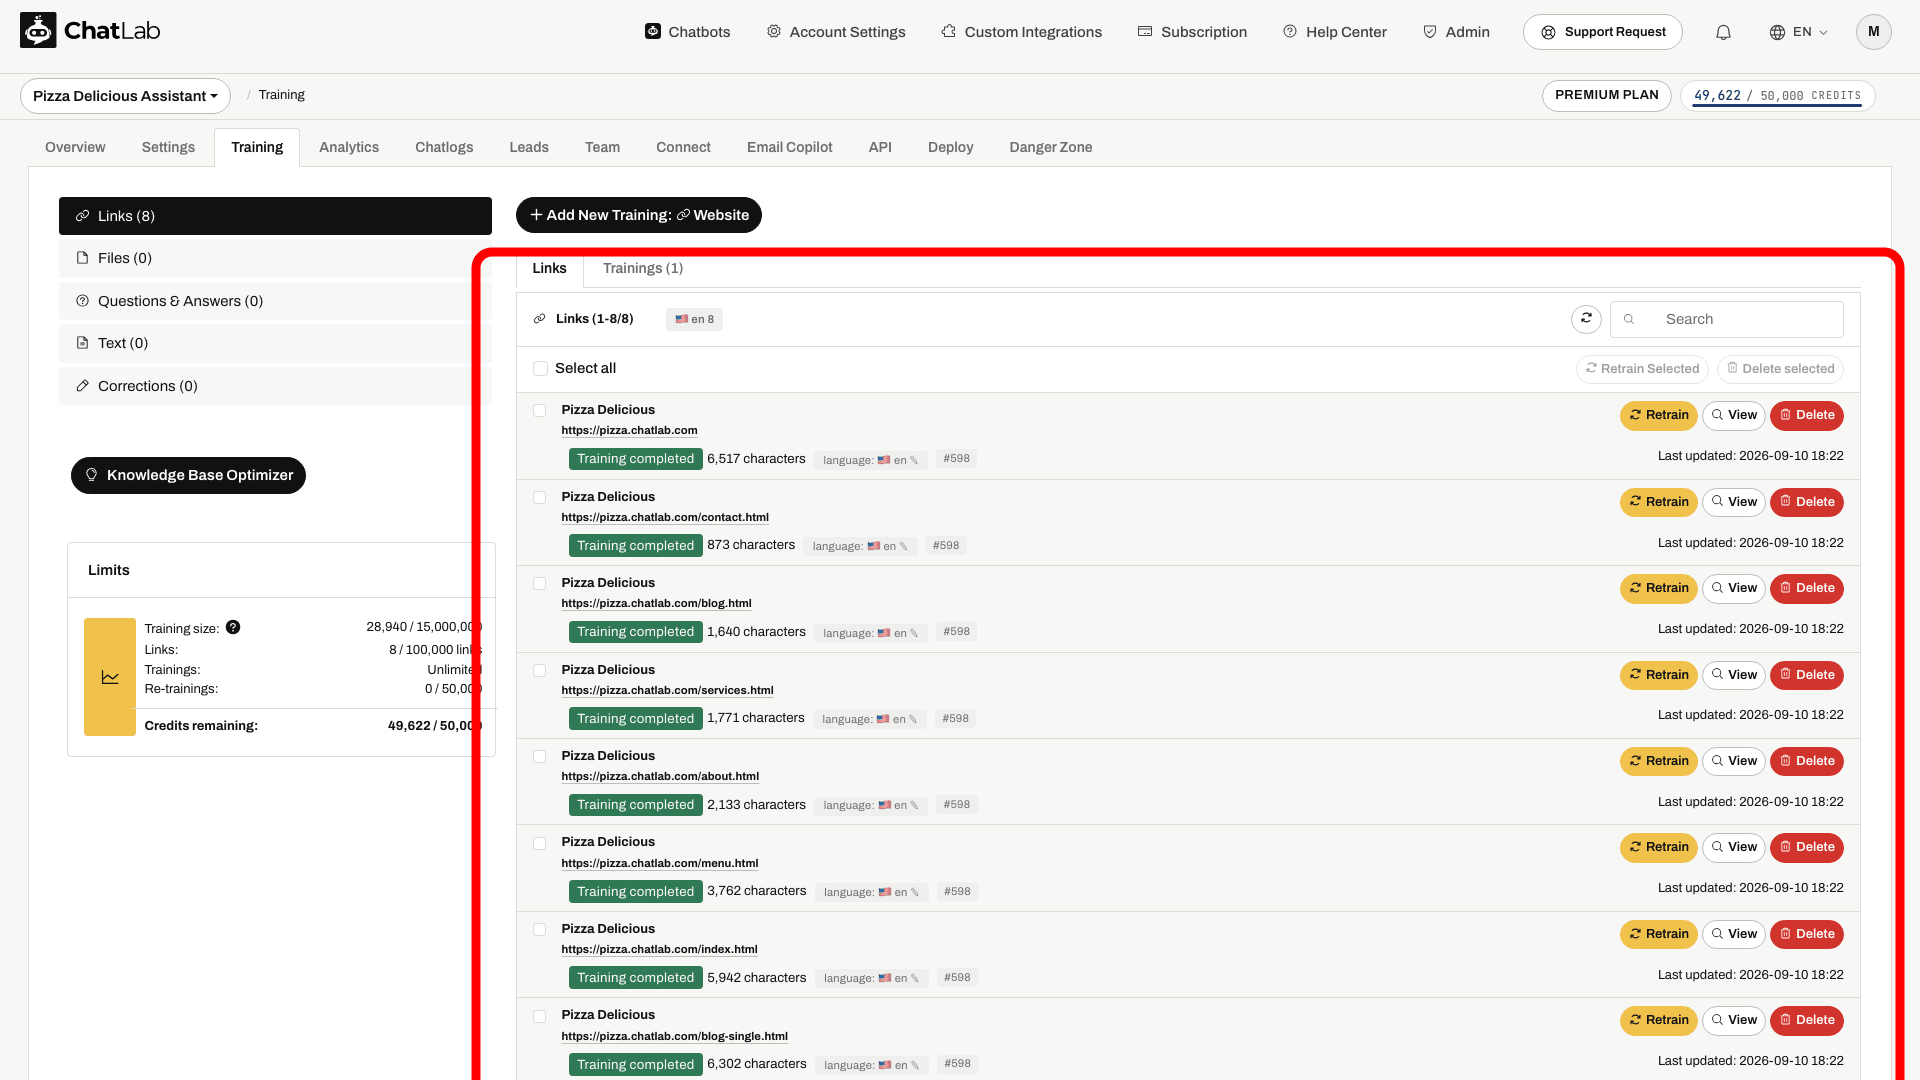
După finalizarea trenării, paginile trenate cu succes apar în fila Links. Paginile excluse prin setările dumneavoastră, lăsate neselectate sau respinse din cauza unei erori sau a unei limite nu devin garantat surse de trenare. Fiecare link afișează:
- Titlul paginii și adresa URL
- Numărul de caractere (dimensiunea datelor de trenare)
- Starea trenării
- Data ultimei actualizări
Pentru fiecare link puteți:
- Retrain (Retrenează) - Scanați din nou și actualizați conținutul pentru această pagină specifică
- View (Vizualizează) - Vedeți conținutul exact care a fost extras din pagină
- Delete (Șterge) - Eliminați această pagină din baza de cunoștințe a chatbotului dumneavoastră
Utilizați caseta de selectare Select all (Selectează tot) și butoanele de acțiuni în masă pentru a retrena sau a șterge mai multe linkuri simultan.
Vizualizarea conținutului scanat
Faceți clic pe butonul View de lângă orice link trenat pentru a vedea exact ce conținut a fost extras din pagina respectivă.

Fereastra modală de vizualizare a sursei afișează titlul paginii, adresa URL, numărul de caractere, data ultimei actualizări și conținutul text complet pe baza căruia a fost trenat chatbotul dumneavoastră. Acest lucru vă ajută să verificați dacă a fost captat conținutul corect și să înțelegeți baza de cunoștințe a chatbotului dumneavoastră.

Verificarea chatbotului finalizat
Scanarea și trenarea rulează în fundal și pot dura câteva minute sau mai mult în cazul site-urilor web de mari dimensiuni. Puteți părăsi această pagină și să pregătiți integrarea pe site între timp. Dacă sarcina indică Awaiting links selection, reveniți pentru a selecta paginile și a începe trenarea. Odată ce trenarea se finalizează, inspectați paginile importante folosind View, apoi deschideți Overview (Prezentare generală) și testați întrebări ale căror răspunsuri se regăsesc pe acele pagini. Examinați erorile și paginile lipsă înainte de a vă baza pe noul conținut.
Articole asociate
- Training in background - Aflați cum funcționează trenarea în fundal
- Re-training your chatbot - Cum să vă actualizați chatbotul cu conținut proaspăt
- How to reduce training characters when scanning a website - Sfaturi pentru optimizarea volumului de date de trenare
- Training your chatbot: basics and limits - Înțelegerea limitelor datelor de trenare