Dodanie źródeł stron internetowych pozwala Twojemu chatbotowi uczyć się bezpośrednio z treści Twojej witryny. Niezależnie od tego, czy chodzi o szczegóły produktów, sekcje FAQ czy wpisy na blogu, przeskanowanie strony dodaje migawkę jej zawartości, do której chatbot może się odnosić. Wytrenuj go ponownie, gdy te treści ulegną zmianie. Najpierw utwórz swojego chatbota i sprawdź jego limit znaków trenowania.
Prowadzisz sklep internetowy? Jeśli produkty pochodzą z funkcji AI Search lub wyszukiwania w sklepie na żywo, wyklucz ze skanowania strony produktów oraz kategorii i skanuj wyłącznie podstrony informacyjne, takie jak dostawa, zwroty czy FAQ. Przeskanowane strony produktów zużywają znaki trenowania, a ich ceny i stany magazynowe stają się nieaktualne między kolejnymi skanowaniami. Zobacz Jak skonfigurować ChatLab dla swojego sklepu e-commerce.
Gdzie znaleźć trenowanie na podstawie witryny
Wybierz swojego chatbota, a następnie przejdź do zakładki Training (Trenowanie). Na pasku bocznym po lewej stronie wybierz Links (Linki). W tym miejscu zarządzasz wszystkimi źródłami trenowania opartymi na stronach internetowych.
Kliknij Add New Training: Website (Dodaj nowe trenowanie: Witryna), aby otworzyć formularz trenowania.
Opcje skanowania
Formularz trenowania daje Ci dwa sposoby dodawania treści ze strony internetowej, rozdzielone separatorem LUB (OR).
Skanuj zawartość strony (Scan website contents) - wprowadź adres URL w polu Adres (Address) i wybierz jedną z opcji:
- Cała witryna (Whole website) - skanuje wszystkie wykrywalne strony, zaczynając od podanego adresu URL
- Pojedynczy adres (Single address) - skanuje tylko wskazaną przez Ciebie stronę
Użyj mapy strony (Use sitemap) - wprowadź adres URL mapy witryny (np. https://www.yourdomain.com/sitemap.xml) w polu Mapa strony (Sitemap). Spowoduje to przeskanowanie tylko stron wymienionych w Twoim pliku sitemap.
Gdy używasz mapy strony, pole Adres jest automatycznie wyłączane (i na odwrót), ponieważ w jednym zadaniu trenowania możesz użyć tylko jednej metody.

Trenuj na całej stronie internetowej
- Wpisz główny adres URL swojej strony w polu Address (Adres) (np.
https://www.yourdomain.com) - Z rozwijanej listy poniżej pola adresu wybierz Whole website (Cała strona)
- Kliknij Start scanning the website (Rozpocznij skanowanie strony)
System podąża za wykrytymi linkami w ramach filtrów skanowania, głębokości i limitów Twojego konta - może nie dotrzeć do każdej podstrony. Postęp możesz monitorować w zakładce Trainings (Trenowania), gdzie w czasie rzeczywistym zobaczysz liczbę przeskanowanych linków oraz zebranych znaków do trenowania.

Trenowanie na pojedynczej stronie
- Wprowadź adres URL konkretnej strony w polu Address (np.
https://www.yourdomain.com/pricing) - Wybierz Single address z listy rozwijanej
- Kliknij Start scanning the website
Jest to przydatne, gdy chcesz dodać do bazy wiedzy chatbota tylko jedną konkretną stronę, na przykład nowo opublikowany artykuł lub zaktualizowaną stronę FAQ.
Trenowanie na mapie witryny
- Wprowadź adres URL mapy witryny w polu Sitemap (np.
https://www.yourdomain.com/sitemap.xml) - Kliknij Start scanning the website
Skanowanie mapy witryny zapewnia dokładną kontrolę nad tym, które strony zostaną uwzględnione, ponieważ przetwarza wyłącznie adresy URL wymienione w pliku sitemap.
Wybór poszczególnych stron do trenowania
Przed rozpoczęciem skanowania możesz włączyć przełącznik I want to select individual urls for training after scanning the website (Chcę wybrać poszczególne adresy URL do trenowania po przeskanowaniu witryny). Opcja ta jest dostępna wyłącznie podczas skanowania całej witryny (nie działa w trybie pojedynczego adresu).
Po jej włączeniu:
- System skanuje Twoją witrynę i wykrywa wszystkie strony
- Po zakończeniu skanowania zobaczysz widok drzewa ze wszystkimi wykrytymi stronami oraz liczbą ich znaków
- Zaznacz lub odznacz strony, aby włączyć je do trenowania lub z niego wykluczyć
- Kliknij Start the Training (Rozpocznij trenowanie), aby rozpocząć trenowanie na wybranych stronach
Jest to pomocne, gdy Twoja witryna zawiera strony, których chatbot nie powinien przyswajać, takie jak ekrany logowania, panele administracyjne lub sekcje niemające znaczenia dla klientów.
Skanowanie wersji językowych strony
Jeśli Twoja strona internetowa jest publikowana w więcej niż jednym języku, ChatLab wykrywa dostępne języki podczas skanowania i pozwala Ci zdecydować, które z nich uwzględnić w bazie wiedzy bota. Te opcje znajdziesz w sekcji Języki (Languages) formularza trenowania, tuż nad sekcją Zaawansowane ustawienia (Advanced settings).

Zakres języków
Menu rozwijane Zakres języków (Language scope) określa, jaka część wielojęzycznej witryny ma zostać zeskanowana:
- Główny język strony (Main website language) - zalecany i domyślnie wybrany, gdy funkcja wielojęzyczności jest niedostępna, a bot nie ma włączonej obsługi wielu języków. Skanowany jest tylko główny język witryny. Inne wersje językowe są pomijane. Dzięki temu Twoje dane treningowe pozostają przejrzyste i uporządkowane, a także zużywają mniej limitu trenowania.
- Wszystkie języki (All languages) - zalecany i domyślnie wybrany, gdy Twoje konto zawiera funkcję wielojęzyczności lub bot ma włączoną obsługę wielu języków. Skanuje wykryte wersje językowe strony. Obejmuje to wszystkie Twoje zlokalizowane podstrony, ale pobiera więcej treści i zużywa większą część limitu trenowania.
- Wybrany język (Selected language) - skanuje jeden język wybrany przez Ciebie spośród wykrytych na stronie.
ChatLab wykrywa główny język witryny na potrzeby skanowania z określonym językiem. Domyślny zakres zależy od dostępności wielojęzyczności, a nie od tego, jaki język zostanie wykryty. Po wybraniu opcji Wybrany język (Selected language) wykryty język główny jest wstępnie zaznaczony i oznaczony na liście jako "main". Możesz zmienić go na dowolny inny wykryty język.
Wykrywanie języków jest dostępne w każdym planie, również w planie darmowym. Zakres możesz zmienić przed skanowaniem. Opcja Nowe trenowanie z tymi samymi parametrami (New training with same parameters) ponownie wykorzystuje zakres z wcześniejszego zadania, który może różnić się od domyślnego dla nowego skanowania.
Metoda wykrywania języka
Gdy zakres jest ustawiony na Główny język strony (Main website language) lub Wybrany język (Selected language), możesz wybrać, w jaki sposób ChatLab rozpoznaje wersje językowe w Twojej witrynie za pomocą menu rozwijanego Metoda wykrywania języka (Language detection method):
- Atrybuty hreflang (zalecane) (Hreflang attributes (recommended)) - opcja domyślna. Wykorzystuje znaczniki
hreflangilang, które większość wielojęzycznych witryn ma już wdrożone, aby łączyć ze sobą swoje wersje językowe. - Prefiks ścieżki URL (/en/, /de/, ...) (URL path prefix (/en/, /de/, ...)) - dla witryn, które utrzymują każdy język w osobnym segmencie ścieżki, takim jak
/en/,/de/lub/fr/, bez znacznikówhreflang.
Jeśli ChatLab nie może wykryć języków automatycznie, nadal możesz zeskanować język główny lub wszystkie języki. Po wybraniu opcji Wybrany język (Selected language) najpierw wpisz adres strony w polach powyżej, a następnie wybierz tę opcję ponownie, aby umożliwić analizę witryny.
Aby dowiedzieć się, jak Twój chatbot korzysta z tych wersji językowych podczas odpowiadania, zobacz Wielojęzyczne chatboty oraz Konfiguracja języka chatbota. Opisane tam tryby językowe bazy wiedzy opierają się na źródłach zeskanowanych z wykrywaniem języka, dlatego starsze źródła mogą wymagać ponownego wytrenowania, aby w pełni z nich skorzystać.
Zaawansowane ustawienia (Advanced settings)
Kliknij przycisk Zaawansowane ustawienia (Advanced settings) w formularzu trenowania, aby uzyskać dostęp do szczegółowych opcji skanowania.

Ustawienia zaawansowane są podzielone na cztery sekcje:
Filtrowanie URL (URL Filtering)
- Uwzględnij tylko adresy URL zawierające (Include only URLs that contain) - skanuj tylko adresy URL pasujące do tych wzorców (oddzielone średnikami, np.
/en;/help) - Wyklucz adresy URL zawierające (Exclude URLs that contain) - pomijaj adresy URL pasujące do tych wzorców (np.
/news;/pictures). Często spotykane wzorce, takie jak/wp-admin/,/feed/oraz strony koszyka, są domyślnie wykluczone
Parametry zapytania (Query Parameters)
- Ignoruj wszystkie parametry zapytania (Ignore all query parameters) - traktuj adresy URL z różnymi parametrami zapytania jako tę samą stronę (np. zarówno
/page?id=1, jak i/page?id=2stają się/page) - Ignoruj określone parametry zapytania (Ignore specific query parameters) - ignoruj tylko wybrane parametry (popularne parametry śledzące, takie jak
utm_source,fbclid,gclid, są ignorowane automatycznie)
Filtrowanie treści (Content Filtering)
- Uwzględnij identyfikatory elementów (Include element IDs) - pobieraj treść tylko z określonych elementów HTML (użyj
#iddla identyfikatorów,.classnamedla klas,[data-id="82874db"]dla elementów z danym atrybutem, oddzielając je średnikami) - Wyklucz identyfikatory elementów (Exclude element IDs) - pomijaj treść z określonych elementów HTML (np.
footer;header;#navigation;[data-nosnippet]) - Po ustawieniu elementów do uwzględnienia lub wykluczenia pojawiają się przełączniki warunkowe, które pozwalają kontrolować, czy crawler ma podążać za linkami znalezionymi wewnątrz tych elementów
Zachowanie scrapowania (Scraping Behavior)
- Scrapuj dokumenty (Scrape documents) - wyodrębniaj również treść z plików PDF znalezionych na stronie internetowej
- Wyklucz linki do obrazów (Exclude image links) - pomijaj adresy URL obrazów w zbiorze danych do trenowania
- Scrapuj ukryte treści (Scrape hidden contents) - uwzględniaj treść z ukrytych elementów HTML (opcja domyślnie włączona)
- Opóźnienie między stronami (Delay between pages) - dodaj opóźnienie w sekundach między żądaniami stron, aby zmniejszyć obciążenie serwera
- Kod kraju (Country code) - kieruj scrapowanie przez serwer proxy w określonym kraju (dwuliterowy kod, np.
us)
Powiadomienia e-mail
Przełącznik Email me when training is finished or needs my attention (Powiadom mnie e-mailem, gdy trenowanie się zakończy lub będzie wymagać mojej uwagi) jest domyślnie włączony. Gdy jest aktywny, otrzymasz powiadomienie e-mail, gdy:
- Trenowanie zakończy się pomyślnie
- System będzie wymagać Twojego działania (np. wyboru stron po przeskanowaniu)
- Podczas trenowania wystąpią jakiekolwiek problemy
Adres e-mail do powiadomień możesz zmienić w polu obok przełącznika.
Monitorowanie postępów trenowania
Po rozpoczęciu skanowania przejdź do zakładki Trainings, aby śledzić postępy. Każde zadanie trenowania wyświetla:
- Źródłowy adres URL
- Bieżący status (Scanning links, Awaiting links selection, Training, Training completed)
- Pasek postępu podczas aktywnego skanowania lub trenowania
- Datę ostatniej aktualizacji

Kliknij More details (Więcej szczegółów), aby zobaczyć wszystkie parametry użyte w danym zadaniu trenowania, w tym skonfigurowane ustawienia zaawansowane.

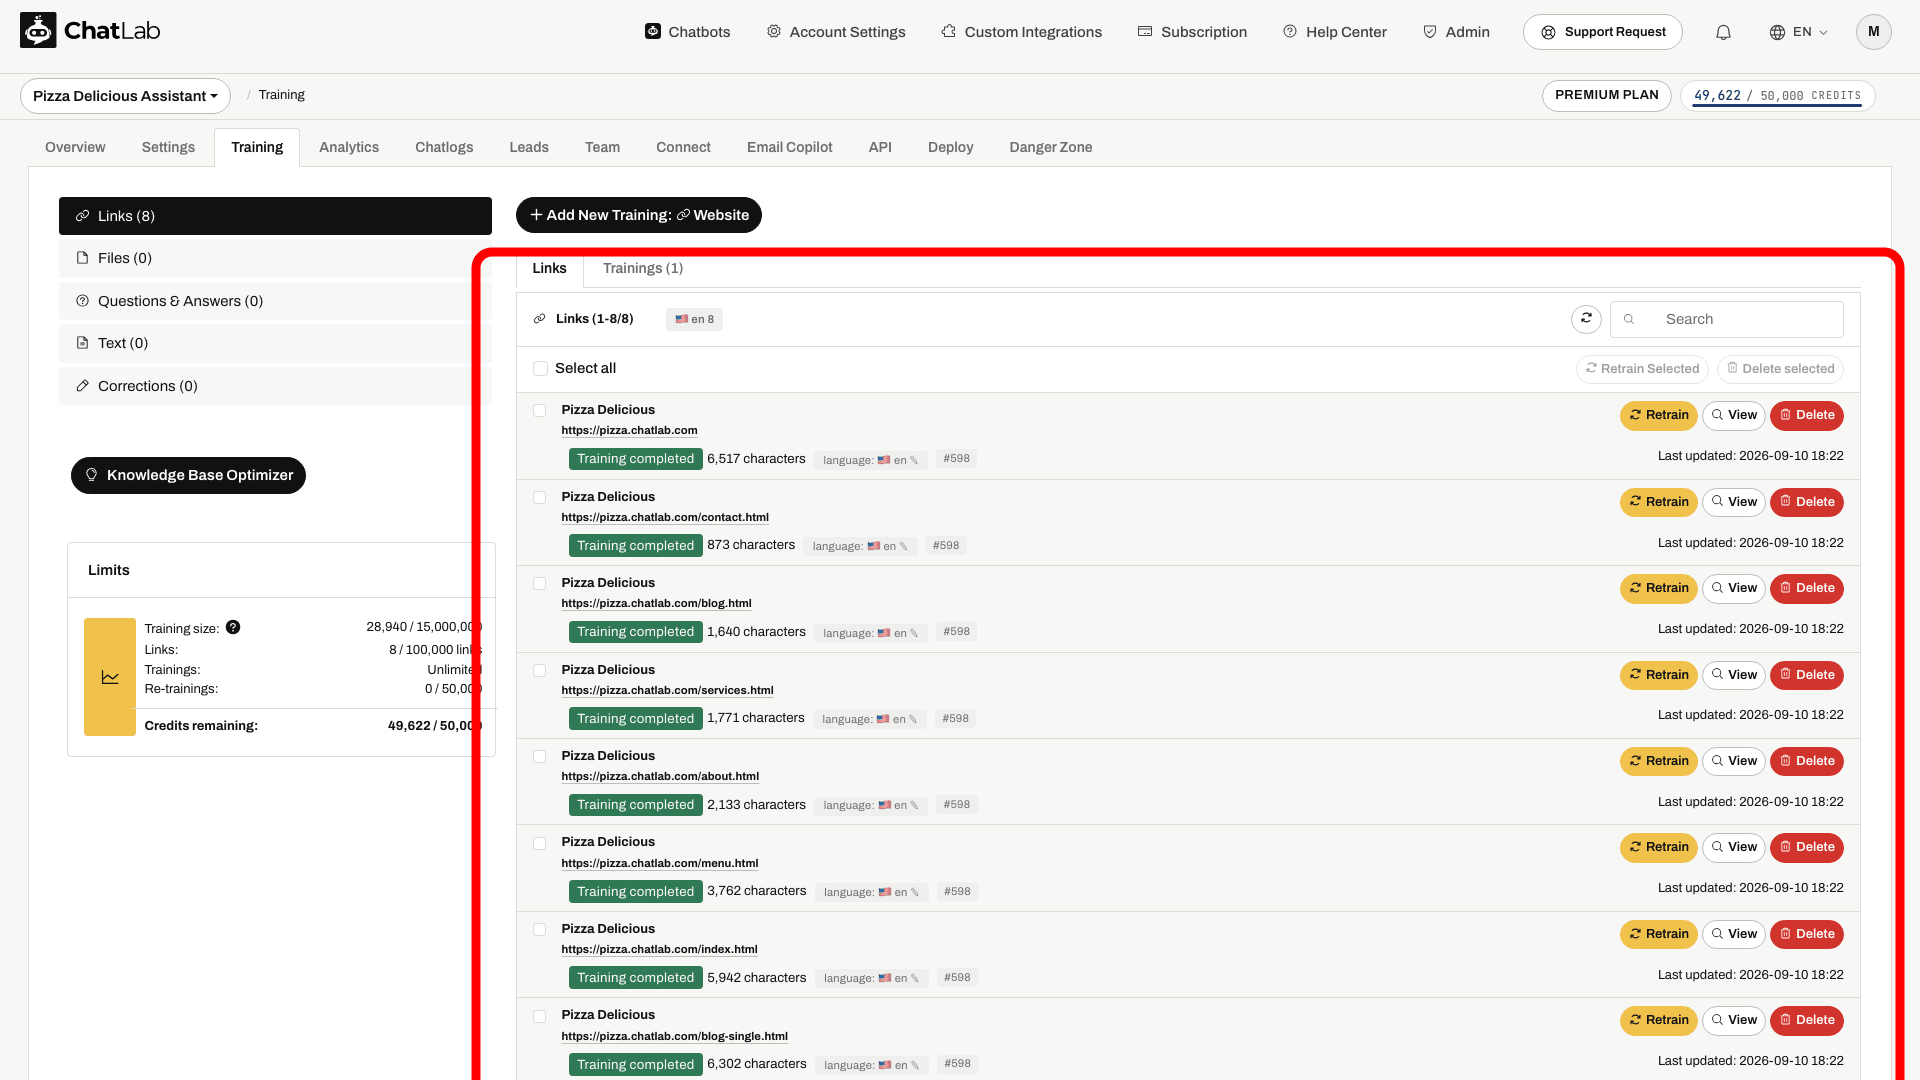
Zarządzanie wytrenowanymi linkami
Po zakończeniu trenowania pomyślnie wytrenowane strony pojawią się w zakładce Links (Linki). Strony wykluczone przez Twoje ustawienia, niezaznaczone lub odrzucone z powodu błędu bądź limitu nie mają gwarancji stania się źródłami trenowania. Każdy link zawiera:
- Tytuł strony i URL
- Liczbę znaków (rozmiar danych trenowania)
- Status trenowania
- Datę ostatniej aktualizacji
Dla każdego linku możesz:
- Retrain (Trenuj ponownie) - przeskanować ponownie i zaktualizować treść dla tej konkretnej strony
- View (Wyświetl) - zobaczyć dokładną treść, która została wyodrębniona ze strony
- Delete (Usuń) - usunąć tę stronę z bazy wiedzy Twojego chatbota
Użyj pola wyboru Select all (Zaznacz wszystko) oraz przycisków działań masowych, aby trenować ponownie lub usuwać wiele linków jednocześnie.
Przeglądanie przeskanowanej zawartości
Kliknij przycisk View obok dowolnego wytrenowanego linku, aby zobaczyć, jaka dokładnie treść została pobrana z danej strony.

Modal podglądu źródła wyświetla tytuł strony, adres URL, liczbę znaków, datę ostatniej aktualizacji oraz pełny tekst, na którym chatbot został wytrenowany. Pozwala to upewnić się, że pobrano właściwą zawartość, i ułatwia wgląd w bazę wiedzy chatbota.

Sprawdź gotowego chatbota
Skanowanie i trenowanie działają w tle i mogą zająć kilka minut lub dłużej w przypadku dużych stron internetowych. W tym czasie możesz opuścić tę stronę i przygotować kod do osadzenia na stronie (website embed). Jeśli zadanie ma status Awaiting links selection (Oczekiwanie na wybór linków), wróć, aby wybrać strony i rozpocząć trenowanie. Po zakończeniu trenowania sprawdź ważne strony za pomocą przycisku View (Wyświetl), a następnie otwórz zakładkę Overview (Przegląd) i przetestuj pytania, na które odpowiedzi znajdują się na tych stronach. Przejrzyj błędy i brakujące strony, zanim zaczniesz polegać na nowej zawartości.
Powiązane artykuły
- Trenowanie w tle - Dowiedz się, jak działa trenowanie w tle
- Ponowne trenowanie chatbota - Jak zaktualizować chatbota o nowe treści
- Jak zmniejszyć liczbę znaków trenowania podczas skanowania strony - Wskazówki dotyczące optymalizacji rozmiaru danych treningowych
- Trenowanie chatbota: podstawy i limity - Informacje o limitach danych treningowych