Door websitebronnen toe te voegen, kan je chatbot rechtstreeks leren van de inhoud van je website. Of het nu gaat om productgegevens, veelgestelde vragen of blogberichten: door je website te scannen, voeg je een momentopname van de inhoud toe die de chatbot als referentie kan gebruiken. Train opnieuw wanneer die inhoud verandert. Maak eerst je chatbot aan en controleer de trainingscapaciteit.
Heb je een webshop? Wanneer producten afkomstig zijn uit AI Search of live zoeken in de winkel, sluit dan product- en categoriepagina's uit van de scan en scan alleen informatieve pagina's zoals levering, retouren en veelgestelde vragen. Gescande productpagina's verbruiken trainingstekens en de prijzen en voorraad raken verouderd tussen de scans door. Zie Hoe je ChatLab instelt voor je e-commerce winkel.
Waar vind je websitetraining
Selecteer je chatbot en ga vervolgens naar het tabblad Training (Training). Kies in de linkerzijbalk voor Links (Links). Dit is de plek waar je alle op websites gebaseerde trainingsbronnen beheert.
Klik op Add New Training: Website (Nieuwe training toevoegen: Website) om het trainingsformulier te openen.
Scanopties
Het trainingsformulier biedt je twee manieren om websitecontent toe te voegen, gescheiden door een OR-scheidingsteken.
Scan website contents (Website-inhoud scannen) - Voer een URL in het veld Address (Adres) in en kies tussen:
- Whole website (Hele website) - Crawlt alle vindbare pagina's vanaf de ingevoerde URL
- Single address (Enkel adres) - Scant alleen de specifieke pagina die je invoert
Use sitemap (Sitemap gebruiken) - Voer de URL van je sitemap in (bijv. https://www.yourdomain.com/sitemap.xml) in het veld Sitemap. Dit scant alleen de pagina's die in je sitemapbestand worden vermeld.
Wanneer je een sitemap gebruikt, wordt het veld Address automatisch uitgeschakeld (en vice versa), omdat je slechts één methode per trainingstaak kunt gebruiken.

Trainen op de hele website
- Voer de hoofd-URL van je website in het veld Address (Adres) in (bijv.
https://www.yourdomain.com) - Selecteer Whole website (Hele website) in het keuzemenu onder het adresveld
- Klik op Start scanning the website (Website scannen starten)
Het systeem volgt vindbare links binnen de ingestelde filters, diepte en accountlimieten van de scan; het bereikt mogelijk niet elke pagina. Je kunt de voortgang volgen op het tabblad Trainings (Trainingen), waar je het aantal gescande links en verzamelde trainingstekens in realtime ziet.

Trainen op één pagina
- Voer de specifieke pagina-URL in het veld Address (Adres) in (bijv.
https://www.yourdomain.com/pricing) - Selecteer Single address (Enkel adres) in het dropdownmenu
- Klik op Start scanning the website (Website scannen starten)
Dit is handig wanneer je slechts één specifieke pagina hoeft toe te voegen aan de kennisbank van je chatbot, bijvoorbeeld een pas gepubliceerd artikel of een bijgewerkte FAQ-pagina.
Trainen op sitemap
- Voer je sitemap-URL in het veld Sitemap in (bijv.
https://www.yourdomain.com/sitemap.xml) - Klik op Start scanning the website (Website scannen starten)
Het scannen van een sitemap geeft je nauwkeurige controle over welke pagina's worden meegenomen, omdat alleen URL's worden verwerkt die in je sitemapbestand staan vermeld.
Afzonderlijke pagina's selecteren voor training
Voordat je een scan start, kun je de schakelaar I want to select individual urls for training after scanning the website (Ik wil afzonderlijke URL's selecteren voor training na het scannen van de website) inschakelen. Deze optie is alleen beschikbaar bij het scannen van een volledige website (niet voor de modus voor een enkel adres).
Wanneer ingeschakeld:
- Scant het systeem je website en ontdekt het alle pagina's
- Zie je na afloop van de scan een boomstructuur van alle gevonden pagina's met hun aantal tekens
- Vink je pagina's aan of uit om ze op te nemen in of uit te sluiten van de training
- Klik op Start the Training (Training starten) om te beginnen met het trainen op de door jou geselecteerde pagina's
Dit is handig wanneer je website pagina's bevat waarvan je niet wilt dat de chatbot erover leert, zoals inlogpagina's, beheeromgevingen of irrelevante secties.
Talen van de website scannen
Als je website in meer dan één taal is gepubliceerd, detecteert ChatLab de beschikbare talen tijdens het scannen en kun je bepalen welke talen in de kennisbank van je chatbot worden opgenomen. Je vindt deze instellingen in het gedeelte Languages (Talen) van het trainingsformulier, net boven Advanced settings (Geavanceerde instellingen).

Taalbereik
Het keuzemenu Language scope (Taalbereik) bepaalt welk deel van een meertalige site wordt gescand:
- Main website language (Hoofdtaal van de website) - aanbevolen en standaard geselecteerd wanneer de meertalige functie niet beschikbaar is en meertaligheid voor de bot niet is ingeschakeld. Alleen de hoofdtaal van de site wordt gescand. Andere taalversies worden overgeslagen. Dit houdt je trainingsgegevens compact en doelgericht, en verbruikt minder van je trainingscapaciteit.
- All languages (Alle talen) - aanbevolen en standaard geselecteerd wanneer je account de meertalige functie bevat of meertaligheid voor de bot is ingeschakeld. Scant gevonden taalversies van de site. Dit neemt al je gelokaliseerde pagina's mee, maar verzamelt meer inhoud en verbruikt meer trainingscapaciteit.
- Selected language (Geselecteerde taal) - scant een enkele taal die je kiest uit de talen die op de site zijn gedetecteerd.
ChatLab detecteert de hoofdtaal van de site voor taalspecifieke scans. Het standaardbereik hangt af van de beschikbaarheid van de meertalige functie, niet van welke taal is gedetecteerd. Wanneer je Selected language kiest, wordt de gedetecteerde hoofdtaal vooraf voor je geselecteerd en in de lijst gemarkeerd als "main". Je kunt dit wijzigen naar elke andere gedetecteerde taal.
Taaldetectie is beschikbaar op elk abonnement, inclusief het FREE-plan. Je kunt het bereik vóór het scannen wijzigen. New training with same parameters (Nieuwe training met dezelfde parameters) hergebruikt het bereik van de eerdere taak, wat kan afwijken van de standaardwaarde voor een nieuwe scan.
Detectiemethode voor talen
Wanneer het bereik is ingesteld op Main website language of Selected language, kun je met het keuzemenu Language detection method (Taaldetectiemethode) kiezen hoe ChatLab de taalversies op je site herkent:
- Hreflang attributes (recommended) (Hreflang-attributen (aanbevolen)) - de standaardoptie. Maakt gebruik van de
hreflang- enlang-opmaak die de meeste meertalige sites al bieden om hun taalversies aan elkaar te koppelen. - URL path prefix (/en/, /de/, ...) (URL-padvoorvoegsel (/en/, /de/, ...)) - voor sites die elke taal onder een padsegment zoals
/en/,/de/of/fr/plaatsen zonderhreflang-opmaak.
Als ChatLab talen niet automatisch kan detecteren, kun je nog steeds de hoofdtaal of alle talen scannen. Wanneer je Selected language kiest, vul dan eerst je websiteadres in de bovenstaande velden in en kies de optie vervolgens opnieuw, zodat de site geanalyseerd kan worden.
Voor een overzicht van hoe je chatbot deze taalversies vervolgens gebruikt bij het beantwoorden, raadpleeg je Meertalige chatbots en Taalinstellingen van de chatbot. De daar beschreven taalmodi van de kennisbank zijn afhankelijk van bronnen die zijn gescand met taaldetectie, dus oudere bronnen moeten mogelijk opnieuw worden getraind om er optimaal gebruik van te maken.
Geavanceerde instellingen
Klik op de knop Advanced settings in het trainingsformulier om toegang te krijgen tot gedetailleerde scanopties.

De geavanceerde instellingen zijn onderverdeeld in vier secties:
URL-filtering
- Include only URLs that contain (Alleen URL's opnemen die het volgende bevatten) - Scan alleen URL's die overeenkomen met deze patronen (gescheiden door puntkomma's, bijv.
/en;/help) - Exclude URLs that contain (URL's uitsluiten die het volgende bevatten) - Sla URL's over die overeenkomen met deze patronen (bijv.
/news;/pictures). Veelvoorkomende patronen zoals/wp-admin/,/feed/en winkelwagenpagina's worden standaard uitgesloten
Queryparameters
- Ignore all query parameters (Alle queryparameters negeren) - Behandel URL's met verschillende queryparameters als dezelfde pagina (bijv.
/page?id=1en/page?id=2worden beide/page) - Ignore specific query parameters (Specifieke queryparameters negeren) - Negeer alleen bepaalde parameters (veelgebruikte trackingparameters zoals
utm_source,fbclid,gclidworden automatisch genegeerd)
Inhoudsfiltering
- Include element IDs (Element-ID's opnemen) - Extraheer alleen inhoud uit specifieke HTML-elementen (gebruik
#idvoor ID's,.classnamevoor classes,[data-id="82874db"]voor elementen met een specifiek attribuut, gescheiden door puntkomma's) - Exclude element IDs (Element-ID's uitsluiten) - Sla inhoud van specifieke HTML-elementen over (bijv.
footer;header;#navigation;[data-nosnippet]) - Er verschijnen voorwaardelijke schakelaars wanneer er op te nemen/uit te sluiten elementen zijn ingesteld, waarmee je kunt bepalen of de crawler links volgt die binnen die elementen worden gevonden
Scrapinggedrag
- Scrape documents (Documenten scrapen) - Extraheer ook inhoud uit PDF-bestanden die op de website worden gevonden
- Exclude image links (Afbeeldingslinks uitsluiten) - Sla afbeeldings-URL's over uit de trainingsgegevensset
- Scrape hidden contents (Verborgen inhoud scrapen) - Neem inhoud van verborgen HTML-elementen op (standaard ingeschakeld)
- Delay between pages (Vertraging tussen pagina's) - Voeg een vertraging in seconden toe tussen paginaverzoeken om de belasting van de server te verminderen
- Country code (Landcode) - Leid het scrapen via een proxyserver in een specifiek land (tweeletterige code, bijv.
us)
E-mailmeldingen
De schakelaar Email me when training is finished or needs my attention (Stuur mij een e-mail wanneer de training is voltooid of mijn aandacht nodig heeft) is standaard ingeschakeld. Indien actief ontvang je een e-mailmelding wanneer:
- De training met succes is voltooid
- Het systeem je input nodig heeft (bijv. het selecteren van pagina's na een scan)
- Er zich problemen voordoen tijdens de training
Je kunt het e-mailadres voor meldingen wijzigen in het veld naast de schakelaar.
Voortgang van de training volgen
Schakel na het starten van een scan over naar het tabblad Trainings om de voortgang te volgen. Elke trainingstaak toont:
- De bron-URL
- De huidige status (Scanning links, Awaiting links selection, Training, Training completed)
- Een voortgangsbalk tijdens het actief scannen of trainen
- De datum van de laatste update

Klik op More details (Meer details) om alle parameters te zien die voor een specifieke trainingstaak zijn gebruikt, inclusief eventueel geconfigureerde geavanceerde instellingen.

Getrainde links beheren
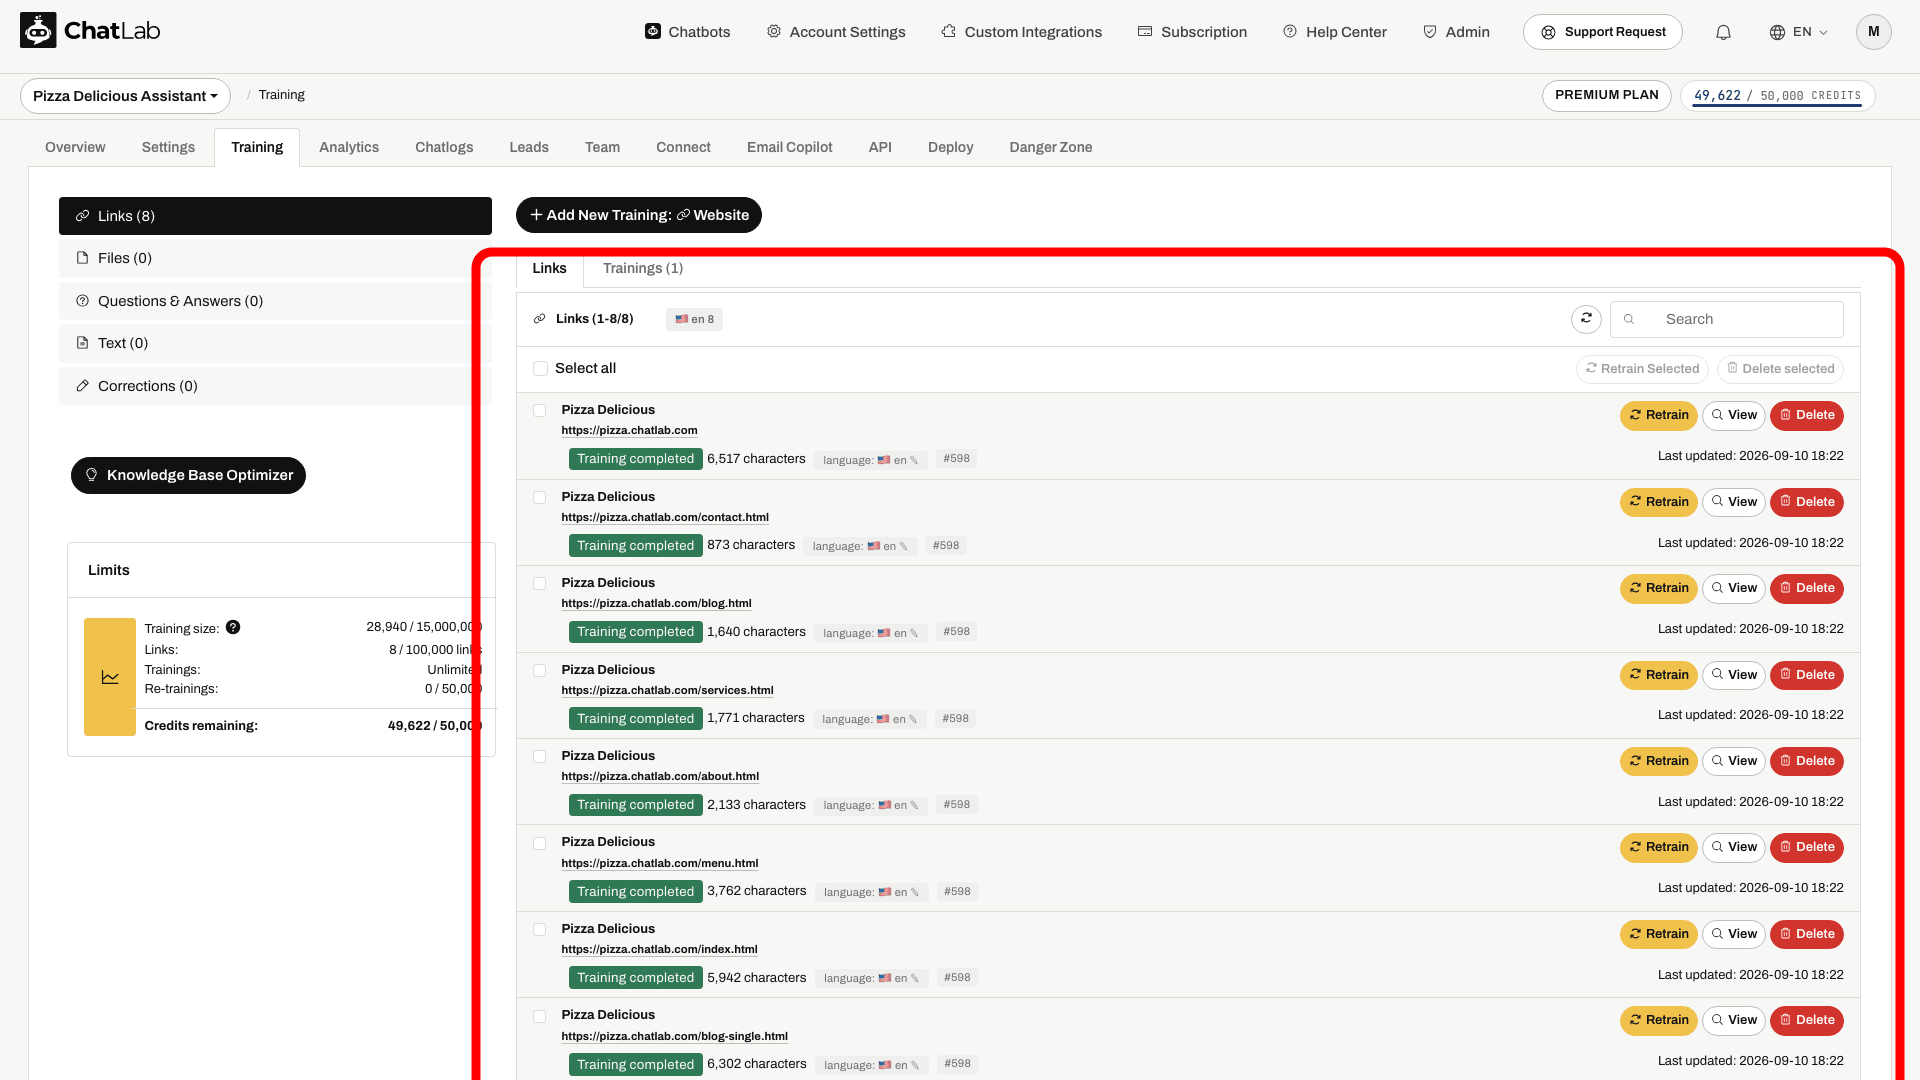
Nadat de training is voltooid, verschijnen succesvol getrainde pagina's op het tabblad Links. Pagina's die door je instellingen zijn uitgesloten, niet zijn geselecteerd of zijn afgewezen vanwege een fout of limiet, worden niet gegarandeerd allemaal trainingsbronnen. Elke link toont:
- Paginatitel en URL
- Aantal tekens (grootte van de trainingsgegevens)
- Trainingsstatus
- Datum van laatste update
Voor elke link kun je:
- Retrain (Opnieuw trainen) - De inhoud voor deze specifieke pagina opnieuw scannen en bijwerken
- View (Bekijken) - De exacte inhoud bekijken die van de pagina is geëxtraheerd
- Delete (Verwijderen) - Deze pagina verwijderen uit de kennisbank van je chatbot
Gebruik het selectievakje Select all (Alles selecteren) en de knoppen voor bulkacties om meerdere links tegelijk opnieuw te trainen of te verwijderen.
Gescande inhoud bekijken
Klik op de knop View naast een getrainde link om precies te zien welke inhoud van die pagina is geëxtraheerd.

Het modale venster voor het bekijken van de bron toont de paginatitel, URL, het aantal tekens, de datum van de laatste update en de volledige tekstinhoud waarop je chatbot is getraind. Dit helpt je te controleren of de juiste inhoud is verzameld en inzicht te krijgen in de kennisbank van je chatbot.

De voltooide chatbot controleren
Scannen en trainen worden op de achtergrond uitgevoerd en kunnen enkele minuten of langer duren bij grote websites. Je kunt deze pagina verlaten en ondertussen de website-insluiting voorbereiden. Als de taak de status Awaiting links selection heeft, ga dan terug om pagina's te selecteren en de training te starten. Zodra de training is voltooid, inspecteer je belangrijke pagina's met View, open je Overview (Overzicht) en test je vragen waarvan de antwoorden op die pagina's staan. Controleer eventuele fouten en ontbrekende pagina's voordat je vertrouwt op de nieuwe inhoud.
Gerelateerde artikelen
- Trainen op de achtergrond - Ontdek hoe trainen op de achtergrond werkt
- Je chatbot opnieuw trainen - Hoe je je chatbot bijwerkt met nieuwe inhoud
- Hoe je trainingstekens vermindert bij het scannen van een website - Tips voor het optimaliseren van de omvang van je trainingsgegevens
- Je chatbot trainen: basisprincipes en limieten - Inzicht in limieten voor trainingsgegevens