Comment ChatLab exploite la technologie RAG ?


Comment ChatLab exploite la technologie RAG ?
Chez ChatLab, nous créons des chatbots intelligents qui révolutionnent les interactions en ligne. Le principal moteur de leurs capacités est une technologie innovante appelée génération augmentée par récupération (RAG - Retrieval-Augmented Generation). Elle constitue le fondement de notre système et nous permet de fournir des solutions qui vont bien au-delà des conversations standards.
Dans le monde des chatbots, il existe deux méthodes d'entraînement principales. Comprendre les différents types de chatbots permet de mieux cerner les particularités de ces approches. La première méthode repose sur un entraînement intensif de réseaux de neurones complexes - un processus minutieux, long et coûteux. La seconde approche, que nous utilisons avec succès chez ChatLab, est le RAG. Non seulement elle est plus simple, plus rentable et plus rapide à mettre en place, mais elle offre également à nos chatbots un accès à des sources d'information externes illimitées - comme vos propres fichiers. Cela nous permet de générer des réponses extrêmement précises, adaptées au contexte et personnalisées.
Poursuivez votre lecture pour découvrir en détail comment la technologie RAG propulse ChatLab !
Qu'est-ce que le RAG exactement ?
Pour comprendre le fonctionnement de notre système, il est utile d'examiner de plus près la génération augmentée par récupération. Même si l'interaction avec un chatbot semble intuitive du point de vue de l'utilisateur, appréhender les mécanismes sous-jacents permet de mesurer tout son potentiel.
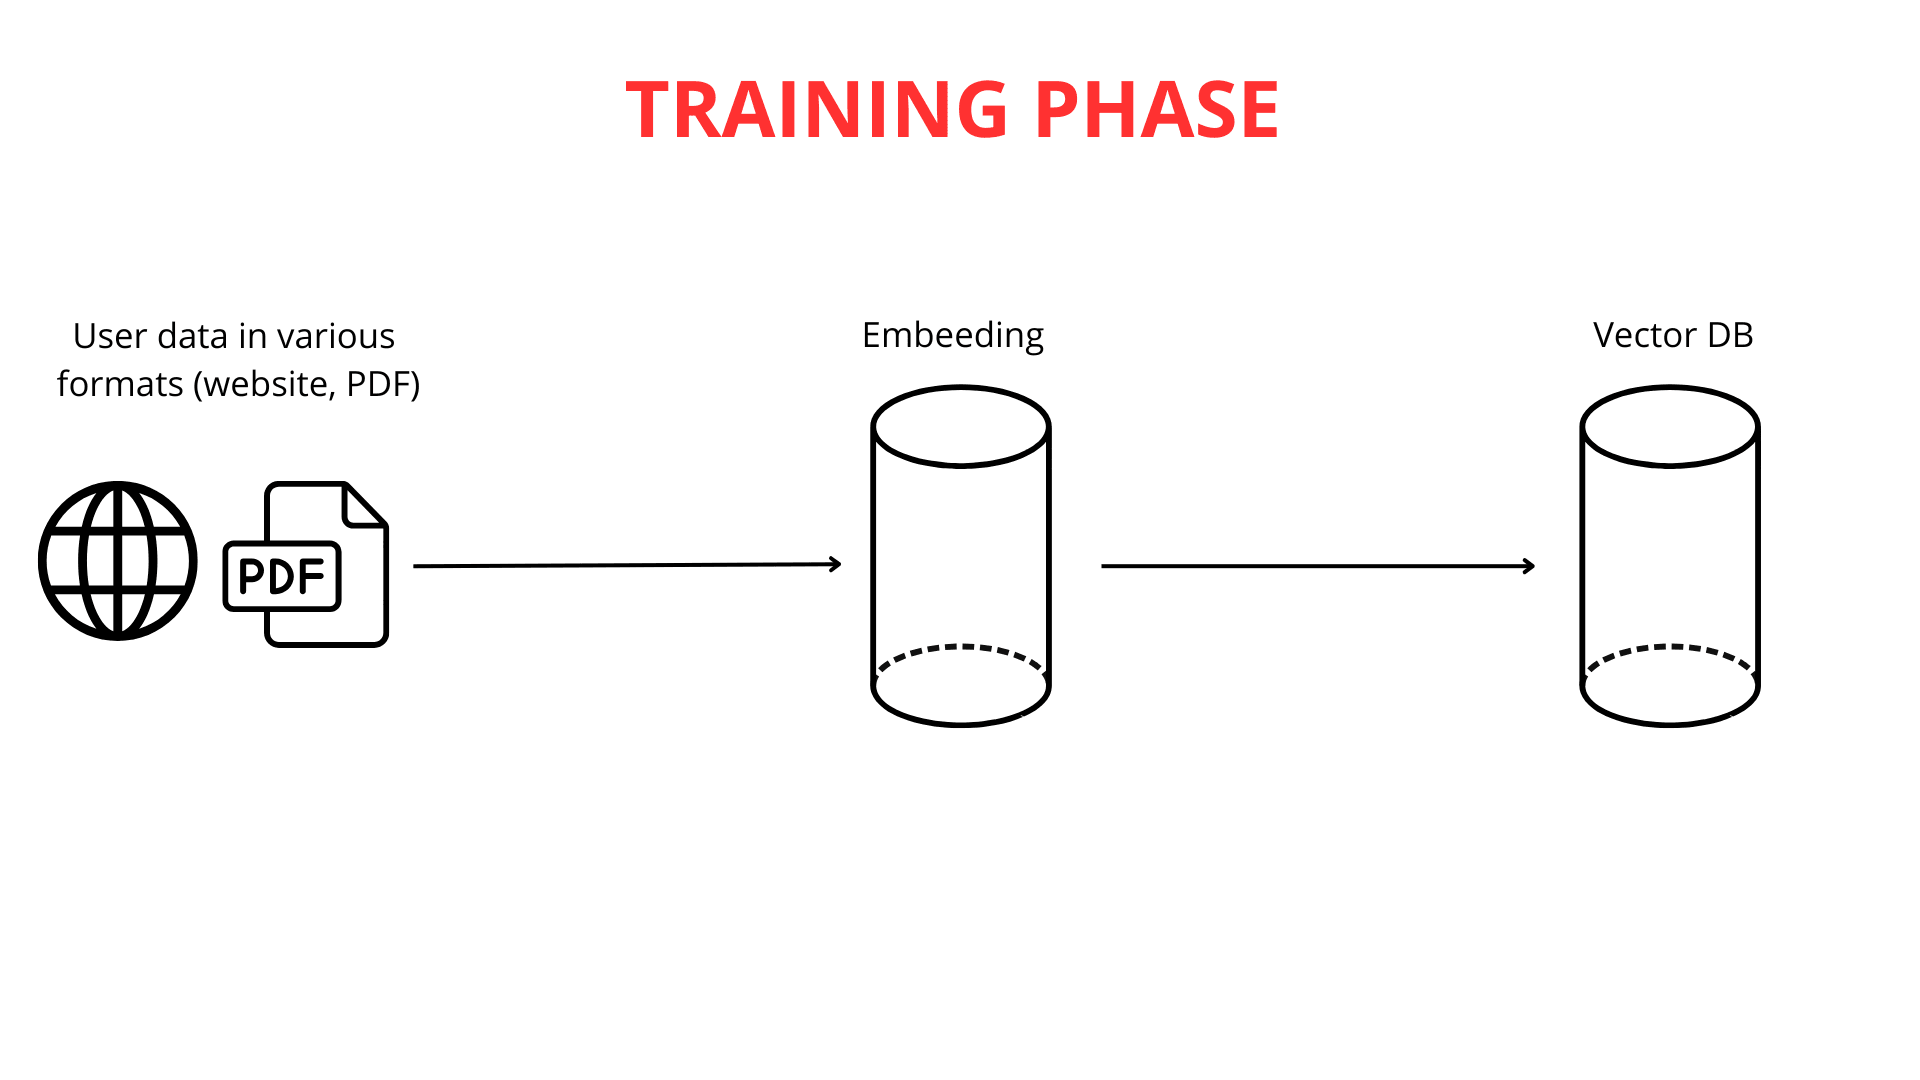
La création d'un chatbot intelligent s'appuie sur des connaissances issues de multiples disciplines scientifiques. La première étape, et la plus cruciale, consiste à alimenter le chatbot en données. Chez ChatLab, vous pouvez le faire de plusieurs manières pratiques : en important le contenu d'un site web, une documentation détaillée ou vos propres fichiers PDF. Les possibilités d'adaptation de la base de connaissances à vos besoins sont quasiment infinies.
L'étape suivante consiste à découper les textes longs en fragments plus courts (jusqu'à 600 tokens chacun), ce qui permet au système de traiter les informations de façon fluide. Une fois les données importées et segmentées, le processus de projection vectorielle commence.
Il est important de souligner que la transformation du texte en vecteurs est essentielle au bon fonctionnement du RAG. De puissants modèles de langage (LLM) se chargent de générer ces représentations vectorielles.
Le rôle de la projection vectorielle dans la compréhension du texte
La vectorisation de texte consiste concrètement à convertir des mots en listes de nombres - structurées de telle manière que les mots ayant un sens proche reçoivent des représentations numériques (vecteurs) similaires. Cela permet à notre chatbot de « comprendre » les relations entre différentes suites de mots. Par exemple, les mots « grand » et « immense » seront transformés en listes numériques très proches, tandis que « grand » et « fourmi » recevront des représentations totalement différentes.
En analysant ces proximités et ces écarts numériques, le chatbot peut déduire que « chat » et « chien » sont plus étroitement liés que « chat » et « vert ».
Une fois les vecteurs générés, ces représentations numériques du savoir sont stockées dans une base de données vectorielle aux côtés du contenu original. Cette base de données fait office de catalogue avancé de connaissances vectorisées, optimisé pour retrouver instantanément les sens apparentés.
La base de données vectorielle : une bibliothèque intelligente de connaissances
Pour mieux visualiser le fonctionnement d'une base de données vectorielle, prenons l'analogie d'une bibliothèque dotée d'un système de recherche intelligent. Chaque « livre » (fragment de texte) est associé à un vecteur unique (une suite de nombres). Ce code réunit plusieurs valeurs numériques qui décrivent l'auteur, le style et le sujet du livre. Deux ouvrages traitant de thématiques proches auront des codes très similaires.
Dans cette « bibliothèque », les livres sont disposés sur des « étagères » au sein d'un espace multidimensionnel en fonction de leurs codes. Les livres aux codes semblables sont rassemblés au même endroit - à la manière d'ouvrages appartenant à un même rayon, mais classés selon de fines nuances thématiques. Lorsque vous posez une question (par exemple : « Quelle est la recette du gâteau au chocolat ? »), celle-ci est convertie dans ce même format de « code ». Le moteur de recherche intelligent de la base vectorielle parcourt les « étagères » (les fragments de texte) pour trouver les codes qui correspondent le mieux à celui de votre demande.
L'algorithme identifie rapidement les « livres » (fragments) les plus susceptibles de contenir la réponse. Au lieu de fouiller toute la bibliothèque, le chatbot cible instantanément les éléments de connaissance les plus pertinents sur le plan sémantique. Cela garantit des réponses plus rapides, plus justes et parfaitement contextualisées.
Que se passe-t-il lorsque vous posez une question ?
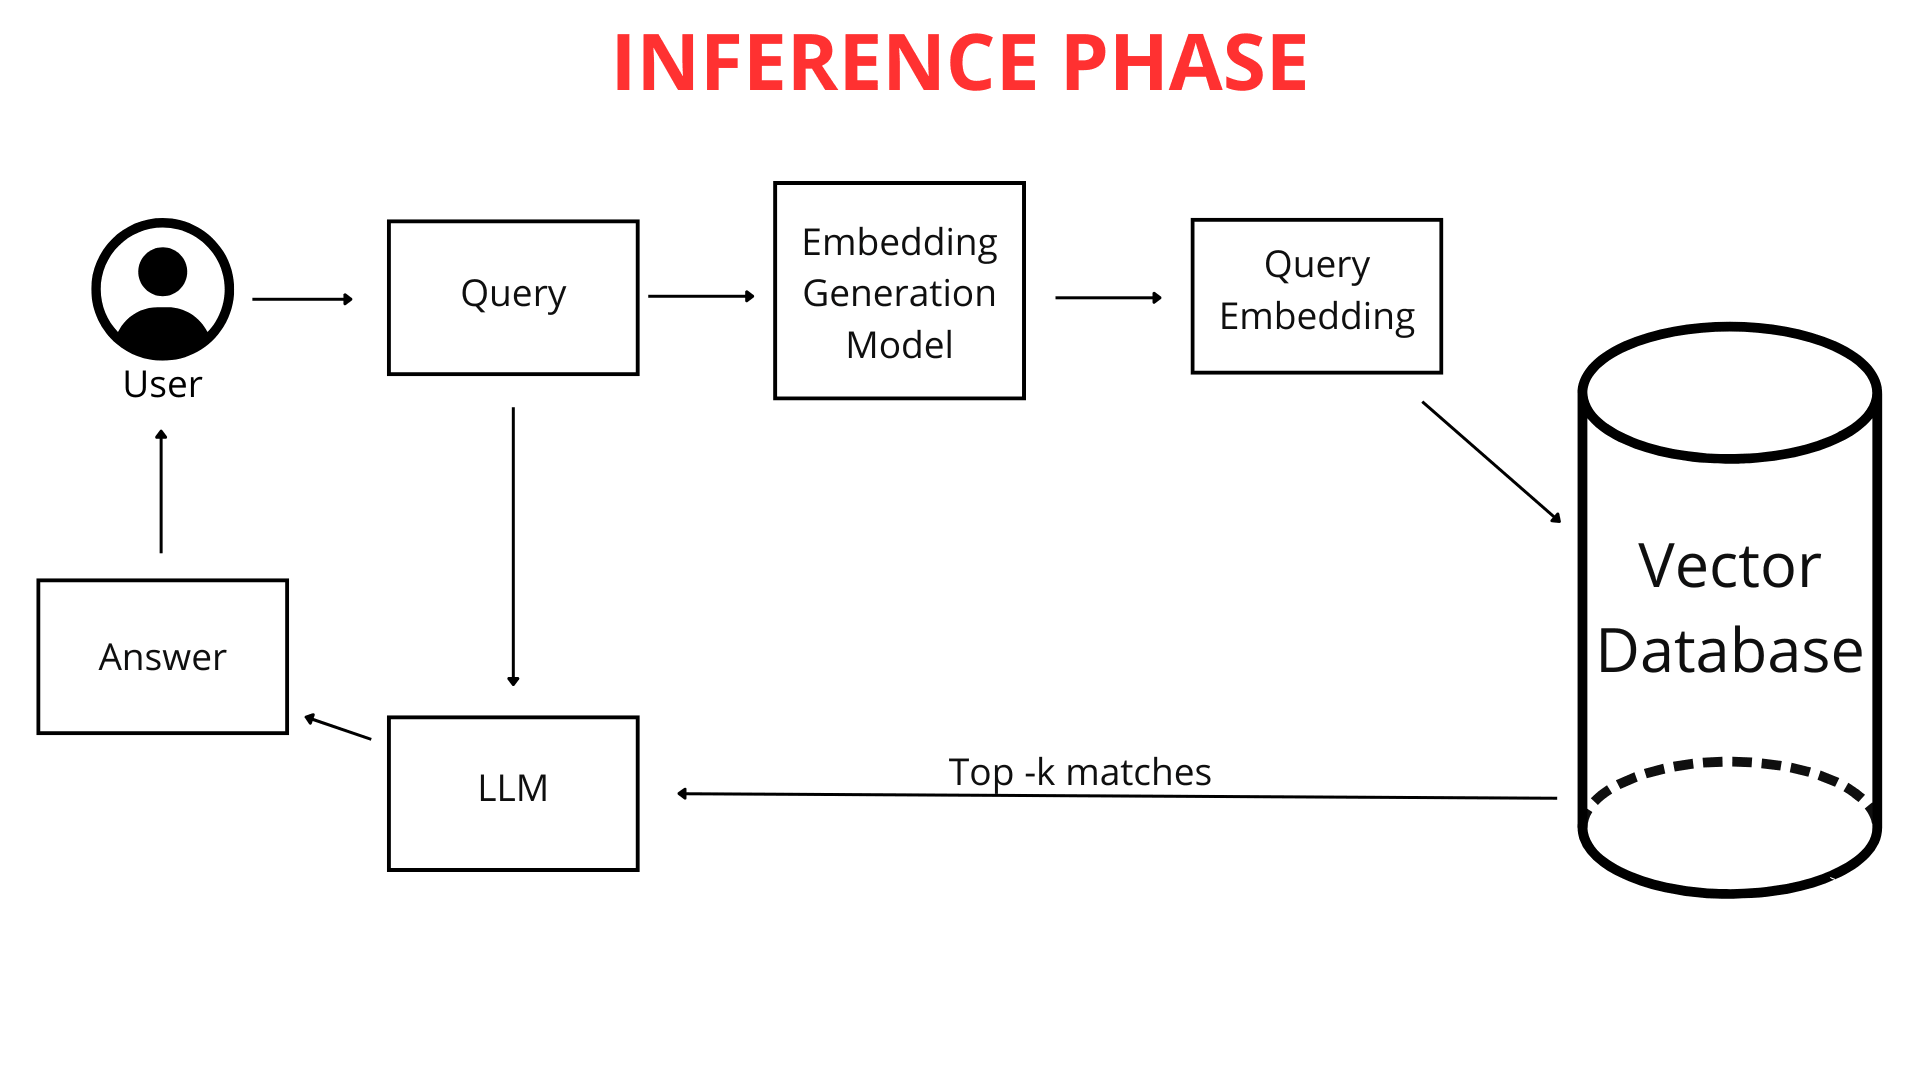
Lorsque vous saisissez une question dans le chatbot (par exemple : « Quel temps fera-t-il à Cracovie demain ? »), celle-ci n'est pas directement comparée aux connaissances du bot sous forme de texte brut. D'abord, la question est convertie en vecteur numérique. Dans la mesure où votre question et l'ensemble de la base de connaissances du chatbot partagent le même format - des cartes vectorielles (listes de nombres) -, le chatbot peut les comparer avec une grande efficacité. Il repère les fragments de son savoir les plus proches du vecteur de votre requête, ce qui lui permet de formuler la réponse la plus adaptée.
Le RAG entre en action
C'est ici que la technologie RAG joue un rôle déterminant. Le système RAG analyse la représentation vectorielle de votre requête et l'utilise pour rechercher dans la base vectorielle les listes numériques qui s'en rapprochent le plus (les plus proches dans l'espace multidimensionnel). Ces vecteurs désignent les extraits de vos documents originaux les plus pertinents pour répondre à votre demande.
Le RAG agit comme une passerelle intelligente entre votre question et la vaste base de connaissances du chatbot. Il permet d'extraire dynamiquement les seules informations indispensables au LLM (Large Language Model) pour élaborer sa réponse. Un LLM, pour faire simple, est un algorithme de pointe associé à un jeu de données entraîné sur des volumes massifs de textes, capable de comprendre et de produire du langage naturel. Pour explorer plus en détail cette technologie, découvrez comment fonctionne réellement ChatGPT. Les LLM peuvent répondre à des questions et même concevoir des contenus variés.
Sans le RAG, un LLM devrait s'en remettre exclusivement à ses connaissances intégrées, qui peuvent faire l'impasse sur des éléments spécifiques issus de vos documents ou devenir obsolètes. Grâce au RAG, le chatbot gagne la faculté de puiser dans des connaissances externes ciblées précisément au moment où vous l'interrogez. Ce savoir actualisé provient directement de vos fichiers et de vos pages web importés, après avoir été traités de manière optimale.
La différence entre un chatbot avec et sans RAG
La nuance fondamentale réside dans le mode d'accès aux connaissances.
Connaissances apprises (sans RAG) : il s'agit du savoir « intégré » du LLM, acquis au fil d'un entraînement intensif sur d'immenses jeux de données en amont de votre utilisation de ChatLab. Si vous posez une question sur un point absent de ces données, le modèle ne saura tout simplement pas quoi répondre.
Connaissances de vos fichiers (exploitées via le RAG) : il s'agit de votre expertise unique et spécifique, transmise directement au chatbot. Le RAG permet au bot de consulter ces informations de manière dynamique au moment de répondre, en les associant à son savoir général pour élaborer une réponse exhaustive. C'est cette méthode qui propulse l'IA conversationnelle moderne pour le service client.
Une analogie parlante :
Imaginez le LLM sous les traits d'un étudiant brillant qui aurait dévoré d'innombrables livres (les données d'entraînement) et accumulé une vaste culture générale. Vous mettez désormais à sa disposition vos propres notes de cours et vos polycopiés (vos fichiers). Le RAG fonctionne comme un outil permettant à cet étudiant de jeter un coup d'œil rapide à vos notes lorsqu'on lui pose une colle, plutôt que de se fier uniquement à ses souvenirs de lecture. Cette mécanique garantit des réponses plus pertinentes, plus précises et, surtout, toujours à jour.
Grâce au RAG, le chatbot enrichit son savoir avec vos données exclusives et les mobilise activement dans chaque échange. Il ne reste plus cantonné aux connaissances acquises lors de sa phase initiale d'entraînement.
C'est la raison pour laquelle le RAG devient indispensable dès lors que votre chatbot doit répondre sur des sujets qui vous sont propres - des informations non accessibles publiquement ou trop spécialisées pour faire partie des données d'entraînement général d'un LLM.
Si votre question est : « Où puis-je trouver des livres sur l'espace ? », le « bibliothécaire » (le chatbot) prend soin, avant de fouiller les rayons, de traduire votre demande dans le « langage du classement », identifiant ainsi la catégorie adéquate. Transformer votre question en carte vectorielle revient à classer votre requête dans des catégories compréhensibles par le chatbot et accessibles via la base vectorielle.
Phase d'entraînement et exploitation des connaissances
Comme nous l'avons vu plus haut, votre question est transformée en une suite de nombres reflétant son sens. Le chatbot explore alors la base de données vectorielle pour repérer les vecteurs les plus proches décrivant des extraits d'information. Plus les représentations vectorielles sont voisines, plus la proximité sémantique entre votre question et ces fragments de connaissances est forte.
Le chatbot sélectionne les extraits les plus pertinents de ses connaissances pré-traitées - ceux dont les vecteurs sont les plus proches de la carte vectorielle de votre question. Point important : lors de l'analyse de votre requête, ChatLab ne s'arrête pas à la question isolée, mais prend en compte le contexte global de la conversation en cours. Cela permet au système RAG d'extraire avec une grande finesse les informations les plus appropriées parmi les sources de connaissances connectées.
Par exemple, si vous demandez d'abord des précisions sur « les derniers modèles de téléphones », puis enchaînez avec « Ont-ils un bon appareil photo ? », le chatbot - gardant en mémoire le fil de la discussion - comprend immédiatement que vous faites toujours référence à ces modèles précis.
Les fragments de connaissances sélectionnés sont ensuite combinés avec votre question de départ et les consignes issues de la section « Role & Behavior ». Ces instructions, aussi appelées prompt, correspondent aux règles personnalisées que nous fixons pour guider le chatbot. Si nous souhaitons que le bot insère systématiquement un lien source à la fin de ses messages ou accueille les utilisateurs selon une formule précise, nous l'indiquons dans ce prompt.
Cette étape donne naissance à une requête augmentée, transmise ensuite au « cerveau » du chatbot - le grand modèle de langage (LLM) fourni par OpenAI, Google ou d'autres spécialistes du domaine.
Le modèle de langage examine cet ensemble d'informations structuré : le prompt, l'historique des échanges et les connaissances récupérées pour répondre à la demande de l'utilisateur. En complément, le LLM fait appel à sa culture générale du monde pour formuler sa réponse. Cela ouvre la voie à des expériences client hautement personnalisées grâce à l'IA. Enfin, la réponse finale, travaillée et limpide, s'affiche directement dans l'interface soignée de ChatLab.
En résumé
Tout au long de cet article, nous avons détaillé l'architecture du système RAG au cœur des chatbots - depuis l'intégration des données jusqu'à la formulation de la réponse. Le RAG s'impose comme un pilier des systèmes conversationnels actuels, assurant une exploitation fluide et ciblée des connaissances externes. Des plateformes comme ChatLab intègrent activement cette avancée technologique dans leurs solutions pour offrir aux entreprises des interactions intelligentes de haut niveau.
Même si le fonctionnement du RAG fait appel à des notions techniques élaborées, son apport sur la qualité des textes générés par l'IA est indéniable. Son adoption à grande échelle par des géants technologiques tels que Google, Microsoft ou Amazon confirme sa place centrale dans les évolutions actuelles de l'intelligence artificielle.
Envie d'expérimenter concrètement la technologie RAG ? Découvrez les fonctionnalités de ChatLab ou apprenez comment créer votre propre chatbot IA propulsé par cette solution.


