Durch das Hinzufügen von Website-Quellen kann Ihr Chatbot direkt aus den Inhalten Ihrer Website lernen. Ganz gleich, ob es sich um Produktdetails, FAQs oder Blogbeiträge handelt - beim Scannen Ihrer Website wird eine Momentaufnahme ihrer Inhalte erstellt, auf die der Chatbot zurückgreifen kann. Trainieren Sie ihn neu, sobald sich diese Inhalte ändern. Erstellen Sie zuerst Ihren Chatbot und überprüfen Sie dessen Trainingskapazität.
Betreiben Sie einen Online-Shop? Wenn Produkte über die AI Search oder die Live-Shop-Suche bezogen werden, schließen Sie Produkt- und Kategorieseiten vom Scan aus und scannen Sie nur Informationsseiten wie Lieferung, Retouren und FAQs. Gescannte Produktseiten verbrauchen Trainingszeichen, und ihre Preise sowie Bestände veralten zwischen den Scans. Siehe So richten Sie ChatLab für Ihren E-Commerce-Shop ein.
Wo Sie das Website-Training finden
Wählen Sie Ihren Chatbot aus und navigieren Sie dann zum Tab Training. Wählen Sie in der linken Seitenleiste Links aus. Hier verwalten Sie alle websitebasierten Trainingsquellen.
Klicken Sie auf Add New Training: Website (Neues Training hinzufügen: Website), um das Trainingsformular zu öffnen.
Scan-Optionen
Das Trainingsformular bietet Ihnen zwei Möglichkeiten, Website-Inhalte hinzuzufügen, getrennt durch ein OR-Trennzeichen (ODER).
Scan website contents (Website-Inhalte scannen) - Geben Sie eine URL in das Feld Address (Adresse) ein und wählen Sie zwischen:
- Whole website (Ganze Website) - Crawlt alle auffindbaren Seiten ausgehend von der angegebenen URL
- Single address (Einzelne Adresse) - Scannt nur die spezifische Seite, die Sie eingeben
Use sitemap (Sitemap verwenden) - Geben Sie Ihre Sitemap-URL (z. B. https://www.yourdomain.com/sitemap.xml) in das Feld Sitemap ein. Dadurch werden nur die Seiten gescannt, die in Ihrer Sitemap-Datei aufgeführt sind.
Wenn Sie eine Sitemap verwenden, wird das Feld Address automatisch deaktiviert (und umgekehrt), da Sie pro Trainingsauftrag nur eine Methode verwenden können.

Auf der gesamten Website trainieren
- Geben Sie die Root-URL Ihrer Website in das Feld Address (Adresse) ein (z. B.
https://www.yourdomain.com) - Wählen Sie im Dropdown-Menü unter dem Adressfeld Whole website (Ganze Website) aus
- Klicken Sie auf Start scanning the website (Website-Scan starten)
Das System folgt auffindbaren Links im Rahmen der Filter, der Tiefe und der Kontolimits des Scans; es erreicht möglicherweise nicht jede Seite. Sie können den Fortschritt im Tab Trainings überwachen, wo Sie die Anzahl der gescannten Links und die gesammelten Trainingszeichen in Echtzeit sehen.

Auf einer einzelnen Seite trainieren
- Geben Sie die URL der gewünschten Seite in das Feld Address ein (z. B.
https://www.yourdomain.com/pricing) - Wählen Sie Single address aus dem Dropdown-Menü
- Klicken Sie auf Start scanning the website
Dies ist nützlich, wenn Sie der Wissensdatenbank Ihres Chatbots nur eine bestimmte Seite hinzufügen müssen, beispielsweise einen neu veröffentlichten Artikel oder eine aktualisierte FAQ-Seite.
Auf Sitemap trainieren
- Geben Sie Ihre Sitemap-URL in das Feld Sitemap ein (z. B.
https://www.yourdomain.com/sitemap.xml) - Klicken Sie auf Start scanning the website
Das Scannen per Sitemap gibt Ihnen präzise Kontrolle darüber, welche Seiten berücksichtigt werden, da nur die in Ihrer Sitemap-Datei aufgeführten URLs verarbeitet werden.
Einzelne Seiten für das Training auswählen
Vor dem Start eines Scans können Sie den Schalter I want to select individual urls for training after scanning the website (Ich möchte nach dem Scannen der Website einzelne URLs für das Training auswählen) aktivieren. Diese Option ist nur verfügbar, wenn Sie eine ganze Website scannen (nicht im Modus für einzelne Adressen).
Wenn diese Option aktiviert ist:
- Das System scannt Ihre Website und erfasst alle Seiten
- Nach Abschluss des Scans sehen Sie eine Baumstruktur aller gefundenen Seiten mit der jeweiligen Zeichenanzahl
- Aktivieren oder deaktivieren Sie Seiten, um sie in das Training aufzunehmen oder davon auszuschließen
- Klicken Sie auf Start the Training (Training starten), um das Training mit den ausgewählten Seiten zu beginnen
Dies ist hilfreich, wenn Ihre Website Seiten enthält, aus denen der Chatbot nicht lernen soll, wie Login-Seiten, Admin-Bereiche oder irrelevante Abschnitte.
Website-Sprachen scannen
Wenn Ihre Website in mehreren Sprachen veröffentlicht ist, erkennt ChatLab die verfügbaren Sprachen beim Scannen und lässt Sie entscheiden, welche davon in die Wissensdatenbank Ihres Chatbots aufgenommen werden sollen. Sie finden diese Einstellungen im Bereich Languages (Sprachen) des Trainingsformulars, direkt über Advanced settings (Erweiterte Einstellungen).

Sprachumfang
Das Dropdown-Menü Language scope (Sprachumfang) steuert, wie viel von einer mehrsprachigen Website gescannt wird:
- Main website language (Hauptsprache der Website) - empfohlen und standardmäßig ausgewählt, wenn die Mehrsprachigkeitsfunktion nicht verfügbar ist und für den Bot keine Mehrsprachigkeit aktiviert ist. Es wird nur die Hauptsprache der Website gescannt. Andere Sprachversionen werden übersprungen. So bleiben Ihre Trainingsdaten schlank und fokussiert, und Sie verbrauchen weniger Trainingskapazität.
- All languages (Alle Sprachen) - empfohlen und standardmäßig ausgewählt, wenn Ihr Konto die Mehrsprachigkeitsfunktion enthält oder für den Bot Mehrsprachigkeit aktiviert ist. Scannt erkannte Sprachversionen der Website. Dadurch werden alle Ihre lokalisierten Seiten erfasst, es werden jedoch mehr Inhalte gesammelt und mehr von Ihrer Trainingskapazität verbraucht.
- Selected language (Ausgewählte Sprache) - scannt eine einzelne Sprache, die Sie aus den auf der Website erkannten Sprachen auswählen.
ChatLab erkennt die Hauptsprache der Website für das sprachspezifische Scannen. Der Standardumfang hängt von der Verfügbarkeit der Mehrsprachigkeit ab, nicht davon, welche Sprache erkannt wird. Wenn Sie Selected language wählen, ist die erkannte Hauptsprache für Sie vorausgewählt und in der Liste als "main" markiert. Sie können sie zu jeder anderen erkannten Sprache ändern.
Die Spracherkennung ist in jedem Tarif verfügbar, auch im kostenlosen Tarif. Sie können den Umfang vor dem Scannen ändern. Die Option New training with same parameters (Neues Training mit denselben Parametern) verwendet den Umfang des früheren Auftrags wieder, der vom Standard für einen neuen Scan abweichen kann.
Spracherkennungsmethode
Wenn der Umfang auf Main website language oder Selected language eingestellt ist, können Sie über das Dropdown-Menü Language detection method (Spracherkennungsmethode) wählen, wie ChatLab die Sprachversionen auf Ihrer Website erkennt:
- Hreflang attributes (recommended) (Hreflang-Attribute (empfohlen)) - der Standard. Verwendet das Markup
hreflangundlang, das die meisten mehrsprachigen Websites bereits bereitstellen, um ihre Sprachversionen miteinander zu verknüpfen. - URL path prefix (/en/, /de/, ...) (URL-Pfad-Präfix (/en/, /de/, ...)) - für Websites, die jede Sprache unter einem Pfadsegment wie
/en/,/de/oder/fr/ohne jeglicheshreflang-Markup führen.
Falls ChatLab Sprachen nicht automatisch erkennen kann, können Sie dennoch die Hauptsprache oder alle Sprachen scannen. Wenn Sie Selected language wählen, tragen Sie zuerst Ihre Website-Adresse in die obigen Felder ein und wählen Sie die Option dann erneut, damit die Website analysiert werden kann.
Eine Übersicht darüber, wie Ihr Chatbot diese Sprachversionen bei seinen Antworten verwendet, finden Sie unter Mehrsprachige Chatbots und Einrichtung der Chatbot-Sprache. Die dort beschriebenen Sprachmodi der Wissensdatenbank basieren auf Quellen, die mit Spracherkennung gescannt wurden. Ältere Quellen müssen daher möglicherweise neu trainiert werden, um alle Vorteile voll zu nutzen.
Erweiterte Einstellungen
Klicken Sie im Trainingsformular auf die Schaltfläche Advanced settings (Erweiterte Einstellungen), um auf detaillierte Scanning-Optionen zuzugreifen.

Die erweiterten Einstellungen sind in vier Bereiche unterteilt:
URL Filtering (URL-Filterung)
- Include only URLs that contain - Nur URLs scannen, die diesen Mustern entsprechen (durch Semikolon getrennt, z. B.
/en;/help) - Exclude URLs that contain - URLs überspringen, die diesen Mustern entsprechen (z. B.
/news;/pictures). Gängige Muster wie/wp-admin/,/feed/und Warenkorbseiten sind standardmäßig ausgeschlossen
Query Parameters (Abfrageparameter)
- Ignore all query parameters - URLs mit unterschiedlichen Abfrageparametern als dieselbe Seite behandeln (z. B. werden
/page?id=1und/page?id=2beide zu/page) - Ignore specific query parameters - Nur bestimmte Parameter ignorieren (gängige Tracking-Parameter wie
utm_source,fbclid,gclidwerden automatisch ignoriert)
Content Filtering (Inhaltsfilterung)
- Include element IDs - Inhalte nur aus bestimmten HTML-Elementen extrahieren (verwenden Sie
#idfür IDs,.classnamefür Klassen,[data-id="82874db"]für Elemente mit einem bestimmten Attribut, getrennt durch Semikolons) - Exclude element IDs - Inhalte aus bestimmten HTML-Elementen überspringen (z. B.
footer;header;#navigation;[data-nosnippet]) - Wenn Ein- oder Ausschlusselemente festgelegt sind, erscheinen bedingte Schalter, mit denen Sie steuern können, ob der Crawler Links folgt, die innerhalb dieser Elemente gefunden werden
Scraping Behavior (Scraping-Verhalten)
- Scrape documents - Auch Inhalte aus PDF-Dateien extrahieren, die auf der Website gefunden werden
- Exclude image links - Bild-URLs aus dem Trainingsdatensatz ausschließen
- Scrape hidden contents - Inhalte aus ausgeblendeten HTML-Elementen einbeziehen (standardmäßig aktiviert)
- Delay between pages - Eine Verzögerung in Sekunden zwischen Seitenaufrufen hinzufügen, um die Serverlast zu reduzieren
- Country code - Das Scraping über einen Proxyserver in einem bestimmten Land leiten (Ländercode aus zwei Buchstaben, z. B.
us)
E-Mail-Benachrichtigungen
Der Schalter Email me when training is finished or needs my attention (Mich per E-Mail benachrichtigen, wenn das Training abgeschlossen ist oder meine Aufmerksamkeit erfordert) ist standardmäßig aktiviert. Wenn er aktiv ist, erhalten Sie eine E-Mail-Benachrichtigung, wenn:
- Das Training erfolgreich abgeschlossen wurde
- Das System Ihre Eingabe benötigt (z. B. Auswahl von Seiten nach einem Scan)
- Während des Trainings Probleme auftreten
Sie können die E-Mail-Adresse für Benachrichtigungen im Feld neben dem Schalter ändern.
Trainingsfortschritt überwachen
Wechseln Sie nach dem Start eines Scans zum Tab Trainings, um den Fortschritt zu überwachen. Jeder Trainingsauftrag zeigt:
- Die Quell-URL
- Den aktuellen Status (Scanning links, Awaiting links selection, Training, Training completed)
- Einen Fortschrittsbalken während des aktiven Scannens oder Trainierens
- Das Datum der letzten Aktualisierung

Klicken Sie auf More details (Weitere Details), um alle für einen bestimmten Trainingsauftrag verwendeten Parameter zu sehen, einschließlich aller konfigurierten erweiterten Einstellungen.

Trainierte Links verwalten
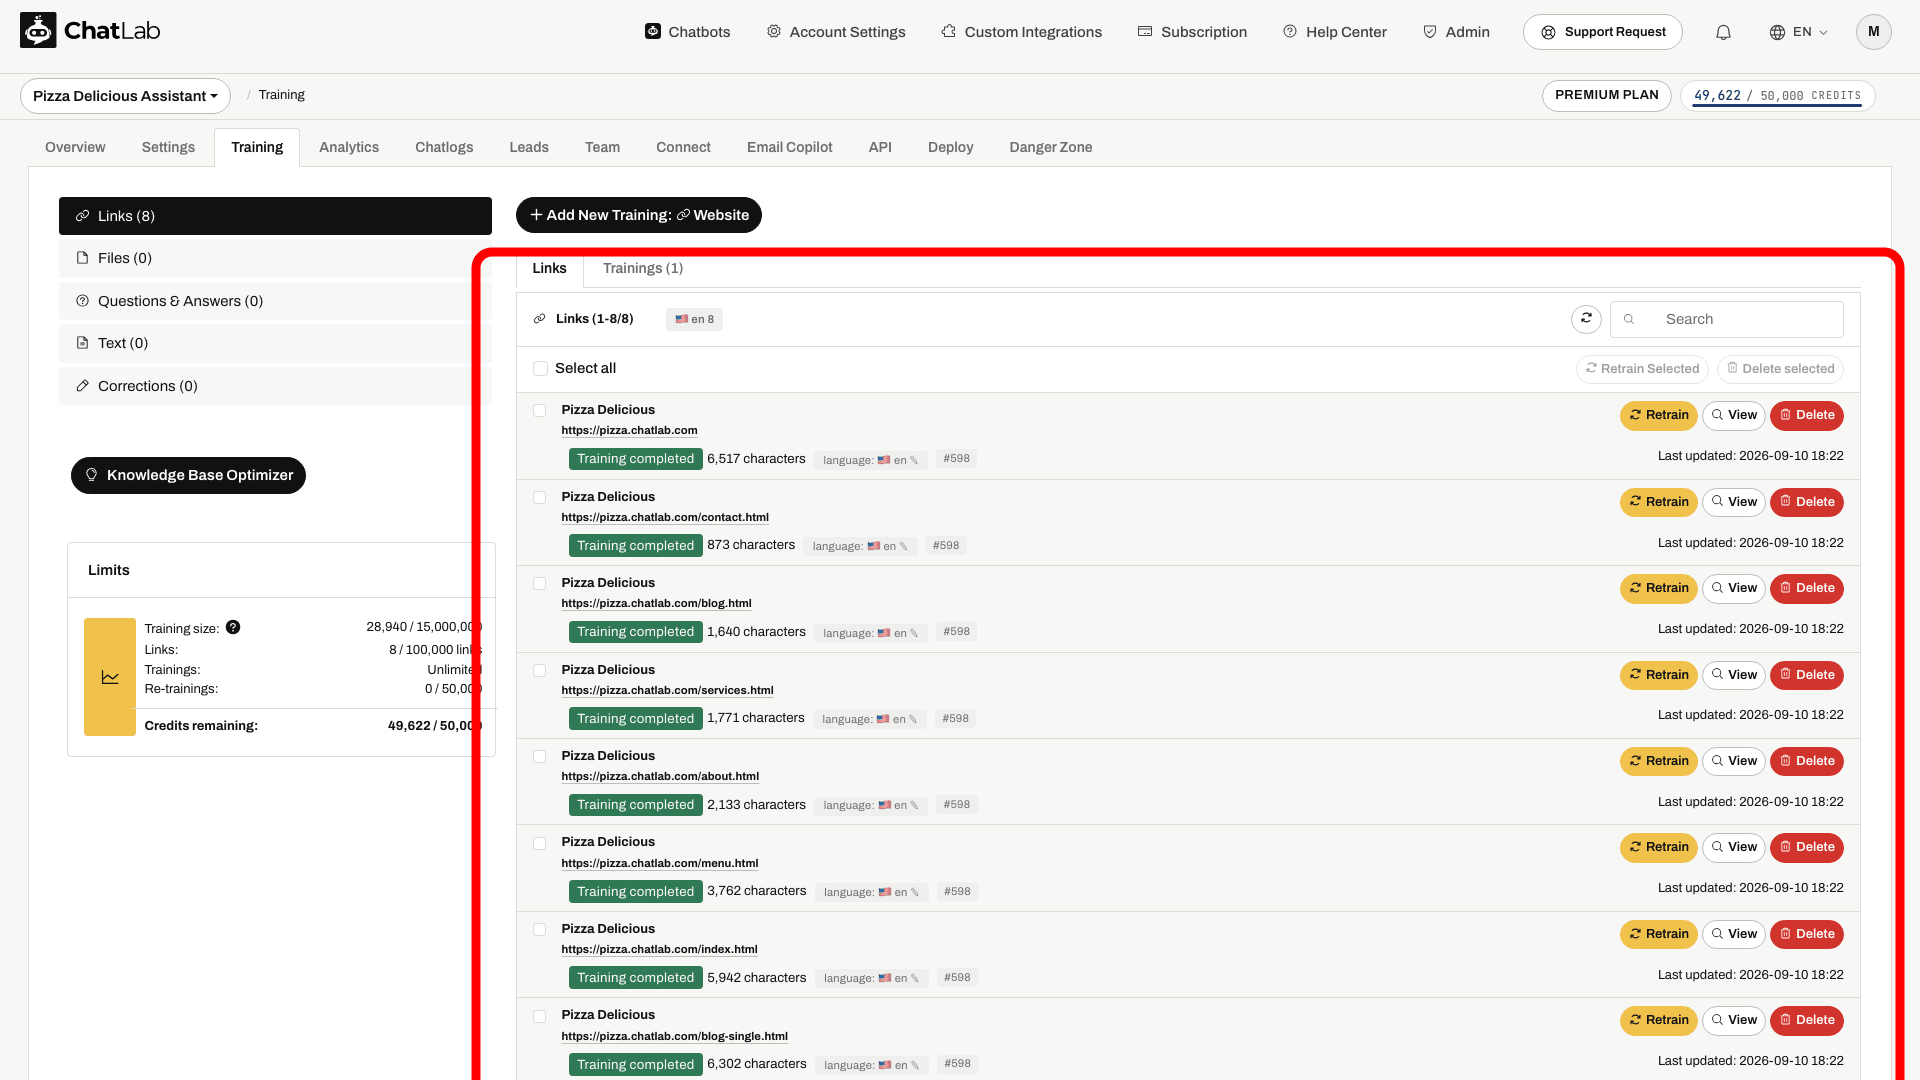
Nach Abschluss des Trainings erscheinen erfolgreich trainierte Seiten im Reiter Links. Seiten, die durch Ihre Einstellungen ausgeschlossen wurden, nicht ausgewählt blieben oder aufgrund eines Fehlers oder Limits abgelehnt wurden, werden nicht alle garantiert zu Trainingsquellen. Jeder Link zeigt Folgendes an:
- Seitentitel und URL
- Zeichenanzahl (Größe der Trainingsdaten)
- Trainingsstatus
- Datum der letzten Aktualisierung
Für jeden Link können Sie Folgendes tun:
- Retrain (Erneut trainieren) - Den Inhalt dieser bestimmten Seite erneut scannen und aktualisieren
- View (Anzeigen) - Den exakten Inhalt einsehen, der von der Seite extrahiert wurde
- Delete (Löschen) - Diese Seite aus der Wissensdatenbank Ihres Chatbots entfernen
Verwenden Sie das Kontrollkästchen Select all (Alle auswählen) und die Schaltflächen für Sammelaktionen, um mehrere Links gleichzeitig erneut zu trainieren oder zu löschen.
Gescannte Inhalte ansehen
Klicken Sie neben einem trainierten Link auf die Schaltfläche View, um genau zu sehen, welcher Inhalt von dieser Seite extrahiert wurde.

Das Quellansichts-Modal zeigt den Seitentitel, die URL, die Zeichenanzahl, das Datum der letzten Aktualisierung und den vollständigen Textinhalt, auf dem Ihr Chatbot trainiert wurde. Dies hilft Ihnen zu überprüfen, ob der richtige Inhalt erfasst wurde, und die Wissensdatenbank Ihres Chatbots besser zu verstehen.

Den fertigen Chatbot überprüfen
Das Scannen und Trainieren laufen im Hintergrund und können bei großen Websites einige Minuten oder länger dauern. Sie können diese Seite verlassen und in der Zwischenzeit das Website-Embed vorbereiten. Wenn der Vorgang den Status Awaiting links selection (Warten auf Link-Auswahl) anzeigt, kehren Sie zurück, um Seiten auszuwählen und das Training zu starten. Sobald das Training abgeschlossen ist, prüfen Sie wichtige Seiten über View (Anzeigen), öffnen Sie dann Overview (Übersicht) und testen Sie Fragen, deren Antworten sich auf diesen Seiten befinden. Überprüfen Sie Fehler und fehlende Seiten, bevor Sie sich auf die neuen Inhalte verlassen.
Verwandte Artikel
- Training im Hintergrund - Erfahren Sie, wie das Training im Hintergrund funktioniert
- Chatbot neu trainieren - So aktualisieren Sie Ihren Chatbot mit neuen Inhalten
- Trainingszeichen beim Scannen einer Website reduzieren - Tipps zur Optimierung der Größe Ihrer Trainingsdaten
- Chatbot trainieren: Grundlagen und Limits - Trainingsdatenlimits verstehen